
数据算法 --hadoop/spark数据处理技巧 --(7.共同好友 8. 使用MR实现推荐引擎)
七,共同好友。
在所有用户对中找出“共同好友”。
eg:
a b,c,d,g
b a,c,d,e
map()-》 <a,b>,<b,c,d,g> ;<a,c>,<b,c,d,g>;.....
<a,b>,<a,c,d,e>
reduce()-> <a,b>,<c,d> 也就是a,b的共同好友是c,d。
上述就是思想。
八,使用MR实现推荐引擎
1.购买过该商品的顾客还购买了哪些商品。
这里,利用MR的两次迭代实现CWBTIAB功能。
阶段1:生成同一个用户购买的所有商品列表。分组由HAdoop框架处理,其中映射器和规约器都会完成一个恒等函数。
阶段2:解决列表商品的共现问题。使用Stripes(条纹)设计模式,只发出5个最常见的商品。


2.经常一起购买的商品(FBT)
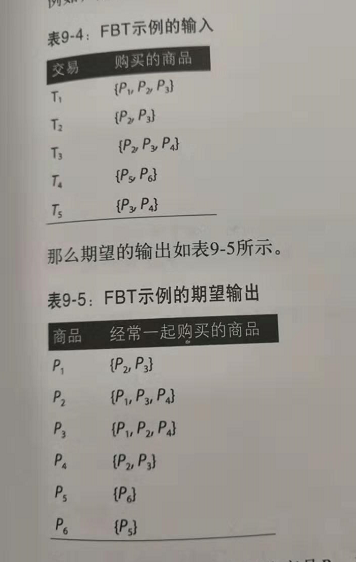
3.推荐连接
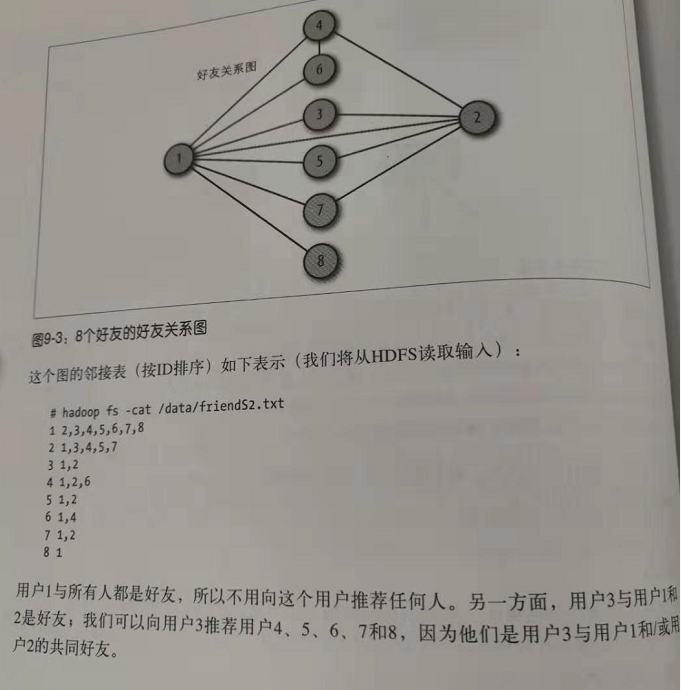
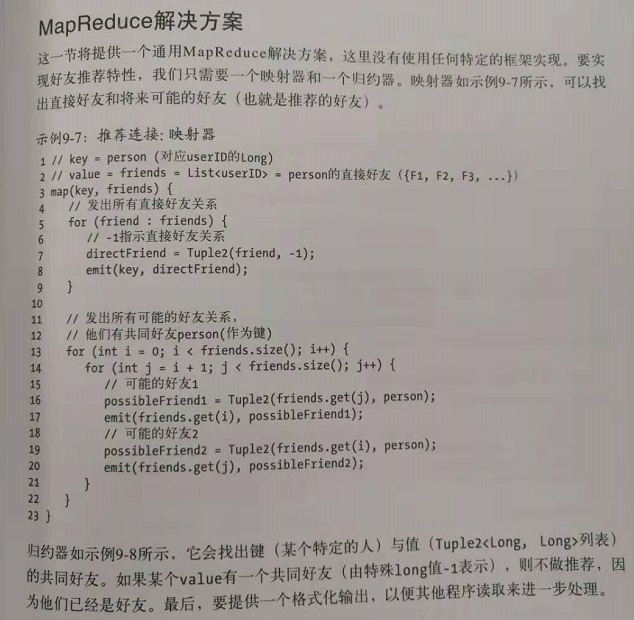
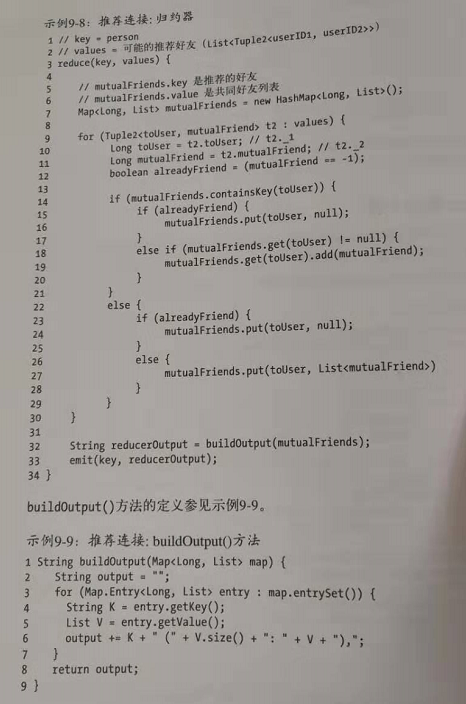
解决方案(实现思路):
数据算法 --hadoop/spark数据处理技巧 --(7.共同好友 8. 使用MR实现推荐引擎)的更多相关文章
- 数据算法 --hadoop/spark数据处理技巧 --(5.移动平均 6. 数据挖掘之购物篮分析MBA)
五.移动平均 多个连续周期的时间序列数据平均值(按相同时间间隔得到的观察值,如每小时一次或每天一次)称为移动平均.之所以称之为移动,是因为随着新的时间序列数据的到来,要不断重新计算这个平均值,由于会删 ...
- 数据算法 --hadoop/spark数据处理技巧 --(1.二次排序问题 2. TopN问题)
一.二次排序问题. MR/hadoop两种方案: 1.让reducer读取和缓存给个定键的所有值(例如,缓存到一个数组数据结构中,)然后对这些值完成一个reducer中排序.这种方法不具有可伸缩性,因 ...
- 数据算法 --hadoop/spark数据处理技巧 --(9.基于内容的电影推荐 10. 使用马尔科夫模型的智能邮件营销)
九.基于内容的电影推荐 在基于内容的推荐系统中,我们得到的关于内容的信息越多,算法就会越复杂(设计的变量更多),不过推荐也会更准确,更合理. 本次基于评分,提供一个3阶段的MR解决方案来实现电影推荐. ...
- 数据算法 --hadoop/spark数据处理技巧 --(3.左外连接 4.反转排序)
三. 左外连接 考虑一家公司,比如亚马逊,它拥有超过2亿的用户,每天要完成数亿次交易.假设我们有两类数据,用户和交易: users(user_id,location_id) transactions( ...
- 数据算法 --hadoop/spark数据处理技巧 --(17.小文件问题 18.MapReuce的大容量缓存)
十七.小文件问题 十八.MR的大容量缓存 在MR中使用和读取大容量缓存,(也就是说,可能包括数十亿键值对,而无法放在一个商用服务器的内存中).本次提出的算法通用,可以在任何MR范式中使用.(eg:MR ...
- 数据算法 --hadoop/spark数据处理技巧 --(11.K-均值聚类 12. k-近邻)
十一.k-均值聚类 这个需要MR迭代多次. 开始时,会选择K个点作为簇中心,这些点成为簇质心.可以选择很多方法啦初始化质心,其中一种方法是从n个点的样本中随机选择K个点.一旦选择了K个初始的簇质心,下 ...
- 数据算法 --hadoop/spark数据处理技巧 --(13.朴素贝叶斯 14.情感分析)
十三.朴素贝叶斯 朴素贝叶斯是一个线性分类器.处理数值数据时,最好使用聚类技术(eg:K均值)和k-近邻方法,不过对于名字.符号.电子邮件和文本的分类,则最好使用概率方法,朴素贝叶斯就可以.在某些情况 ...
- 数据算法 --hadoop/spark数据处理技巧 --(15.查找、统计和列出大图中的所有三角形 16.k-mer计数)
十五.查找.统计和列出大图中的所有三角形 第一步骤的mr: 第二部mr: 找出三角形 第三部:去重 spark: 十六: k-mer计数 spark:
- 哈,我自己翻译的小书,马上就完成了,是讲用python处理大数据框架hadoop,spark的
花了一些时间, 但感觉很值得. Big Data, MapReduce, Hadoop, and Spark with Python Master Big Data Analytics and Dat ...
随机推荐
- Java 基础(二)| 使用 lambad 表达式的正确姿势
前言 为跳槽面试做准备,今天开始进入 Java 基础的复习.希望基础不好的同学看完这篇文章,能掌握 lambda 表达式,而基础好的同学权当复习,希望看完这篇文章能够起一点你的青涩记忆. 一.什么是 ...
- 小程序中button标签的open-type属性
open-type (微信开放能力):合法值中的其中之一: getUserInfo 说明:引导用户授权 而获取用户信息,可以从bindgetuserinfo回调中获取到用户信息 而按钮的bi ...
- 最近发现Git的速度好慢
最近发现Git速度好慢,Git Bash要等5秒左右才能操作,网上查了查原因,说是火绒的问题,哎平时也用不到,看日志一个毒都没光顾过我电脑,火绒卸载! 卸了后果然快多了
- 获取当前URL
HttpContext.Current.Request.Url.ToString();
- transient简介
当一个对象实现了Serilizable接口,这个对象就可以被序列化,java的这种序列化模式为开发者提供了很多便利,我们可以不必关系具体序列化的过程,只要这个类实现了Serilizable接口,这个的 ...
- 本地缓存google.guava及分布式缓存redis 随笔
近期项目用到了缓存,我选用的是主流的google.guava作本地缓存,redis作分布式 缓存,先说说我对本地缓存和分布式缓存的理解吧,可能不太成熟的地方,大家指出,一起 学习.本地缓存的特点是速度 ...
- numpy 索引和切片
一.取行 1.单行 数组[index, :] # 取第index+1行 例子 import numpy as np arr1 = np.arange(0, 24).reshape(4, 6) # 取第 ...
- Windows 7原版映像中添加usb3.0驱动
最近用软碟通制作了一个win7原版映像,但是在装新系统的时候发现了一个问题,进入安装界面后,显示没有找到驱动器,但是明明是差了U盘的,通过“shift+f12”调出命令行窗口,输入disk list命 ...
- mysql 常用sql操作总结
批量修改表的引擎,从MyISAM修改为InnoDB 生成执行语句: select CONCAT('alter table ',table_name,' engine=InnoDB;') FROM in ...
- 文件上传二:FormData上传
介绍三种上传方式: 文件上传一:伪刷新上传 文件上传二:FormData上传 文件上传三:base64编码上传 Flash的方式也玩过,现在不推荐用了. 真正的异步上传,FormData的更多操作,请 ...