
通过Spark Streaming的foreachRDD把处理后的数据写入外部存储系统中
转载自:http://blog.csdn.net/erfucun/article/details/52312682
本博文主要内容包括:
- 技术实现foreachRDD与foreachPartition解析
- foreachRDD与foreachPartition实现实战
一:技术实现foreach解析:
1、首先我们看一下Output Operations on DStreams提供的API: 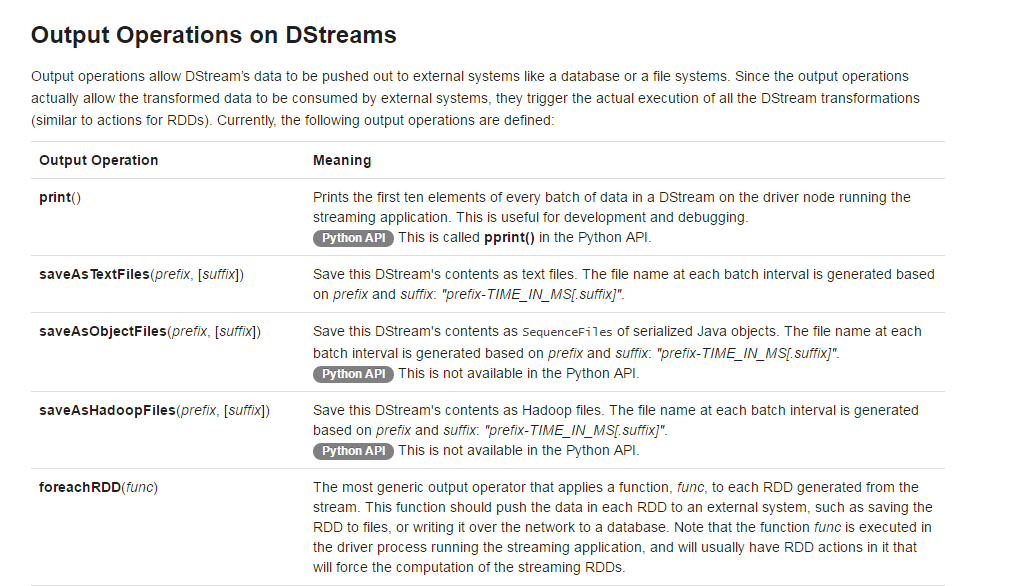
SparkStreaming的DStream提供了一个dstream.foreachRDD方法,该方法是一个功能强大的原始的API,它允许将数据发送到外部系统。然而,重要的是要了解如何正确有效地使用这种原始方法。一些常见的错误,以避免如下:
写数据到外部系统,需要建立一个数据连接对象(例如TCP连接到远程的服务器),使用它将数据发送到外部存储系统。为此开发者可能会在Driver中尝试创建一个连接,然后在worker中使用它来保存记录到外部数据。代码如下:
- dstream.foreachRDD { rdd =>
- val connection = createNewConnection() // executed at the driver
- rdd.foreach { record =>
- connection.send(record) // executed at the worker
- }}
上面的代码是一个错误的演示,因为连接是在Driver中创建的,而写数据是在worker中完成的。此时连接就需要被序列化然后发送到worker中。但是我们知道,连接的信息是不能被序列化和反序列化的(不同的机器连接服务器需要使用不同的服务器端口,即便连接被序列化了也不能使用)
进而我们可以将连接移动到worker中实现,代码如下:
- dstream.foreachRDD { rdd =>
- rdd.foreach { record =>
- val connection = createNewConnection()
- connection.send(record)
- connection.close()
- }}
但是此时,每处理一条数据记录,就需要连接一次外部系统,对于性能来说是个严重的问题。这也不是一个完美的实现。
Spark基于RDD进行编程,RDD的数据不能改变,如果擅长foreachPartition底层的数据可能改变,做到的方式foreachPartition操作一个数据结构,RDD里面一条条数据,但是一条条的记录是可以改变的spark也可以运行在动态数据源上。(就像数组的数据不变,但是指向的索引可以改变)
我们可以将代码做如下的改进:
- dstream.foreachRDD { rdd =>
- rdd.foreachPartition { partitionOfRecords =>
- val connection = createNewConnection()
- partitionOfRecords.foreach(record => connection.send(record))
- connection.close()
- }}
这样一个partition,只需连接一次外部存储。性能上有大幅度的提高。但是不同的partition之间不能复用连接。我们可以使用连接池的方式,使得partition之间可以共享连接。代码如下:
- stream.foreachRDD { rdd =>
- rdd.foreachPartition { partitionOfRecords =>
- // ConnectionPool is a static, lazily initialized pool of connections
- val connection = ConnectionPool.getConnection()
- partitionOfRecords.foreach(record => connection.send(record))
- ConnectionPool.returnConnection(connection) // return to the pool for future reuse
- }}
二:foreachRDD与foreachPartition实现实战
1、需要注意的是:
(1)、你最好使用forEachPartition函数来遍历RDD,并且在每台Work上面创建数据库的connection。
(2)、如果你的数据库并发受限,可以通过控制数据的分区来减少并发。
(3)、在插入MySQL的时候最好使用批量插入。
(4),确保你写入的数据库过程能够处理失败,因为你插入数据库的过程可能会经过网络,这可能导致数据插入数据库失败。
(5)、不建议将你的RDD数据写入到MySQL等关系型数据库中。
2、下面我们使用SparkStreaming实现将数据写到MySQL中:
(1)在pom.xml中加入如下依赖包
- <dependency>
- <groupId>mysql</groupId>
- <artifactId>mysql-connector-java</artifactId>
- <version>5.1.38</version>
- </dependency>
- <dependency>
- <groupId>commons-dbcp</groupId>
- <artifactId>commons-dbcp</artifactId>
- <version>1.4</version>
- </dependency>
(2)在MySql中创建数据库和表,命令操作如下:
- mysql -uroot -p
- create database spark;
- use spark;
- show tables;
- create table streaming_itemcount(keyword varchar(30));
使用Java编写一个数据库连接池类
- import java.sql.Connection;
- import java.sql.DriverManager;
- import java.util.LinkedList;
- /**
- * Created by zpf on 2016/8/26.
- */
- public class ConnectionPool {
- private static LinkedList<Connection> connectionQueue;
- static {
- try {
- Class.forName("com.mysql.jdbc.Driver");
- } catch (ClassNotFoundException e) {
- e.printStackTrace();
- }
- }
- public synchronized static Connection getConnection() {
- try {
- if (connectionQueue == null) {
- connectionQueue = new LinkedList<Connection>();
- for (int i = 0; i < 5; i++) {
- Connection conn = DriverManager.getConnection(
- "jdbc:mysql://Master:3306/sparkstreaming",
- "root",
- "12345");
- connectionQueue.push(conn);
- }
- }
- } catch (Exception e) {
- e.printStackTrace();
- }
- return connectionQueue.poll();
- }
- public static void returnConnection(Connection conn){
- connectionQueue.push(conn);
- }
- }
编写Spark代码:
- import org.apache.spark.SparkConf
- import org.apache.spark.streaming.{Seconds, StreamingContext}
- /**
- * Created by zpf on 2016/8/26.
- */
- object OnlineForeachRDD2DB {
- def main(args: Array[String]) {
- val conf = new SparkConf().setAppName("OnlineForeachRDD2DB").setMaster("local[2]")
- val ssc = new StreamingContext(conf, Seconds(5))
- val lines = ssc.socketTextStream("Master", 9999)
- val words = lines.flatMap(_.split(" "))
- val wordCounts = words.map(x => (x, 1)).reduceByKey(_ + _)
- wordCounts.foreachRDD { rdd =>
- rdd.foreachPartition { partitionOfRecords => {
- val connection = ConnectionPool.getConnection()
- partitionOfRecords.foreach(record => {
- val sql = "insert into streaming_itemcount(item,count) values('" + record._1 + "'," + record._2 + ")"
- val stmt = connection.createStatement
- stmt.executeUpdate(sql)
- })
- ConnectionPool.returnConnection(connection)
- }
- }
- }
- }
- }
打开netcat发送数据
- root@spark-master:~# nc -lk 9999
- spark hadoop kafka spark hadoop kafka spark hadoop kafka spark hadoop
打包运行spark代码
- /usr/local/spark/bin/spark-submit --driver-class-path /usr/local/spark/lib/mysql-connector-java-5.1.35-bin.jar /root/Documents/SparkApps/SparkStreamApps.jar
查看数据库中的结果:
博文内容源自DT大数据梦工厂Spark课程总结的笔记相关课程内容视频可以参考: 百度网盘链接:http://pan.baidu.com/s/1slvODe1(如果链接失效或需要后续的更多资源,请联系QQ460507491或者微信号:DT1219477246 获取上述资料)。
通过Spark Streaming的foreachRDD把处理后的数据写入外部存储系统中的更多相关文章
- spark streaming从指定offset处消费Kafka数据
spark streaming从指定offset处消费Kafka数据 -- : 770人阅读 评论() 收藏 举报 分类: spark() 原文地址:http://blog.csdn.net/high ...
- Spark Streaming揭秘 Day10 从BlockGenerator看接收数据的生命周期
Spark Streaming揭秘 Day10 从BlockGenerator看接收数据的生命周期 昨天主要介绍了SparkStreaming中对于Receiver的生命周期管理,下面让我们进入到Re ...
- Spark Streaming和Kafka整合是如何保证数据零丢失
转载:https://www.iteblog.com/archives/1591.html 当我们正确地部署好Spark Streaming,我们就可以使用Spark Streaming提供的零数据丢 ...
- spark读取mongodb数据写入hive表中
一 环境: spark-: hive-; scala-; hadoop--cdh-; jdk-1.8; mongodb-2.4.10; 二.数据情况: MongoDB数据格式{ "_i ...
- 数据清洗:按照进行数据清洗,并将清洗后的数据导入hive数据库中。
虚拟机: hadoop:3.2.0 hive:3.1.2 win10: eclipse 两阶段数据清洗: (1)第一阶段:把需要的信息从原始日志中提取出来 ip: 199.30.25.88 ti ...
- 大数据技术之_19_Spark学习_04_Spark Streaming 应用解析 + Spark Streaming 概述、运行、解析 + DStream 的输入、转换、输出 + 优化
第1章 Spark Streaming 概述1.1 什么是 Spark Streaming1.2 为什么要学习 Spark Streaming1.3 Spark 与 Storm 的对比第2章 运行 S ...
- Spark学习(4) Spark Streaming
什么是Spark Streaming Spark Streaming类似于Apache Storm,用于流式数据的处理 Spark Streaming有高吞吐量和容错能力强等特点.Spark Stre ...
- Spark学习笔记——Spark Streaming
许多应用需要即时处理收到的数据,例如用来实时追踪页面访问统计的应用.训练机器学习模型的应用, 还有自动检测异常的应用.Spark Streaming 是 Spark 为这些应用而设计的模型.它允许用户 ...
- Spark学习之Spark Streaming
一.简介 许多应用需要即时处理收到的数据,例如用来实时追踪页面访问统计的应用.训练机器学习模型的应用,还有自动检测异常的应用.Spark Streaming 是 Spark 为这些应用而设计的模型.它 ...
随机推荐
- js 判断变量是否为空或未定义
判断变量是否定义: if(typeof(hao) == "undefined"){ //未定义 }else{ //定义 } 判断变量是否为空或NULL,是则返回'', 反之返回原对 ...
- OpenGL创建一个三角形,并且颜色渐变(绿—>黑—>绿)
学习自: https://learnopengl-cn.github.io/01%20Getting%20started/05%20Shaders/#_4 #include <glad/glad ...
- makefile笔记6 - makefile条件判断
使用条件判断,可以让 make 根据运行时的不同情况选择不同的执行分支.条件表达式可以是比较变量的值,或是变量和常量的值. 一.示例 下面的例子,判断\(\$\)(CC)变量是否"gcc&q ...
- 转换流 InputStreamReader
通常接触到字节流和字符流,但是有一个流是这两个流的桥梁,inputStreamReader 字符流的结构如下 可以看到inputStreamReader是继承Reader ,它的子类是FileRead ...
- Python中常见的序列及其函数
分片:分片操作的实现需要提供两个索引作为边界,第一个包含在分片内,第二个不包含 number =[1,2,3,4,5,6,7,8,9,10] number [3:6] -->[4,5,6] n ...
- JavaScript中常用的BOM对象(属性、方法)
window对象 定义: 一个浏览器窗口实例 与窗口有关的信息(应用程序编程接口) ECMAScript规定的Global对象 方法 open(url),返回标识符 引用 即将打开窗口的.(调用该引用 ...
- python 类的定义 实例化 实例完后初始化
先来看看 类的__init__, 类的__new__ , 元类的__new__的执行顺序 class TMetaclass(type): def __new__(cls,name,bases,attr ...
- Django的forms表单组件批量设置字段样式
from django import forms from . import models class UserInfoModelForms(forms.ModelForm): class Meta: ...
- XMind 8 pro update 7激活方法
激活过程 0.下载XMindCracker.(自行百度下载)1.断网,使用修改hosts方法,在最后一行添加0.0.0.0 www.xmind.net2.将XMindCrack.jar拷贝到XMind ...
- Window 下载Android系统源代码
第一步:使用命令下载manifest文件夹 git clone https://aosp.tuna.tsinghua.edu.cn/ 第二步:进入文件夹,打开default.xml文件并找到自己要下载 ...