
MapReduce的工作原理
MapReduce简介
MapReduce有哪些角色?各自的作用是什么?
MapReduce程序执行流程
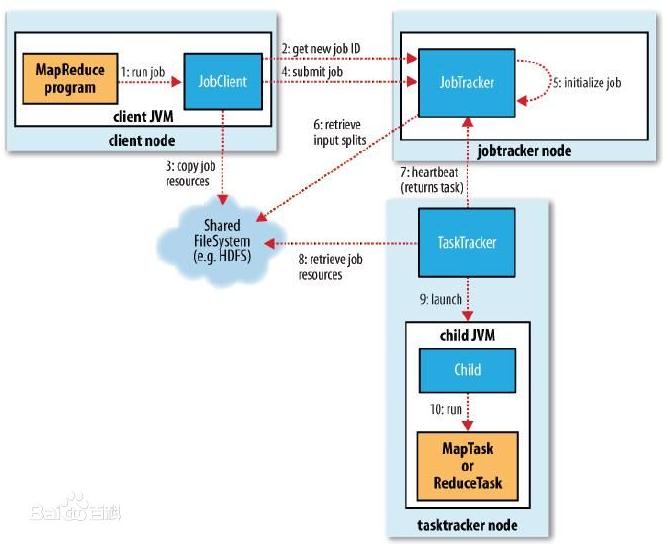
MapReduce工作原理
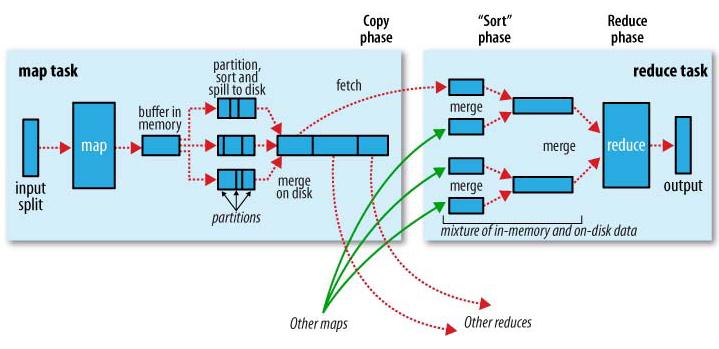
reduce task
MapReduce中Shuffle过程


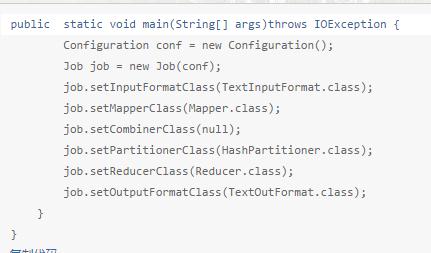
MapReduce编程主要组件
针对MapReduce的缺点,YARN解决了什么?
MapReduce的工作原理的更多相关文章
- Hadoop 4、Hadoop MapReduce的工作原理
一.MapReduce的概念 MapReduce是hadoop的核心组件之一,hadoop要分布式包括两部分,一是分布式文件系统hdfs,一部是分布式计算框就是mapreduce,两者缺一不可,也就是 ...
- Hadoop基础-MapReduce的工作原理第二弹
Hadoop基础-MapReduce的工作原理第二弹 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Split(切片) 1>.MapReduce处理的单位(切片) 想必 ...
- Hadoop基础-MapReduce的工作原理第一弹
Hadoop基础-MapReduce的工作原理第一弹 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 在本篇博客中,我们将深入学习Hadoop中的MapReduce工作机制,这些知识 ...
- MapReduce 1工作原理图文详解
MapReduce工作原理图文详解 一 MapReduce程序执行流程 程序执行流程图如下: 流程分析:1.在客户端启动一个作业.2.向JobTracker请求一个Job ID.3.将运行作业所需要的 ...
- 【hadoop】细读MapReduce的工作原理
前言:中秋节有事外加休息了一天,今天晚上重新拾起Hadoop,但感觉自己有点烦躁,不知后续怎么选择学习Hadoop的方法. 干脆打开电脑,决定: 1.先将Hadoop的MapReduce和Yarn基本 ...
- MapReduce工作原理图文详解
目录:1.MapReduce作业运行流程2.Map.Reduce任务中Shuffle和排序的过程 1.MapReduce作业运行流程 流程示意图: 流程分析: 1.在客户端启动一个作业. 2.向Job ...
- <转>MapReduce工作原理图文详解
转自 http://weixiaolu.iteye.com/blog/1474172前言: 前段时间我们云计算团队一起学习了hadoop相关的知识,大家都积极地做了.学了很多东西,收获颇丰.可是开学 ...
- MapReduce工作原理讲解
第一部分:MapReduce工作原理 MapReduce 角色•Client :作业提交发起者.•JobTracker: 初始化作业,分配作业,与TaskTracker通信,协调整个作业.•TaskT ...
- MapReduce工作原理
第一部分:MapReduce工作原理 MapReduce 角色•Client :作业提交发起者.•JobTracker: 初始化作业,分配作业,与TaskTracker通信,协调整个作业.•Tas ...
随机推荐
- 管理外部表(External Tables)
Oracle数据库允许对外部表中的数据进行只读访问.外部表定义为不驻留在数据库中的表,并且可以是为其提供访问驱动程序的任何格式.通过为数据库提供描述外部表的元数据,数据库能够公开外部表中的数据,就好像 ...
- 基于Python的Webservice开发(二)-如何用Spyne开发Webservice
一.功能需求 本次案例是开发一个Item的新建的WebService.IN&OUT的类型JsonDocument. 通过传入相关的参数创建Item,且相关的参数可以被缺省. 二.实现代码 引入 ...
- appniu踩坑
1.pyCharm识别不到appnium-python-client 解决:新建项目注意选择环境,查看Project Interpreter中是否识别到了appnium-python-client 还 ...
- mac配置变量失败导致ls命令都失效
1.在命令行中输入 export PATH=/usr/bin:/usr/sbin:/bin:/sbin:/usr/X11R6/bin 这样可以保证命令行命令暂时可以使用.命令执行完之后先不要关闭终端 ...
- 01pxc集群的部署
尽可能的控制pxc集群的规模,pxc集群节点越多,数据同步的速度就越慢 所有pxc节点的硬件配置最好相同,pxc集群数据同步的速度取决于配置最低的节点 Pxc集群只支持innodb引擎 安装pxc集群 ...
- java 数组排序 插入排序法
插入排序法思想:将n个数字分为前面几个是有序数字集合,后面几个为无序集合.当然尚未排序之前,可以将n0 看为有序数集合,N1-Nn-1 看为等待排序的无序集合.从N1开始将无序数一个一个插入到有序数集 ...
- CF1029A Many Equal Substrings
题目描述 你有一个字符串t,它由n个字母组成. 定义一个字符串s的子串为s[l...r],表示从位置l到r构成的一个新的串. 你的目标是构造一个字符串s,使得它的可能长度最小,要求s中存在k个位置i, ...
- LoadRunner监控数据库服务
一.LR监控SQL Server SQL Server自身提供的性能计数器指标有: 指标名称 指标描述 指标范围 指标单位 1.SQL Server中访问方法(Access Methods)对象包含的 ...
- C#获取指定的文件是否是内部特殊版本的代码
把内容过程经常用到的内容片段珍藏起来,下面的内容内容是关于C#获取指定的文件是否是内部特殊版本的内容,希望对各朋友有所用处. using System;using System.Diagnostics ...
- Spring 将请求参数封装成对象
简单描述:最近手里的模块,前后台之间需要传递很多的参数,使用封装的PageData,来获取请求参数的,作微服务迁移的时候,就涉及到需要把参数从pagedata里取出来,一个一个的放到对象的属性中.就很 ...