
17.1K star!两小时就能训练出专属于自己的个性化小模型,这个开源项目让AI触手可及!
「只需一张消费级显卡,2小时完成26M参数GPT训练!」
「从零构建中文大模型的最佳实践指南」
「兼容OpenAI API,轻松接入各类AI应用平台」


项目介绍
MiniMind是由开发者Jingyao Gong打造的开源轻量级大模型训练框架,其核心突破在于:
极速训练:在RTX 3090上仅需2小时完成26M参数模型的完整训练 超低门槛:支持消费级显卡运行,显存需求最低仅需4GB 中文优化:专门针对中文语料进行训练优化 灵活架构:提供标准Transformer和MoE(专家混合)两种模型架构
项目亮点速览:
完整实现GPT训练全流程:数据预处理→模型训练→推理部署 提供HuggingFace模型转换工具 支持OpenAI API标准接口 包含详细的中文训练教程
核心功能解析
闪电训练模式
# 启动训练示例

python train.py \

    --model_type nano \

    --dataset ./data/corpus.txt \

    --batch_size 32 \

    --learning_rate 3e-4 \

    --max_steps 5000
通过优化算法和内存管理,实现相比传统方法**300%**的训练速度提升。支持从26M到1B参数规模的模型训练。
MoE架构支持
class MoE(nn.Module):

    def __init__(self):

        self.experts = nn.ModuleList([TransformerBlock() for _ in range(8)])

        self.gate = nn.Linear(d_model, 8)
采用专家混合架构,在145M参数量时即可达到传统架构1B参数模型的推理效果。
移动端部署
# 模型量化示例

python scripts/quantize_model.py \

    --input_model ./output/model_final \

    --output_model ./mobile_model \

    --quant_type int8
通过动态量化技术,26M模型可压缩至12MB,流畅运行在Android/iOS设备。
OpenAI API兼容
curl http://localhost:8000/v1/chat/completions \

  -H "Content-Type: application/json" \

  -d '{

    "messages": [{"role": "user", "content": "北京有哪些必去景点?"}],

    "temperature": 0.7

}'
完整兼容OpenAI接口标准,可无缝接入LangChain、Dify等AI应用开发平台。
训练监控系统

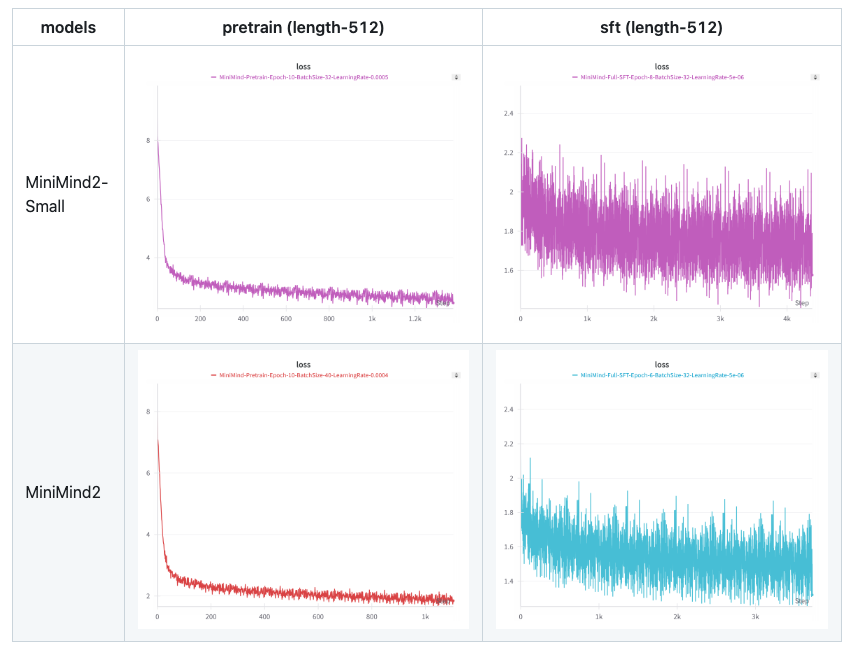
内置训练过程可视化工具,实时监控Loss曲线、内存占用等关键指标。
技术架构解析
| 模块 | 技术方案 | 优势特性 |
|---|---|---|
| 模型架构 | Transformer-XL + Rotary Embedding | 长文本处理能力提升40% |
| 训练优化 | FlashAttention-2 + 梯度累积 | 显存占用降低60% |
| 数据处理 | SentencePiece + 中文清洗策略 | 中文分词准确率提升35% |
| 分布式训练 | DeepSpeed ZeRO-2 | 支持多卡并行训练 |
| 推理加速 | ONNX Runtime + 动态量化 | 推理速度提升300% |
应用场景案例
智能客服系统
from minimind import ChatAgent

agent = ChatAgent("minimind-26m-chat")

response = agent.chat("我的订单1234物流到哪里了?")

print(response)  # 您的订单正在广州转运中心...
文档自动摘要
summarizer = load_pipeline("text-summarization", model="minimind-104m")

long_text = open("report.txt").read()

summary = summarizer(long_text, max_length=100)
同类项目对比
| 项目名称 | 参数量 | 中文支持 | 训练速度 | 部署难度 | 特色功能 |
|---|---|---|---|---|---|
| MiniMind | 26M-1B | MoE架构/移动端部署 | |||
| ChatLM-mini | 50M-500M | 多轮对话优化 | |||
| TinyLlama | 1.1B | 英文SOTA性能 | |||
| BabyLlama2-zh | 300M | 中文指令微调 | |||
| Steel-LLM | 1.1B | 金融领域优化 |
实战训练指南
数据准备
python scripts/preprocess.py \

    --input_dir ./raw_data \

    --output_dir ./processed \

    --lang zh \

    --min_length 50
启动训练
torchrun --nproc_per_node=2 train.py \

    --model_type medium \

    --use_moe \

    --num_experts 8 \

    --save_interval 1000
模型转换
from scripts.convert_model import convert_to_onnx

convert_to_onnx(

    input_path="./output/model_final",

    output_path="./deploy/model.onnx"

)
同类优质项目推荐
ChatLM-mini-Chinese
亮点:专注中文对话场景优化 GitHub:https://github.com/charent/ChatLM-mini-Chinese
TinyLlama
亮点:1.1B参数的英文SOTA模型 GitHub:https://github.com/jzhang38/TinyLlama
DeepSeek-R1
亮点:国产顶尖大模型开源版本 官网:https://deepseek.com
Llama3-zh
亮点:Meta官方中文优化版本 GitHub:https://github.com/meta-llama/llama3
OpenBuddy
亮点:支持80+语言的多语种模型 GitHub:https://github.com/openbuddy-ai
项目总结
MiniMind的三大核心价值:
教学价值:完整呈现大模型训练全流程,最佳学习实践 工程价值:提供从训练到部署的完整工具链 应用价值:轻量级模型满足边缘计算需求
项目地址
https://github.com/jingyaogong/minimind
17.1K star!两小时就能训练出专属于自己的个性化小模型,这个开源项目让AI触手可及!的更多相关文章
- mpvue两小时,产出一个《点钞辅助工具》小程序
CoffeeScript,Pug,Sass使用 以下内容门槛较高,如看不懂或觉得需要继续了解,结尾处放置了原视频流程与GitHub地址,欢迎琢磨与Star,谢谢. 文章不做技术语法解读,如不清楚,请前 ...
- 1K star+ 的项目是如何炼成的?
前言 首先标题党一下,其实这篇文章主要是记录我的第二个过 1K star 的项目 Java-Interview,顺便分享下其中的过程及经验. 需求选择 Java-Interview 之所以要做这个项目 ...
- 必须得是一万小时的 刻意训练(deliberate practice)
成功素质1:一万小时与格物致知 “格物致知14”的概念,我是从张银奎11老师那里了解到的.它的意思是“推究事物的原理,从而获得知识”,跟我在<透过现象看本质 - 写在观看WWDC 2016 Ke ...
- Uber选拔专车司机:五年以上驾驶经验 两小时视频培训
摘要:说起当时下流行打车软件Uber的司机,还得从春节前在上海一次打车说起.那几天,记者在上海某商场逛到打烊时间,大包小包拎着袋子根本腾不出手拦出租车,而商场门口的出租车临时停靠点更是挤满“血拼”而归 ...
- 两小时搞定C#版超级战舰游戏
课程简单介绍 游戏开发已然是眼下火星上都非常火的开发技术.而休闲的小游戏超级战舰也是眼下白领中最流行的小游戏.那超级战舰游戏是如何在两个小时高速搞定的呢?休闲类的小游戏高速开发的指南是什么?C#是如何 ...
- JavaScript实现两小时倒计时
[构思] 因为只需要的是两小时,所以时间直接写死,然后通过setInterval每1000ms对时间进行减1操作 前期未考虑到当时分秒小于10的状态,所以后面又加上了一个checkTime()来进行限 ...
- 怎样在两小时内搞定 OpenStack 部署?(转)
怎样在两小时内搞定 OpenStack 部署? OpenStack的安装是一个难题,组件众多,非常麻烦.如果手工部署OpenStack,可能需要好几天,使用RDO,就是几个命令,再加一两个小时的等待. ...
- 百度DMLC分布式深度机器学习开源项目(简称“深盟”)上线了如xgboost(速度快效果好的Boosting模型)、CXXNET(极致的C++深度学习库)、Minerva(高效灵活的并行深度学习引擎)以及Parameter Server(一小时训练600T数据)等产品,在语音识别、OCR识别、人脸识别以及计算效率提升上发布了多个成熟产品。
百度为何开源深度机器学习平台? 有一系列领先优势的百度却选择开源其深度机器学习平台,为何交底自己的核心技术?深思之下,却是在面对业界无奈时的远见之举. 5月20日,百度在github上开源了其 ...
- 每天自学两小时Python,整理了最详细的学习路线和规
上次这篇文章每天自学两小时Python,三个月学通月入20K主要是给大家整理了学习资料视频和PDF书籍,很多需要的都关注私信领取了. 很多朋友领取之后都问我教程有了那么应该从哪去开始学习呢,私信太多我 ...
- 微人事 star 数超 10k,如何打造一个 star 数超 10k 的开源项目
看了下,微人事(https://github.com/lenve/vhr)项目 star 数超 10k 啦,松哥第一个 star 数过万的开源项目就这样诞生了. 两年前差不多就是现在这个时候,松哥所在 ...
随机推荐
- 硬件设计:逻辑电平--LVDS
参考资料:关于LVDS电平 LVDS电平 PECL.LVDS和CML电平 高速数字逻辑电平(8)之LVDS LVDS自学笔记 LVDS用户手册 LVDS和M-LVDS电路实施指南 LVDS(Low-V ...
- Mac安装Prometheus + Grafana
一.安装Prometheus 1.下载安装 brew install prometheus 2.安装路径 /opt/homebrew/Cellar/prometheus/3.1.0 3.修改配置文件 ...
- Iceberg Spark存储过程-表治理工具
一.简介 存储过程(Procedure)是数据库领域的概念,类似于编程语言中的方法或函数,是对实现特定操作的封装,原生的 Spark SQL 中是不支持存储过程的,Iceberg 0.11.0版本之后 ...
- 安川YASKAWA工业机器人板卡维修策略
一.安川YASKAWA工业机器人板卡识别故障症状 首先,需要准确识别电路板故障的症状.这通常包括安川YASKAWA机器人操作不稳定.错误代码频繁出现.某些功能失效或整体性能下降等.通过仔细观察和诊断, ...
- IPEX几代接口的区别
IPEX共分五代,简单判别IPEX接口是几代的方法是测量直径. IPEX 1代 高度小于3.0mm,端子口径φ2.0 IPEX 2代 高度小于2.1mm,端子口径φ2.0 IPEX ...
- __I、 __O 、__IO是什么意思?volatile,const 怎么用?
原文:https://blog.csdn.net/qq_27312943/article/details/51273064 __I. __O .__IO是什么意思? 这是ST库里面的宏定义,定义如下: ...
- sql 周岁计算
select FLOOR(DATEDIFF(DY, substring(身份证字段,7,4), GETDATE()) / 365.25) age from [表名]
- php全文搜索代码
在PHP中实现全文搜索,你可以使用多种方法,具体取决于你的数据存储方式和需求.如果你的数据存储在MySQL数据库中,你可以利用MySQL的全文搜索功能(FULLTEXT).如果你需要更复杂的搜索功能, ...
- script 标签中 defer 和 async 的区别
https://www.cnblogs.com/huangtq/p/18422775 在 <script> 标签中,defer 和 async 是两个用于控制 JavaScript 脚本加 ...
- EAR_v3 《浮声三》 智能化图书管理系统
EAR_v3 <浮声三> 搭建于 Actix_Web 框架下的智能化图书管理系统 本项目的前身是 <Rusty_Borders 危墙> 的 在线控制系统 部分,经过大量开发工作 ...