
数据结构之最小生成树Kruskal算法
1. 克鲁斯卡算法介绍
克鲁斯卡尔(Kruskal)算法,是用来求加权连通图的最小生成树的算法。
基本思想:按照权值从小到大的顺序选择n-1条边,并保证这n-1条边不构成回路。
具体做法:首先构造一个只含n个顶点的森林,然后依权值从小到大从连通网中选择边加入到森林中,并使森林中不产生回路,直至森林变成一棵树为止。
2. 克鲁斯卡算法图解

第1步:将边<E,F>加入R中。
边<E,F>的权值最小,因此将它加入到最小生成树结果R中。
第2步:将边<C,D>加入R中。
上一步操作之后,边<C,D>的权值最小,因此将它加入到最小生成树结果R中。
第3步:将边<D,E>加入R中。
上一步操作之后,边<D,E>的权值最小,因此将它加入到最小生成树结果R中。
第4步:将边<B,F>加入R中。
上一步操作之后,边<C,E>的权值最小,但<C,E>会和已有的边构成回路;因此,跳过边<C,E>。同理,跳过边<C,F>。将边<B,F>加入到最小生成树结果R中。
第5步:将边<E,G>加入R中。
上一步操作之后,边<E,G>的权值最小,因此将它加入到最小生成树结果R中。
第6步:将边<A,B>加入R中。
上一步操作之后,边<F,G>的权值最小,但<F,G>会和已有的边构成回路;因此,跳过边<F,G>。同理,跳过边<B,C>。将边<A,B>加入到最小生成树结果R中。
此时,最小生成树构造完成!它包括的边依次是:<E,F> <C,D> <D,E> <B,F> <E,G> <A,B>。
3. 代码实现
(1)根据图链表顶点信息得到所有边信息
EData* listUDG::GetEdage()

{

    EData *pEdata = new EData[m_nEdgNum];

    ENode *pTemp = NULL;

    int nEdgNum = ;

    for (int i = ; i < m_nVexNum; i ++)

    {

        pTemp = m_mVexs[i].pFirstEdge;

        while(pTemp != NULL)

        {

            if (pTemp->nVindex > i) // 可以不需要改代码,但是为了严谨和效率

            {

                pEdata[nEdgNum].nStart = m_mVexs[i].data;

                pEdata[nEdgNum].nEnd = m_mVexs[pTemp->nVindex].data;

                pEdata[nEdgNum].nWeight = pTemp->nWeight;

                nEdgNum ++;

            }

            pTemp = pTemp->pNext;

        }

    }

    return pEdata;

}
(2)对所有边根据权重值大小进行排序
void listUDG::SortEdges(EData* edges, int elen)

{

    int i,j;

    for (i=; i<elen; i++)

    {

        for (j=i+; j<elen; j++)

        {

            if (edges[i].nWeight > edges[j].nWeight)

            {

                // 交换"边i"和"边j"

                swap(edges[i], edges[j]);

            }

        }

    }

}
(3)判断选取的边是否构成回路
若0->1->2->3->4 5->3
则a[0]=1;a[1]=2;a[2]=3;a[3]=4;
a[5]=3;
因为a[5]和a[2]的尾顶点都是3,则构成回路
int listUDG::GetEnd(int *vends, int i)

{

    while(vends[i] != )

    {

        i = vends[i];

    }

    return i;

}
(4)Kruskal算法
// kruska最小生成树

void listUDG::Kruskal()

{

    // 得到所有的边

    EData *pEdata = GetEdage();

    // 根据边的权重进行排序

    SortEdges(pEdata,m_nEdgNum);

    int vends[MAX] = {};     // 用于保存"已有最小生成树"中每个顶点在该最小树中的终点。

    EData rets[MAX];      // 结果数组,保存kruskal最小生成树的边

    int nStartIndex,nEndIndex;

    int nIndex = ;

    int m,n;

    for (int i = ; i < m_nEdgNum; i ++)

    {

        nStartIndex = GetVIndex(pEdata[i].nStart);

        nEndIndex = GetVIndex(pEdata[i].nEnd);

        m = GetEnd(vends, nStartIndex);

        n = GetEnd(vends, nEndIndex);

        if (m != n)

        {

            vends[m] = n;                // 设置m在"已有的最小生成树"中的终点为n

            rets[nIndex++] = pEdata[i];           // 保存结果

        }

    }

    delete[] pEdata;

    int nSum = ;

    for (int i = ; i < nIndex; i++)

        nSum += rets[i].nWeight;

    cout << "Kruskal=" << nSum << ": ";

    for (int i = ; i < nIndex; i++)

        cout << "(" << rets[i].nStart << "," << rets[i].nEnd << ") ";

    cout << endl;

}
(5)全部代码
#include "stdio.h"

#include <iostream>

using namespace std;

#define MAX 100

#define INF         (~(0x1<<31))        // 最大值(即0X7FFFFFFF)

class EData

{

public:

    EData(){}

    EData(char start, char end, int weight) : nStart(start), nEnd(end), nWeight(weight){}

    char nStart;

    char nEnd;

    int nWeight;

};

// 边

struct ENode

{

    int nVindex;  // 该边所指的顶点的位置

    int nWeight;  // 边的权重

    ENode *pNext; // 指向下一个边的指针

};

struct VNode

{

    char data;  // 顶点信息

    ENode *pFirstEdge; // 指向第一条依附该顶点的边

};

// 无向邻接表

class listUDG

{

public:

    listUDG();

    listUDG(char *vexs, int vlen, EData **pEData, int elen);

    ~listUDG();

    void PrintUDG();

    // Prim最小生成树

    void Prim(int nStart);

    // 得到所有的边

    EData* GetEdage();

    // kruska最小生成树

    void Kruskal();

private:

    // 获取<start, end>的权值,若start和end不是连接的,则返回无穷大

    int GetWeight(int start, int end);

    // 返回顶点的索引

    int GetVIndex(char ch);

    void LinkLast(ENode *pFirstNode, ENode *pNode);

    void QuickSort(EData* pEdata, int nEdgNum);

    void SortEdges(EData* edges, int elen);

    int GetEnd(int *vends, int i);

private:

    int m_nVexNum;   // 顶点数目

    int m_nEdgNum;   // 边数目

    VNode m_mVexs[MAX];

    VNode m_PrimVexs[MAX];

};

listUDG::listUDG()

{

}

listUDG::listUDG(char *vexs, int vlen, EData **pEData, int elen)

{

    m_nVexNum = vlen;

    m_nEdgNum = elen;

    // 初始化"邻接表"的顶点

    for (int i = ; i < vlen; i ++)

    {

        m_mVexs[i].data = vexs[i];

        m_mVexs[i].pFirstEdge = NULL;

    }

    char c1,c2;

    int p1,p2;

    ENode *node1, *node2;

    // 初始化"邻接表"的边

    for (int j = ; j < elen; j ++)

    {

        // 读取边的起始顶点和结束顶点

        c1 = pEData[j]->nStart;

        c2 = pEData[j]->nEnd;

        p1 = GetVIndex(c1);

        p2 = GetVIndex(c2);

        node1 = new ENode();

        node1->nVindex = p2;

        node1->nWeight = pEData[j]->nWeight;

        if (m_mVexs[p1].pFirstEdge == NULL)

        {

            m_mVexs[p1].pFirstEdge = node1;

        }

        else

        {

            LinkLast(m_mVexs[p1].pFirstEdge, node1);

        }

        node2 = new ENode();

        node2->nVindex = p1;

        node2->nWeight = pEData[j]->nWeight;

        if (m_mVexs[p2].pFirstEdge == NULL)

        {

            m_mVexs[p2].pFirstEdge = node2;

        }

        else

        {

            LinkLast(m_mVexs[p2].pFirstEdge, node2);

        }

    }

}

listUDG::~listUDG()

{

    ENode *pENode = NULL;

    ENode *pTemp = NULL;

    for (int i = ; i < m_nVexNum; i ++)

    {

        pENode = m_mVexs[i].pFirstEdge;

        if (pENode != NULL)

        {

            pTemp = pENode;

            pENode = pENode->pNext;

            delete pTemp;

        }

        delete pENode;

    }

}

void listUDG::PrintUDG()

{

    ENode *pTempNode = NULL;

    cout << "邻接无向表:" << endl;

    for (int i = ; i < m_nVexNum; i ++)

    {

        cout << "顶点:" << GetVIndex(m_mVexs[i].data)<< "-" << m_mVexs[i].data<< "->";

        pTempNode = m_mVexs[i].pFirstEdge;

        while (pTempNode)

        {

            cout <<pTempNode->nVindex << "->";

            pTempNode = pTempNode->pNext;

        }

        cout << endl;

    }

}

// Prim最小生成树

void listUDG::Prim(int nStart)

{

    int i = ;

    int nIndex=;         // prim最小树的索引,即prims数组的索引

    char cPrims[MAX];     // prim最小树的结果数组

    int weights[MAX];    // 顶点间边的权值

    cPrims[nIndex++] = m_mVexs[nStart].data;

    // 初始化"顶点的权值数组",

    // 将每个顶点的权值初始化为"第start个顶点"到"该顶点"的权值。

    for (i = ; i < m_nVexNum; i++)

    {

        weights[i] = GetWeight(nStart, i);

    }

    for (i = ; i < m_nVexNum; i ++)

    {

        if (nStart == i)

        {

            continue;

        }

        int min = INF;

        int nMinWeightIndex = ;

        for (int k = ; k < m_nVexNum; k ++)

        {

            if (weights[k]!=  && weights[k] < min)

            {

                min = weights[k];

                nMinWeightIndex = k;

            }

        }

        // 找到下一个最小权重值索引

        cPrims[nIndex++] = m_mVexs[nMinWeightIndex].data;

        // 以找到的顶点更新其他点到该点的权重值

        weights[nMinWeightIndex]=;

        int nNewWeight = ;

        for (int ii = ; ii < m_nVexNum; ii++)

        {

            nNewWeight = GetWeight(nMinWeightIndex, ii);

            // 该位置需要特别注意

            if ( != weights[ii] && weights[ii] > nNewWeight)

            {

                weights[ii] = nNewWeight;

            }

        }

    }

    // 计算最小生成树的权重值

    int nSum = ;

    for (i = ; i < nIndex; i ++)

    {

        int min = INF;

        int nVexsIndex = GetVIndex(cPrims[i]);

        for (int kk = ; kk < i; kk ++)

        {

            int nNextVexsIndex = GetVIndex(cPrims[kk]);

            int nWeight = GetWeight(nVexsIndex, nNextVexsIndex);

            if (nWeight < min)

            {

                min = nWeight;

            }

        }

        nSum += min;

    }

    // 打印最小生成树

    cout << "PRIM(" << m_mVexs[nStart].data  <<")=" << nSum << ": ";

    for (i = ; i < nIndex; i++)

        cout << cPrims[i] << " ";

    cout << endl;

}

// 得到所有的边

EData* listUDG::GetEdage()

{

    EData *pEdata = new EData[m_nEdgNum];

    ENode *pTemp = NULL;

    int nEdgNum = ;

    for (int i = ; i < m_nVexNum; i ++)

    {

        pTemp = m_mVexs[i].pFirstEdge;

        while(pTemp != NULL)

        {

            if (pTemp->nVindex > i) // 可以不需要改代码,但是为了严谨和效率

            {

                pEdata[nEdgNum].nStart = m_mVexs[i].data;

                pEdata[nEdgNum].nEnd = m_mVexs[pTemp->nVindex].data;

                pEdata[nEdgNum].nWeight = pTemp->nWeight;

                nEdgNum ++;

            }

            pTemp = pTemp->pNext;

        }

    }

    return pEdata;

}

// 根据权重值对所有的边进行排序

void listUDG::SortEdges(EData* edges, int elen)

{

    int i,j;

    for (i=; i<elen; i++)

    {

        for (j=i+; j<elen; j++)

        {

            if (edges[i].nWeight > edges[j].nWeight)

            {

                // 交换"边i"和"边j"

                swap(edges[i], edges[j]);

            }

        }

    }

}

int listUDG::GetEnd(int *vends, int i)

{

    while(vends[i] != )

    {

        i = vends[i];

    }

    return i;

}

// kruska最小生成树

void listUDG::Kruskal()

{

    // 得到所有的边

    EData *pEdata = GetEdage();

    // 根据边的权重进行排序

    SortEdges(pEdata,m_nEdgNum);

    int vends[MAX] = {};     // 用于保存"已有最小生成树"中每个顶点在该最小树中的终点。

    EData rets[MAX];      // 结果数组,保存kruskal最小生成树的边

    int nStartIndex,nEndIndex;

    int nIndex = ;

    int m,n;

    for (int i = ; i < m_nEdgNum; i ++)

    {

        nStartIndex = GetVIndex(pEdata[i].nStart);

        nEndIndex = GetVIndex(pEdata[i].nEnd);

        m = GetEnd(vends, nStartIndex);

        n = GetEnd(vends, nEndIndex);

        if (m != n)

        {

            vends[m] = n;                // 设置m在"已有的最小生成树"中的终点为n

            rets[nIndex++] = pEdata[i];           // 保存结果

        }

    }

    delete[] pEdata;

    int nSum = ;

    for (int i = ; i < nIndex; i++)

        nSum += rets[i].nWeight;

    cout << "Kruskal=" << nSum << ": ";

    for (int i = ; i < nIndex; i++)

        cout << "(" << rets[i].nStart << "," << rets[i].nEnd << ") ";

    cout << endl;

}

// 获取<start, end>的权值,若start和end不是连接的,则返回无穷大

int listUDG::GetWeight(int start, int end)

{

    if (start == end)

    {

        return ;

    }

    ENode *pTempNode = m_mVexs[start].pFirstEdge;

    while (pTempNode)

    {

        if (end == pTempNode->nVindex)

        {

            return pTempNode->nWeight;

        }

        pTempNode = pTempNode->pNext;

    }

    return INF;

}

// 返回顶点的索引

int listUDG::GetVIndex(char ch)

{

    int i = ;

    for (; i < m_nVexNum; i ++)

    {

        if (m_mVexs[i].data == ch)

        {

            return i;

        }

    }

    return -;

}

void listUDG::LinkLast(ENode *pFirstNode, ENode *pNode)

{

    if (pFirstNode == NULL || pNode == NULL)

    {

        return;

    }

    ENode *pTempNode = pFirstNode;

    while (pTempNode->pNext != NULL)

    {

        pTempNode = pTempNode->pNext;

    }

    pTempNode->pNext = pNode;

}

void main()

{

    char vexs[] = {'A', 'B', 'C', 'D', 'E', 'F', 'G'};

    // 边

    EData *edges[] = {

               // 起点 终点 权

        new EData('A', 'B', ),

        new EData('A', 'F', ),

        new EData('A', 'G', ),

        new EData('B', 'C', ),

        new EData('B', 'F',  ),

        new EData('C', 'D',  ),

        new EData('C', 'E',  ),

        new EData('C', 'F',  ),

        new EData('D', 'E',  ),

        new EData('E', 'F',  ),

        new EData('E', 'G',  ),

        new EData('F', 'G',  )

    };

    int vlen = sizeof(vexs)/sizeof(vexs[]);

    int elen = sizeof(edges)/sizeof(edges[]);

    listUDG* pG = new listUDG(vexs, vlen, edges, elen);

    pG->PrintUDG();   // 打印图

    pG->Prim();

    pG->Kruskal();

    for (int i = ; i < elen; i ++)

    {

        delete edges[i];

    }

    return;

}
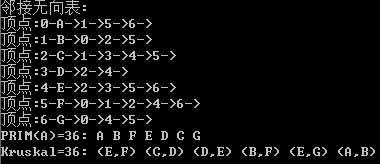
注:感谢skywang12345博主提供的内容分析,要了解更多详细信息可参考原博http://www.cnblogs.com/skywang12345/p/3711500.html
数据结构之最小生成树Kruskal算法的更多相关文章
- 数据结构:最小生成树--Kruskal算法
Kruskal算法 Kruskal算法 求解最小生成树的还有一种常见算法是Kruskal算法.它比Prim算法更直观.从直观上看,Kruskal算法的做法是:每次都从剩余边中选取权值最小的,当然,这条 ...
- 【转】最小生成树——Kruskal算法
[转]最小生成树--Kruskal算法 标签(空格分隔): 算法 本文是转载,原文在最小生成树-Prim算法和Kruskal算法,因为复试的时候只用到Kruskal算法即可,故这里不再涉及Prim算法 ...
- 模板——最小生成树kruskal算法+并查集数据结构
并查集:找祖先并更新,注意路径压缩,不然会时间复杂度巨大导致出错/超时 合并:(我的祖先是的你的祖先的父亲) 找父亲:(初始化祖先是自己的,自己就是祖先) 查询:(我们是不是同一祖先) 路径压缩:(每 ...
- 并查集与最小生成树Kruskal算法
一.什么是并查集 在计算机科学中,并查集是一种树型的数据结构,用于处理一些不交集的合并及查询问题.有一个联合-查找算法(union-find algorithm)定义了两个用于次数据结构的操作: Fi ...
- 最小生成树——Kruskal算法理解
背景:本文是在小甲鱼数据结构教学视频中的代码的基础上,添加详细注释而完成的.该段代码并不完整,仅摘录了核心算法部分,结合自己的思考,谈谈理解. Prim算法理解: 如图(摘录自小甲鱼教学视频中的图片) ...
- 最小生成树——kruskal算法
kruskal和prim都是解决最小生成树问题,都是选取最小边,但kruskal是通过对所有边按从小到大的顺序排过一次序之后,配合并查集实现的.我们取出一条边,判断如果它的始点和终点属于同一棵树,那么 ...
- 最小生成树Kruskal算法
Kruskal算法就是把图中的所有边权值排序,然后从最小的边权值开始查找,连接图中的点,当该边的权值较小,但是连接在途中后会形成回路时就舍弃该边,寻找下一边,以此类推,假设有n个点,则只需要查找n-1 ...
- 最小生成树------Kruskal算法
Kruskal最小生成树算法的概略描述:1 T=Φ:2 while(T的边少于n-1条) {3 从E中选取一条最小成本的边(v,w):4 从E中删去(v,w):5 if((v,w)在T中不生成环) { ...
- 求最小生成树——Kruskal算法
给定一个带权值的无向图,要求权值之和最小的生成树,常用的算法有Kruskal算法和Prim算法.这篇文章先介绍Kruskal算法. Kruskal算法的基本思想:先将所有边按权值从小到大排序,然后按顺 ...
随机推荐
- Python读写改Excel的方法
(注:本文部分内容摘自互联网,由于作者水平有限,不足之处,还望留言指正.) 面对疾风吧. 回首往昔,更进一步. 且随疾风前行,身后一许流星. 正文: 数据处理是Python的一大应用场景,而 Exce ...
- Linux常用命令(6/26)——dd命令和split命令
dd:用指定大小的块拷贝一个文件,并在拷贝的同时进行指定的转换. 以可选块长度复制文件,默认情况下从标准输入设备输出到标准输出设备.复制过程中,还可以对文件进行一些转换. dd命令可以指定block的 ...
- FAQ | 是什么导致MySQL数据库服务器磁盘I/O高(本文章来自知数堂)
FAQ | 是什么导致MySQL数据库服务器磁盘I/O高 2016-12-26 叶金荣 老叶茶馆 0.导读 有个MySQL服务器的磁盘I/O总有过高报警,怎么回事? 本文约1500字,阅读时间约10分 ...
- [POI2009]Lyz
Description 初始时滑冰俱乐部有1到n号的溜冰鞋各k双.已知x号脚的人可以穿x到x+d的溜冰鞋. 有m次操作,每次包含两个数ri,xi代表来了xi个ri号脚的人.xi为负,则代表走了这么多人 ...
- linux tzselect 设置时区
date -R 检查时间 tzselect 按照提示逐步设置 //这里演示的是设置东八区 TZ='Asia/Shanghai'; export TZ 添加到/etc/profile source pr ...
- jQuery对象和dom对象的转换
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- MFC clist 学习设计
最近想设计一款WEBSHELL的综合破解工具. 然后设计到了日志输出那儿,因为MFC不熟悉,刚学.所以一直在想用edit控件好还是clist比较好. 今天设计了一下日志输出界面,然后记录一下学习笔记. ...
- 嵌套的SQL另外一种写法
SELECT a.TradeOrderID 二段交易号 , c.TradeOrderID 一段订单号 , a.BaggingDate AS 出库时间 , a.TransportOrderCode AS ...
- Merge k Sorted Lists, k路归并
import java.util.Arrays; import java.util.List; import java.util.PriorityQueue; /* class ListNode { ...
- SpringBoot实现文件上传功能
新建maven项目,pom文件: <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="htt ...