
jsoup爬取图片到本地
因为项目需求,需要车辆品牌信息和车系信息,昨天用一天时间研究了jsoup爬取网站信息。项目是用maven+spring+springmvc+mybatis写的。
jsoup开发指南地址:http://www.open-open.com/jsoup/
这个是需要爬取网站的地址 https://car.autohome.com.cn/zhaoche/pinpai/
1.首先在pom.xml中添加依赖
因为需要把图片保存到本地所以又添加了commons-net包
<!-- https://mvnrepository.com/artifact/org.jsoup/jsoup -->

        <dependency>

            <groupId>org.jsoup</groupId>

            <artifactId>jsoup</artifactId>

            <version>1.10.3</version>

        </dependency>

<!-- https://mvnrepository.com/artifact/commons-net/commons-net -->

        <dependency>

            <groupId>commons-net</groupId>

            <artifactId>commons-net</artifactId>

            <version>3.3</version>

        </dependency>
2.然后是爬虫代码的实现
@Controller

@RequestMapping("/car/")

public class CarController {

    //图片保存路径

    private static final String saveImgPath="C://imgs";

    /**

    * @Title: insert 品牌名称 和图片爬取和添加

    * @Description:

    * @param @throws IOException

    * @return void

    * @throws

    * @date 2018年1月29日 下午4:42:57

    */

    @RequestMapping("add")

    public void insert() throws IOException {

        //定义想要爬取数据的地址

        String url = "https://car.autohome.com.cn/zhaoche/pinpai/";

        //获取网页文本

        Document doc = Jsoup.connect(url).get();

        //根据类名获取文本内容

        Elements elementsByClass = doc.getElementsByClass("uibox-con");

        //遍历类的集合

        for (Element element : elementsByClass) {

            //获取类的子标签数量

            int childNodeSize_1 = element.childNodeSize();

            //循环获取子标签内的内容

            for (int i = 0; i < childNodeSize_1; i++) {

                //获取车标图片地址

                String tupian = element.child(i).child(0).child(0).child(0).child(0).attr("src");

                //获取品牌名称

                String pinpai = element.child(i).child(0).child(1).text();

                //输出获取内容看是否正确

                System.out.println("车标图片地址-----------" + tupian);

                System.out.println("品牌-----------" + pinpai);

                System.out.println();

                //把车标图片保存到本地

                String tupian_1 = "http:"+tupian;

                //连接url

                URL url1 = new URL(tupian_1);

                URLConnection uri=url1.openConnection();

                //获取数据流

                InputStream is=uri.getInputStream();

                //获取后缀名

                String imageName = tupian.substring(tupian.lastIndexOf("/") + 1,tupian.length());

                //写入数据流

                OutputStream os = new FileOutputStream(new File(saveImgPath, imageName));

                byte[] buf = new byte[1024];

                int p=0;

                while((p=is.read(buf))!=-1){

                    os.write(buf, 0, p);

                }

                /**

                 * 因为每个品牌下有多个合资工厂

                 * 比如一汽大众和上海大众还有进口大众

                 * 所有需要循环获取合资工厂名称和旗下

                 * 车系

                 */

                //获取车系数量

                int childNodeSize_2 = element.child(i).child(1).child(0).childNodeSize();

                /**

                 * 获取标签下子标签数量

                 * 如果等于1则没有其他合资工厂

                 */

                int childNodeSize_3 = element.child(i).child(1).childNodeSize();

                if(childNodeSize_3==1){

                    //循环获取车系信息

                    for (int j = 0; j < childNodeSize_2; j++) {

                        String chexi = element.child(i).child(1).child(0).child(j).child(0).child(0).text();

                        System.out.println("车系-----------" + chexi);

                    }

                }else{

                    /**

                     * 如果childNodeSize_3大于1

                     * 则有多个合资工厂

                     */

                    //分别获取各个合资工厂旗下车系

                    for (int j = 0; j < childNodeSize_3; j++) {

                        int childNodeSize_4 = element.child(i).child(1).child(j).childNodeSize();

                        /**

                         * 如果j是单数则是合资工厂名称

                         * 否则是车系信息

                         */

                        int k = j%2;

                        if(k==0){

                            //获取合资工厂信息

                            String hezipinpai = element.child(i).child(1).child(j).child(0).text();

                            System.out.println("合资企业名称-----------" + hezipinpai);

                        }else{

                            //int childNodeSize_5 = element.child(i).child(1).child(0).childNodeSize();

                            //循环获取合资工厂车系信息

                            for(int l = 0; l < childNodeSize_4; l++){

                                String chexi = element.child(i).child(1).child(j).child(l).child(0).child(0).text();

                                System.out.println("车系-----------" + chexi);

                            }

                        }

                    }

                }

                System.out.println("************************");

                System.out.println("************************");

            }

        }

    }

}
3.运行结果
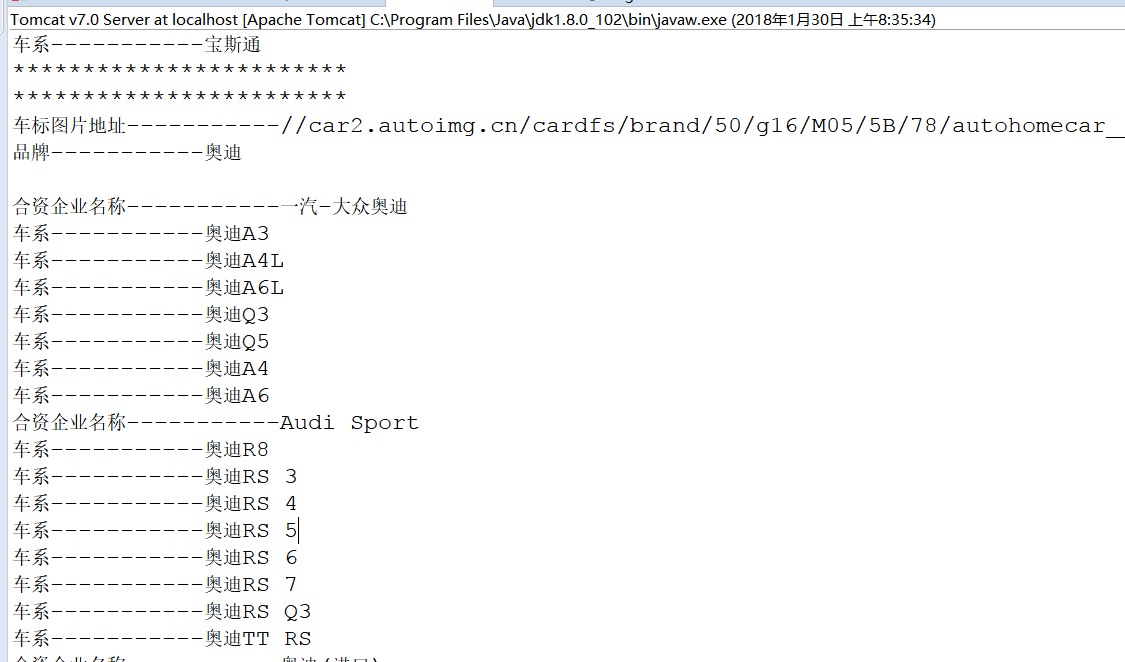

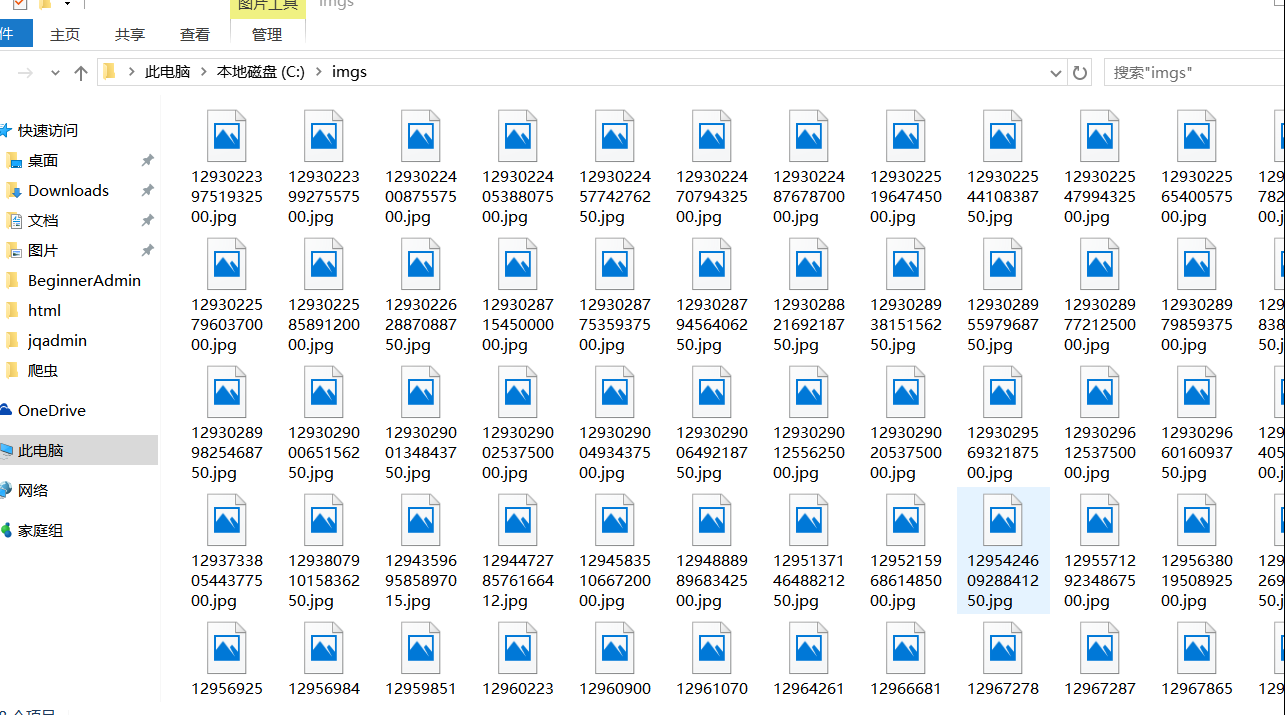
4.
jsoup爬取图片到本地的更多相关文章
- Java jsoup爬取图片
jsoup爬取百度瀑布流图片 是的,Java也可以做网络爬虫,不仅可以爬静态网页的图片,也可以爬动态网页的图片,比如采用Ajax技术进行异步加载的百度瀑布流. 以前有写过用Java进行百度图片的抓取, ...
- python实现scrapy爬取图片到本地时的sha1摘要算法文件名
2017-03-29 Scrapy爬图片到本地应该会给图片自动生成sha1摘要算法文件名,我第一次用scrapy也不清楚太多,就在程序里自己写了一段实现这一功能的代码.需import hashlib ...
- PHP 爬取图片 保存本地
public function getImage($url,$filename='') { if($url == ''){ return false; } if($filename == ''){ $ ...
- scrapy爬虫系列之三--爬取图片保存到本地
功能点:如何爬取图片,并保存到本地 爬取网站:斗鱼主播 完整代码:https://files.cnblogs.com/files/bookwed/Douyu.zip 主要代码: douyu.py im ...
- 使用Scrapy爬取图片入库,并保存在本地
使用Scrapy爬取图片入库,并保存在本地 上 篇博客已经简单的介绍了爬取数据流程,现在让我们继续学习scrapy 目标: 爬取爱卡汽车标题,价格以及图片存入数据库,并存图到本地 好了不多说,让我们实 ...
- python +requests 爬虫-爬取图片并进行下载到本地
因为写12306抢票脚本需要用到爬虫技术下载验证码并进行定位点击所以这章主要讲解,爬虫,从网页上爬取图片并进行下载到本地 爬虫实现方式: 1.首先选取你需要的抓取的URL:2.将这些URL放入待抓 ...
- Jsoup爬取带登录验证码的网站
今天学完爬虫之后想的爬一下我们学校的教务系统,可是发现登录的时候有验证码.因此研究了Jsoup爬取带验证码的网站: 大体的思路是:(需要注意的是__VIEWSTATE一直变化,所以我们每个页面都需要重 ...
- [python爬虫] 爬取图片无法打开或已损坏的简单探讨
本文主要针对python使用urlretrieve或urlopen下载百度.搜狗.googto(谷歌镜像)等图片时,出现"无法打开图片或已损坏"的问题,作者对它进行简单的探讨.同时 ...
- 孤荷凌寒自学python第八十二天学习爬取图片2
孤荷凌寒自学python第八十二天学习爬取图片2 (完整学习过程屏幕记录视频地址在文末) 今天在昨天基本尝试成功的基础上,继续完善了文字和图片的同时爬取并存放在word文档中. 一.我准备爬取一个有文 ...
随机推荐
- Kill 进程
动态杀各种进程,谨慎操作:事例 status='sleeping' --AUTHOR KiNg --DATE 2016-05-30 DECLARE @SPID INT ...
- css中的 nav ul li ul 与 nav>ul>li 这两种写法的区别
<nav> <ul id="a"> <li>a1</li> <li>a2</li> <li>a3 ...
- Java使用RSA加密算法对内容进行加密
什么是RSA加密算法 RSA是一种典型的非对称性加密算法,具体介绍可参考阮一峰的日志 RSA算法原理 下面是使用RSA算法对传输内容进行加密的一个简要Java案例,主要用到了三个类,大体实现如下: 对 ...
- 【转】Python 爬虫的工具列表【预】
这个列表包含与网页抓取和数据处理的Python库 网络 通用 urllib -网络库(stdlib). requests -网络库. grab – 网络库(基于pycurl). pycurl – 网络 ...
- (转)Linux下运行python
原文: http://blog.csdn.net/jackywgw/article/details/48847187 在linux命令行下运行python,可以直接输出hello world jack ...
- 大白话说Java泛型(一):入门、原理、使用
文章首发于[博客园-陈树义],点击跳转到原文<大白话说Java泛型(一):入门.原理.使用> 远在 JDK 1.4 版本的时候,那时候是没有泛型的概念的.当时 Java 程序员们写集合类的 ...
- 做了一个web版的 MyBatis Generator
mybatis 官方提供了 MyBatis Generator ,可以通过 xml 配置文件的方式使用,例如自己写调用脚本,或者使用 mvn 插件的方式,其实实现起来还是很简单的.虽然简单,但还是不够 ...
- 设备树的interrupt
http://www.cnblogs.com/targethero/p/5080499.html https://www.cnblogs.com/xiaojiang1025/p/6131381.htm ...
- 初识mysql学习笔记
使用VMVirtualBox导入Ubuntu后,可以通过sudo apt-get install mysql-server命令下载mysql. 在学习过程中,我遇到了连接不上Xshell的问题.最终在 ...
- linux(五)之vi编译器
前面介绍了linux的常用命令和对文本的操作,接下来我将对大家领略一下vi编译器的强大功能.希望大家觉得写的还不错的话可以点个“推荐”哦! 一.vim/vi编译器简介 Vim/Vi是一个功能强大的全屏 ...