
python +requests 爬虫-爬取图片并进行下载到本地
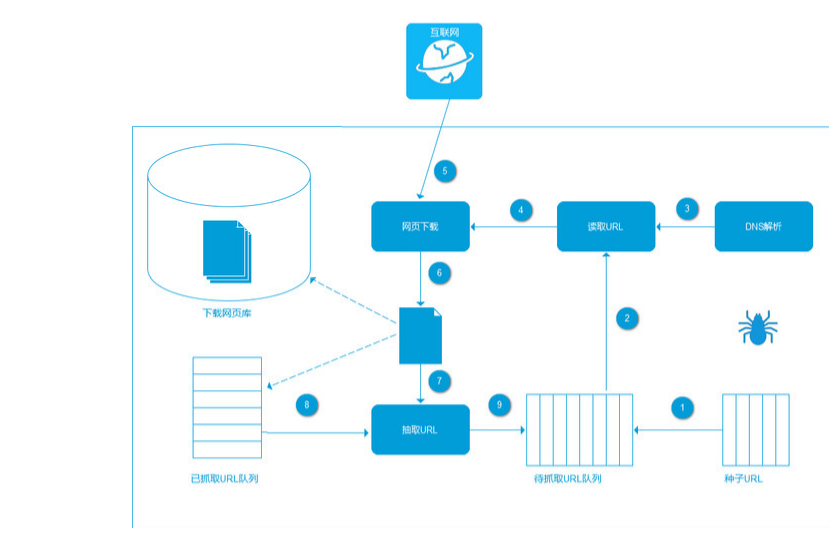
- 爬虫实现方式:
2.将这些URL放入待抓取URL队列;
3.从待抓取URL队列中取出待抓取在URL,解析DNS,并且得到主机的ip,并将URL对应的网页下载下来,存储进已下载网页库中。此外,将这些URL放进已抓取URL队列。
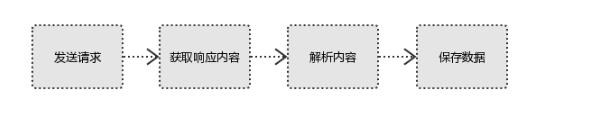
- 环境 :
- python
- re
- requests
- 正则:
pic_url = re.findall('"objURL":"(.*?)",',html, re.S)
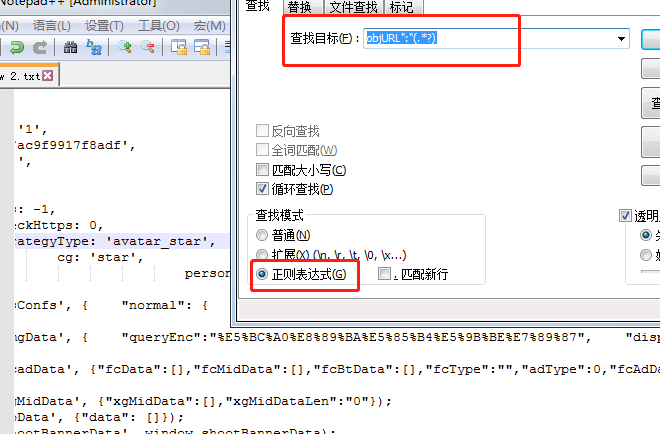
- 小技巧:这边的正则如果你不太确定有没有匹配到的话可以使用notepad++来匹配下
- 第一步查看你需要抓取网页右击查看源代码
- 第二步把代码贴入notepad++中
- 第三步f12查询选择正则进行匹配
- 也可用这个网址:http://tool.oschina.net/regex/#
- 废话不多说直接上代码
import re

import requests

def download(html):

    #通过正则匹配

    pic_url = re.findall('"objURL":"(.*?)",',html, re.S)

    i = 1

    for key in pic_url:

        print("开始下载图片:"+key +"\r\n")

        try:

            pic = requests.get(key, timeout=10)

        except requests.exceptions.ConnectionError:

            print('图片无法下载')

            continue

        #保存图片路径

        dir = '保存路径' + str(i) + '.jpg'

        fp = open(dir, 'wb')

        fp.write(pic.content)

        fp.close()

        i += 1

def main():

        url = 'https://image.baidu.com/search/index?tn=baiduimage&ipn=r&ct=201326592&cl=2&lm=-1&st=-1&sf=1&fmq=&pv=&ic=0&nc=1&z=&se=1&showtab=0&fb=0&width=&height=&face=0&istype=2&ie=utf-8&fm=index&pos=history&word=lay'

        result = requests.get(url)

        download(result.text)

if __name__ == '__main__':

        main()
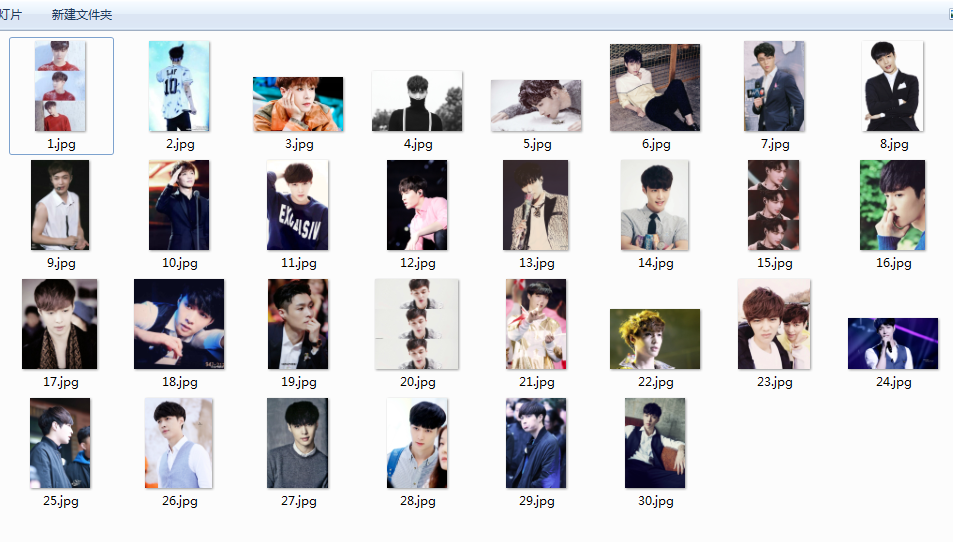
- 最后找到你下载图片的文件,然后看下小绵羊的盛世美颜
python +requests 爬虫-爬取图片并进行下载到本地的更多相关文章
- python网络爬虫&&爬取图片
爬取学院官网数据from urllib.request import * #导入所有request urllib文件夹,request只是里面的一个模块from lxml import etree # ...
- Python 实用爬虫-04-使用 BeautifulSoup 去水印下载 CSDN 博客图片
Python 实用爬虫-04-使用 BeautifulSoup 去水印下载 CSDN 博客图片 其实没太大用,就是方便一些,因为现在各个平台之间的图片都不能共享,比如说在 CSDN 不能用简书的图片, ...
- 如何利用Python网络爬虫爬取微信朋友圈动态--附代码(下)
前天给大家分享了如何利用Python网络爬虫爬取微信朋友圈数据的上篇(理论篇),今天给大家分享一下代码实现(实战篇),接着上篇往下继续深入. 一.代码实现 1.修改Scrapy项目中的items.py ...
- 利用Python网络爬虫爬取学校官网十条标题
利用Python网络爬虫爬取学校官网十条标题 案例代码: # __author : "J" # date : 2018-03-06 # 导入需要用到的库文件 import urll ...
- 使用Scrapy爬取图片入库,并保存在本地
使用Scrapy爬取图片入库,并保存在本地 上 篇博客已经简单的介绍了爬取数据流程,现在让我们继续学习scrapy 目标: 爬取爱卡汽车标题,价格以及图片存入数据库,并存图到本地 好了不多说,让我们实 ...
- [python爬虫] 爬取图片无法打开或已损坏的简单探讨
本文主要针对python使用urlretrieve或urlopen下载百度.搜狗.googto(谷歌镜像)等图片时,出现"无法打开图片或已损坏"的问题,作者对它进行简单的探讨.同时 ...
- Python 爬虫 爬取图片入门
爬虫 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动的抓取万维网信息的程序或者脚本. 用户看到的网页实质是由 HTML 代码构成的,爬 ...
- 一篇文章教会你利用Python网络爬虫获取电影天堂视频下载链接
[一.项目背景] 相信大家都有一种头疼的体验,要下载电影特别费劲,对吧?要一部一部的下载,而且不能直观的知道最近电影更新的状态. 今天小编以电影天堂为例,带大家更直观的去看自己喜欢的电影,并且下载下来 ...
- Python简易爬虫爬取百度贴吧图片
通过python 来实现这样一个简单的爬虫功能,把我们想要的图片爬取到本地.(Python版本为3.6.0) 一.获取整个页面数据 def getHtml(url): page=urllib.requ ...
随机推荐
- SCUT - 11 - 被钦定的选手 - 质因数分解
https://scut.online/p/11 T了好多次,还想用mutimap暴力分解每个数的质因数.后来记录每个数的最小质因子过了. #include <bits/stdc++.h> ...
- RMQ 的入门 hdu1806
RMQ(Range Minimum/Maximum Query),即区间最值查询,是指这样一个问题:对于长度为n的数列A,回答若干次询问RMQ(i,j),返回数列A中下标在区间[i,j]中的最小/大值 ...
- Hdu 4578 Transformation (线段树 分类分析)
Transformation Time Limit: 15000/8000 MS (Java/Others) Memory Limit: 65535/65536 K (Java/Others)T ...
- Cannot change column 'id': used in a foreign key constraint
原因:为表添加自增长,但由于该表有外键而报错 发现是因为外键的影响,不能随便的更改表结构. 要想更改表结构,首先要把基层的表修改了. A表 作为B表的外键,A表不能随便修改. B表 有A表的外键,必须 ...
- 【学习总结】java数据结构和算法-第三章-稀疏数组和队列
相关链接 [学习总结]尚硅谷2019java数据结构和算法 github:javaDSA 目录 稀疏数组 队列 稀疏数组 稀疏数组介绍 图示 应用实例 代码实现 SparseArray.java:与二 ...
- VMware新加网卡NAT连接(内网)出现本机与虚拟机ping不通的问题
今新加网卡NAT连接,配置好之后始终出现eth1:link is not ready. 虚拟机与本机不能建立连接. 解决方案:windows里面打开服务开启VMware NAT Service,并关闭 ...
- 02.Windows2012R2安装360安全卫士失败及无法卸载问题
问题: Windows 2012 R2 安装360安全卫士失败及无法卸载,导致网络无法通信问题解决. 解决:1.进入 Windows2012R2 安全模式下:2.进行覆盖安装360安全卫士:3.覆盖安 ...
- 详解JVM内存模型与JVM参数详细配置
对于大多数应用来说,Java 堆(Java Heap)是Java 虚拟机所管理的内存中最大的一块.Java 堆是被所有线程共享的一块内存区域,在虚拟机启动时创建. JVM内存结构 由上图可以清楚的看到 ...
- 【leetcode】870. Advantage Shuffle
题目如下: 解题思路:几千年前,一个古人曾经解过这个题目,他的名字叫做田忌,后人称他的解题思想叫做“田忌赛马”.言归正传,本题就是一个田忌赛马的问题,先将A与B进行排序,然后判断A[0]与B[0]的大 ...
- 玩转MaxCompute studio SQL编辑器
SQL因其简单易学的特点,是用户与MaxCompute服务交互的主要手段.如何帮助用户高效愉快的编写SQL是MaxCompute studio的核心使命,下面就让我们来一探究竟: 忘记语法 相信大家都 ...