
hdu-4471-Homework-矩阵快速幂+优化加速
题目链接:
http://acm.hdu.edu.cn/showproblem.php?pid=4471
题目意思:
求f(n).
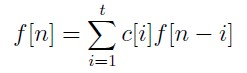
当n为特殊点nk时
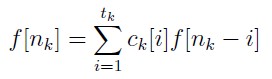
解题思路:
当x不为特殊点时,直接用基本的矩阵快速幂,求出f[x],当x为特殊点时,用另外一个矩阵,左乘转移一下。
也就是按特殊点nk,将1-n分成很多区段,一个区段一个特殊点这样来回求。
两点优化:
1、因为要多次用到同一矩阵的快速幂,所以先预处理该矩阵的2K次幂,免的计算每个区间的时候,都要计算该矩阵的2K次幂。
2、矩阵相乘的时候,把K作为主要控制元,一次计算 a[i][k]*a[k][j] ,当有a[i][k]等于0时,直接跳出来。
注意:
矩阵大小的选取,位置的选放。
c1 c2 c3 ... ct f(n-1) f(n)
1 0 0 ... 0 f(n-2) f(n-1)
0 1 0 ... 0 f(n-3) f(n-2)
0 0 1 ... 0 ... ...
... .... ... . ... ...
0 0 0 ..1 0 f(n-t) f(n-t+1)
话不多说。
代码解释的很详细:
#include<iostream>

#include<cmath>

#include<cstdio>

#include<cstdlib>

#include<string>

#include<cstring>

#include<algorithm>

#include<vector>

#include<map>

#include<set>

#include<stack>

#include<list>

#include<queue>

#define eps 1e-6

#define INF 0x1f1f1f1f

#define PI acos(-1.0)

#define ll __int64

#define lson l,m,(rt<<1)

#define rson m+1,r,(rt<<1)|1

using namespace std;

#define Maxn 110

#define M 1000000007

/*

freopen("data.in","r",stdin);

freopen("data.out","w",stdout);

*/

//本题基本思路不难想到,主要是细节优化

//学习简洁写法

struct Mar

{

   int row,col;

   int s[Maxn][Maxn];

   void init(int a,int b)

   {

      row=a,col=b;

      memset(s,0,sizeof(s));

   }

};

Mar operator * (const Mar & a,const Mar & b)

{

   Mar res;

   res.init(a.row,b.col); //初始化

   for(int k=1;k<=a.col;k++) //以列向量为标准,在0较多的情况下可以降低时间复杂度,

   {                         //以后注意这样写

      for(int i=1;i<=res.row;i++)

      {

         if(a.s[i][k]==0)

            continue;

         for(int j=1;j<=res.col;j++)

         {

            if(b.s[k][j]==0)

               continue;

            res.s[i][j]=(1LL*a.s[i][k]*b.s[k][j]+res.s[i][j])%M; //枚举k时,想成可能为0

         }  //强制转化为ll类型,免得超了

      }

   }

   /*

   for(int i=1;i<=res.row;i++)

      for(int j=1;j<=res.col;j++)

         for(int k=1;k<=a.col;k++)

            res.s[i][j]=(1LL*a.s[i][k]*b.s[k][j]+res.s[i][j])%M;*/

   return res;

}

Mar ba,sp[Maxn],ans,pp[35]; //pp[i]表示ba^(2*i)是预处理的矩阵,免得每一次都要计算

int nn[Maxn],tt[Maxn],m,n,q,t,pos[Maxn];//对下表排序

void getpp()

{

   pp[0]=ba;

   for(int i=1;i<=31;i++) //10^9 最多也就2^31次方

      pp[i]=pp[i-1]*pp[i-1];

}

bool cmp(int a,int b) //对下标排序,免得每次都移动,特别是单个元素内容很多时,浪费时间

{

   return nn[a]<nn[b];

}

void Cal(int a)//a表示次数,矩阵快速幂算,另外一种写的形式

{

   for(int i=0;i<=31;i++)

   {

      if(a&(1<<i))

         ans=pp[i]*ans;

   }

   return ;

}

/*

void Cal(int a) //这样写就tle,因为每个区段都要重新算矩阵的次方,果断采用上面的那种思路

{

   Mar tmp=ba;

   while(a)

   {

      if(a&1)

         ans=tmp*ans;

      a=a>>1;

      tmp=tmp*tmp;

   }

}*/

int main()

{

   int ca=0;

   while(scanf("%d%d%d",&n,&m,&q)!=EOF)

   {

      memset(ans.s,0,sizeof(ans));

      for(int i=m;i>=1;i--)

         scanf("%d",&ans.s[i][1]); //开始的m个

      scanf("%d",&t);

      memset(ba.s,0,sizeof(ba.s));

      for(int i=1;i<=t;i++)  //

         scanf("%d",&ba.s[1][i]);

      //scanf("%d",&q);

      for(int i=1;i<=q;i++)

      {

         pos[i]=i;

         scanf("%d%d",&nn[i],&tt[i]);

         memset(sp[i].s,0,sizeof(sp[i].s));

         for(int j=1;j<=tt[i];j++)

            scanf("%d",&sp[i].s[1][j]);

      }

      int Max=t;

      for(int i=1;i<=q;i++)

         Max=max(Max,tt[i]); //把最大的表长找到

      ba.row=ba.col=Max;

      ans.row=Max,ans.col=1;

      for(int i=2;i<=ba.row;i++) //构造基本的矩阵

         ba.s[i][i-1]=1;

      getpp();

      for(int i=1;i<=q;i++)

      {

         sp[i].row=sp[i].col=Max;

         for(int j=2;j<=sp[i].row;j++) //构造特殊位置的矩阵

            sp[i].s[j][j-1]=1;

      }

      sort(pos+1,pos+1+q,cmp); //由下标对nn排序

      int last=m;

      for(int i=1;i<=q;i++)

      {

         int p=pos[i]; //定位

         if(nn[p]>n||nn[p]<=last) //不用算

            continue;

         Cal(nn[p]-last-1);

         ans=sp[p]*ans; //特殊点单独计算

         last=nn[p];

      }

      Cal(n-last);

      printf("Case %d: %d\n",++ca,ans.s[1][1]);

   }

   return 0;

}
hdu-4471-Homework-矩阵快速幂+优化加速的更多相关文章
- HDU 5863 cjj's string game ( 16年多校10 G 题、矩阵快速幂优化线性递推DP )
题目链接 题意 : 有种不同的字符,每种字符有无限个,要求用这k种字符构造两个长度为n的字符串a和b,使得a串和b串的最长公共部分长度恰为m,问方案数 分析 : 直觉是DP 不过当时看到 n 很大.但 ...
- POJ 3744 【矩阵快速幂优化 概率DP】
搞懂了什么是矩阵快速幂优化.... 这道题的重点不是DP. /* 题意: 小明要走某条路,按照个人兴致,向前走一步的概率是p,向前跳两步的概率是1-p,但是地上有地雷,给了地雷的x坐标,(一维),求小 ...
- hdu 6395Sequence【矩阵快速幂】【分块】
Sequence Time Limit: 4000/2000 MS (Java/Others) Memory Limit: 262144/262144 K (Java/Others) Total ...
- 2018.10.23 bzoj1297: [SCOI2009]迷路(矩阵快速幂优化dp)
传送门 矩阵快速幂优化dp简单题. 考虑状态转移方程: f[time][u]=∑f[time−1][v]f[time][u]=\sum f[time-1][v]f[time][u]=∑f[time−1 ...
- 2018.10.22 bzoj1009: [HNOI2008]GT考试(kmp+矩阵快速幂优化dp)
传送门 f[i][j]f[i][j]f[i][j]表示从状态"匹配了前i位"转移到"匹配了前j位"的方案数. 这个东西单次是可以通过跳kmp的fail数组得到的 ...
- 2018.10.16 uoj#340. 【清华集训2017】小 Y 和恐怖的奴隶主(矩阵快速幂优化dp)
传送门 一道不错的矩阵快速幂优化dpdpdp. 设f[i][j][k][l]f[i][j][k][l]f[i][j][k][l]表示前iii轮第iii轮还有jjj个一滴血的,kkk个两滴血的,lll个 ...
- BZOJ4547 Hdu5171 小奇的集合 【矩阵快速幂优化递推】
BZOJ4547 Hdu5171 小奇的集合 Description 有一个大小为n的可重集S,小奇每次操作可以加入一个数a+b(a,b均属于S),求k次操作后它可获得的S的和的最大值.(数据保证这个 ...
- BZOJ5298 CQOI2018 交错序列 【DP+矩阵快速幂优化】*
BZOJ5298 CQOI2018 交错序列 [DP+矩阵快速幂优化] Description 我们称一个仅由0.1构成的序列为"交错序列",当且仅当序列中没有相邻的1(可以有相邻 ...
- HDU.2640 Queuing (矩阵快速幂)
HDU.2640 Queuing (矩阵快速幂) 题意分析 不妨令f为1,m为0,那么题目的意思为,求长度为n的01序列,求其中不含111或者101这样串的个数对M取模的值. 用F(n)表示串长为n的 ...
- Cayley-Hamilton定理与矩阵快速幂优化、常系数线性递推优化
原文链接www.cnblogs.com/zhouzhendong/p/Cayley-Hamilton.html Cayley-Hamilton定理与矩阵快速幂优化.常系数线性递推优化 引入 在开始本文 ...
随机推荐
- JavaScript两种方法来定义一个函数
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- struts2 通配符简化配置
在struts映射中反复出现的模式 动作方法 描写叙述 下一个动作方法 add 为save准备网页 save save 提交INSERT list edit 为update准备网页 update up ...
- Cf 444C DZY Loves Colors(段树)
DZY loves colors, and he enjoys painting. On a colorful day, DZY gets a colorful ribbon, which consi ...
- C++ ofstream和ifstream具体的方法和C语言file说明
ofstream是从内存到硬盘,ifstream是从硬盘到内存,事实上所谓的流缓冲就是内存空间; 在C++中,有一个stream这个类,全部的I/O都以这个"流"类为基础的,包含我 ...
- 快速构建Windows 8风格应用19-基础控件II
原文:快速构建Windows 8风格应用19-基础控件II 本篇博文接着上篇博文<快速构建Windows 8风格应用18-基础控件I>介绍开发Windows 8风格应用中常用控件. Sli ...
- Session变量不能转移到下页.解决: session.use_trans_sid = 1
附:文摘 ============================================================ 在PHP使用SESSION的朋友可能会碰到这么一个问题.SESSIO ...
- 谈Linux
新手谈Linux 目录: 什么是Linux? Linux与UNIX的区别 Linux与Windows比较 什么是Linux发布版? Linux应用领域 Linux版本的选择 怎么学习Linux? ...
- DynamicResource与StaticResource的区别
原文:DynamicResource与StaticResource的区别 2008-06-20 12:16:12 静态资源在第一次编译后即确定其对象或值,之后不能对其进行修改.动态资源则是在运行时决定 ...
- Eclipse在SVN安装步骤(两种)和使用方法
一.至Eclipse安装SVN,最常见的两种方式:手动模式,使用安装向导.具体操作步骤如下: 单程:手动安装 1.官方网站下载,从site-1.6.9.zip文件,网址是:subclipse.tigr ...
- Web服务器性能/压力测试工具http_load、webbench、ab、Siege使用教程
一.http_load 程序非常小,解压后也不到100K http_load以并行复用的方式运行,用以测试web服务器的吞吐量与负载.但是它不同于大多数压力测试工 具,它可以以一个单一的进程运行,一般 ...