
大规模数据爬取 -- Python
Python书写爬虫,目的是爬取所有的个人商家商品信息及详情,并进行数据归类分析
整个工作流程图:
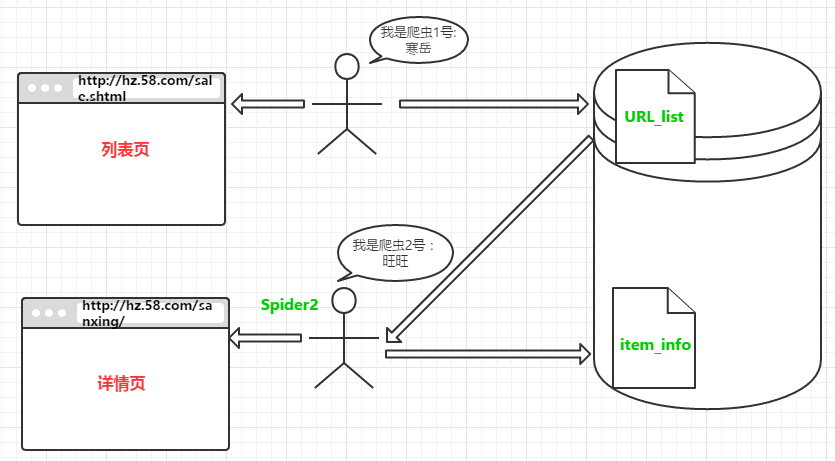
第一步:采用自动化的方式从前台页面获取所有的频道
from bs4 import BeautifulSoup

import requests

#1、找到左侧边栏所有频道的链接

start_url = 'http://hz.58.com/sale.shtml'

url_host = 'http://hz.58.com'

def get_channel_urls(url):

    wb_data = requests.get(start_url)

    soup = BeautifulSoup(wb_data.text,'lxml')

    links = soup.select('ul.ym-mainmnu > li > span > a["href"]')

    for link in links:

        page_url = url_host + link.get('href')

        print(page_url)

    #print(links)

get_channel_urls(start_url)

channel_list = '''

    http://hz.58.com/shouji/

    http://hz.58.com/tongxunyw/

    http://hz.58.com/danche/

    http://hz.58.com/diandongche/

    http://hz.58.com/diannao/

    http://hz.58.com/shuma/

    http://hz.58.com/jiadian/

    http://hz.58.com/ershoujiaju/

    http://hz.58.com/yingyou/

    http://hz.58.com/fushi/

    http://hz.58.com/meirong/

    http://hz.58.com/yishu/

    http://hz.58.com/tushu/

    http://hz.58.com/wenti/

    http://hz.58.com/bangong/

    http://hz.58.com/shebei.shtml

    http://hz.58.com/chengren/

'''
第二步:通过第一步获取的所有频道去获取所有的列表详情,并存入URL_list表中,同时获取商品详情信息
from bs4 import BeautifulSoup

import requests

import time

import pymongo

client = pymongo.MongoClient('localhost',27017)

ceshi = client['ceshi']

url_list = ceshi['url_list']

item_info = ceshi['item_info']

def get_links_from(channel,pages,who_sells=0):

    #http://hz.58.com/shouji/0/pn7/

    list_view = '{}{}/pn{}/'.format(channel,str(who_sells),str(pages))

    wb_data = requests.get(list_view)

    time.sleep(1)

    soup = BeautifulSoup(wb_data.text,'lxml')

    links = soup.select('td.t > a[onclick]')

    if soup.find('td','t'):

        for link in links:

            item_link = link.get('href').split('?')[0]

            url_list.insert_one({'url':item_link})

            print(item_link)

    else:

        pass

        # Nothing

def get_item_info(url):

    wb_data = requests.get(url)

    soup = BeautifulSoup(wb_data.text,'lxml')

    no_longer_exist = '商品已下架' in soup

    if no_longer_exist:

        pass

    else:

        title = soup.title.text

        price = soup.select('span.price_now > i')[0].text

        area = soup.select('div.palce_li > span > i')[0].text

        #url_list.insert_one({'title':title,'price':price,'area':area})

        print({'title':title,'price':price,'area':area})

#get_links_from('http://hz.58.com/pbdn/',7)

#get_item_info('http://zhuanzhuan.58.com/detail/840577950118920199z.shtml')
第三步:采用多进程的方式的main主函数入口
from multiprocessing import Pool

from channel_extract import channel_list

from page_parsing import get_links_from

def get_all_links_from(channel):

    for num in range(1,31):

        get_links_from(channel,num)

if __name__ == '__main__':

    pool = Pool()

    pool.map(get_all_links_from,channel_list.split())
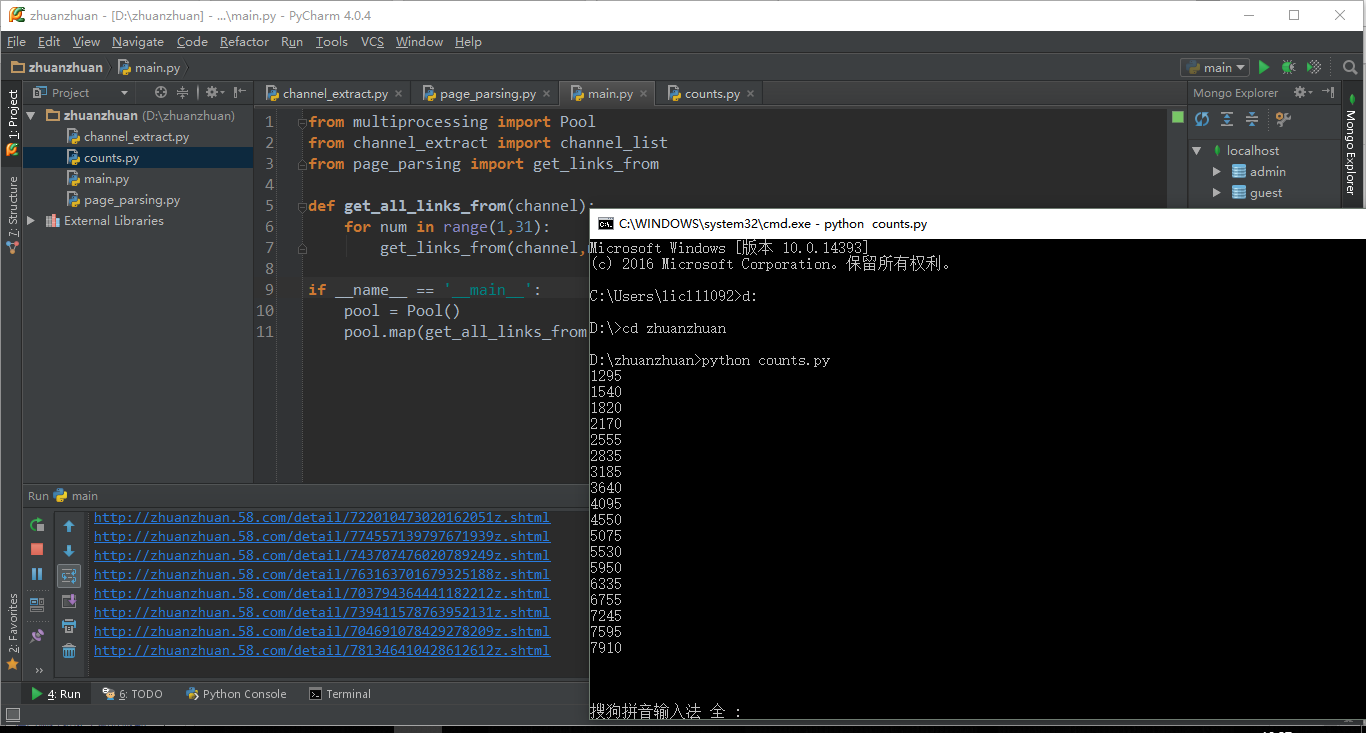
第四步:实时对获取到的数据进行监控
from time import sleep

from page_parsing import url_list

while True:

    print(url_list.find().count())

    sleep(5)
具体运行效果:
大规模数据爬取 -- Python的更多相关文章
- 模拟登陆+数据爬取 (python+selenuim)
以下代码是用来爬取LinkedIn网站一些学者的经历的,仅供参考,注意:不要一次性大量爬取会被封号,不要问我为什么知道 #-*- coding:utf-8 -*- from selenium impo ...
- python实现人人网用户数据爬取及简单分析
这是之前做的一个小项目.这几天刚好整理了一些相关资料,顺便就在这里做一个梳理啦~ 简单来说这个项目实现了,登录人人网并爬取用户数据.并对用户数据进行分析挖掘,终于效果例如以下:1.存储人人网用户数据( ...
- 芝麻HTTP:JavaScript加密逻辑分析与Python模拟执行实现数据爬取
本节来说明一下 JavaScript 加密逻辑分析并利用 Python 模拟执行 JavaScript 实现数据爬取的过程.在这里以中国空气质量在线监测分析平台为例来进行分析,主要分析其加密逻辑及破解 ...
- Python爬虫 股票数据爬取
前一篇提到了与股票数据相关的可能几种数据情况,本篇接着上篇,介绍一下多个网页的数据爬取.目标抓取平安银行(000001)从1989年~2017年的全部财务数据. 数据源分析 地址分析 http://m ...
- 人人贷网的数据爬取(利用python包selenium)
记得之前应同学之情,帮忙爬取人人贷网的借贷人信息,综合网上各种相关资料,改善一下别人代码,并能实现数据代码爬取,具体请看我之前的博客:http://www.cnblogs.com/Yiutto/p/5 ...
- 用Python介绍了企业资产情况的数据爬取、分析与展示。
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:张耀杰 PS:如有需要Python学习资料的小伙伴可以加点击下方链接自 ...
- Python爬虫入门教程 15-100 石家庄政民互动数据爬取
石家庄政民互动数据爬取-写在前面 今天,咱抓取一个网站,这个网站呢,涉及的内容就是 网友留言和回复,特别简单,但是网站是gov的.网址为 http://www.sjz.gov.cn/col/14900 ...
- quotes 整站数据爬取存mongo
安装完成scrapy后爬取部分信息已经不能满足躁动的心了,那么试试http://quotes.toscrape.com/整站数据爬取 第一部分 项目创建 1.进入到存储项目的文件夹,执行指令 scra ...
- python3编写网络爬虫13-Ajax数据爬取
一.Ajax数据爬取 1. 简介:Ajax 全称Asynchronous JavaScript and XML 异步的Javascript和XML. 它不是一门编程语言,而是利用JavaScript在 ...
随机推荐
- 【高级排序算法】1、归并排序法 - Merge Sort
归并排序法 - Merge Sort 文章目录 归并排序法 - Merge Sort nlogn 比 n^2 快多少? 归并排序设计思想 时间.空间复杂度 归并排序图解 归并排序描述 归并排序小结 参 ...
- 软碟通制作win10镜像,无法打开install.wim的问题
打开软碟通,单击左上角"文件"→"打开",选择.iso文件的存放目录,再选择.iso映像文件打开,即可看到映像文件全部加载到UltraISO了,如下图. 将 ...
- 【Linux】Linux系统dev/目录下的tty
终端是一种字符型设备,它有多种类型,通常使用tty来简称各种类型的终端设备.tty是Teletype的缩写.Teletype是最早出现的一种终端设备,很象电传打字机(或者说就是),是由Teletyp ...
- MongoDB数据库,一些的筛选过滤查询操作和db.updae()更新数据库记录遇到的坑。
缘由:使用MongoDB时遇到一些需要查询/更新操作指定某些字段的业务场景 查询和更新指定字段就需要进行简单的筛选和过滤,也能在大数据量时减少查询消耗时间 1. 查询数据库某些指定字段,同时默认返回_ ...
- centos7.4使用filrewalld打开关闭防火墙与端口
1.firewalld的基本使用启动: systemctl start firewalld关闭: systemctl stop firewalld查看状态: systemctl status fire ...
- 词嵌入之FastText
什么是FastText FastText是Facebook于2016年开源的一个词向量计算和文本分类工具,它提出了子词嵌入的方法,试图在词嵌入向量中引入构词信息.一般情况下,使用fastText进行文 ...
- 如何在C#中使用MSMQ
MSMQ (Microsoft消息队列)是Windows中默认可用的消息队列.作为跨计算机系统发送和接收消息的可靠方法,MSMQ提供了一个可伸缩.线程安全.简单和使用方便的队列,同时为你提供了在Win ...
- web框架的本质:
简单的web框架 web的应用本质其实就是socket服务器,用户所使用的浏览器就是一个cocket客户端,客户使用浏览器发送的请求会被服务接收,服务器会按照http协议的响应协议来回复请求,这样的网 ...
- Python+Selenium+Unittest实现PO模式web自动化框架(4)
1.PageLocators目录下的具体模块 2.PageLocators目录下主要放置个页面的元素定位.用于统一管理个页面的定位元素. 例如:登录页面的元素定位login_page_locator. ...
- net.core.somaxconn net.ipv4.tcp_max_syn_backlog
Linux参数-net.core.somaxconn与net.ipv4.tcp_max_syn_backlog_梁海江的博客-CSDN博客_net.ipv4.tcp_max_syn_backlog h ...