
Spark Streaming处理Flume数据练习
把Flume Source(netcat类型),从终端上不断给Flume
Source发送消息,Flume把消息汇集到Sink(avro类型),由Sink把消息推送给Spark Streaming并处理后输出
版本信息:spark2.4.0 Flume 1.7.0
(基于pyspark)
一、Flume安装
①、文件导入
# 将apache-flume-1.7.0-bin.tar.gz解压到/usr/local目录下

sudo tar -zxvf apache-flume-1.7.0-bin.tar.gz -C /usr/local

#将解压的文件修改名字为flume,简化操作

sudo mv ./apache-flume-1.7.0-bin ./flume

#把/usr/local/flume目录的权限赋予当前登录Linux系统的用户,这里假设是hadoop用户

sudo chown -R hadoop:hadoop ./flume
②、变量配置
#配置环境变量

sudo vim ~/.bashrc

#加入下面路径

export FLUME_HOME=/usr/local/flume

export FLUME_CONF_DIR=$FLUME_HOME/conf

export PATH=$PATH:$FLUME_HOME/bin
③、flume-env.sh 配置文件修改
cd /usr/local/flume/conf

sudo cp ./flume-env.sh.template ./flume-env.sh

sudo vim ./flume-env.sh

#加入java路径,根据各自路径配置

export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64;
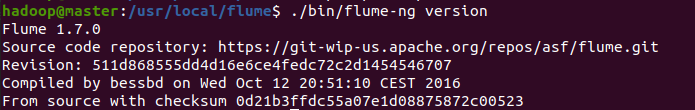
④、查看Flume版本
cd /usr/local/flume

./bin/flume-ng version
二、Avro中anent配置文件建立
cd /usr/local/flume/conf2.sudo

vim ./flume-to-spark.conf
新建文件flume-to-spark.conf
# Name the components on this agent

a1.sources = r1

a1.sinks = k1

a1.channels = c1

#receive message from port 33333

# Describe/configure the source

a1.sources.r1.type = netcat

a1.sources.r1.bind = localhost

a1.sources.r1.port = 33333

#send message through port 44444

a1.sinks.k1.type = avro

a1.sinks.k1.hostname = localhost

a1.sinks.k1.port = 44444

# Use a channel which buffers events in memory

a1.channels.c1.type = memory

a1.channels.c1.capacity = 1000000

a1.channels.c1.transactionCapacity = 1000000

# Bind the source and sink to the channel

a1.sources.r1.channels = c1

a1.sinks.k1.channel = c1
1.Flume suorce类为netcat,绑定到localhost的33333端口, 消息可以通过telnet localhost 33333 发送到flume suorce
2.Flume Sink类为avro,绑定44444端口,flume sink通过 localhost 44444端口把消息发送出来。而spark streaming程序一直监听44444端口。
三、spark配置
①、下载spark-streaming-kafka-0-8_2.11-2.4.0.jar
2.11对应scala,2.4.0对应spark版本(根据自己配置版本下载)
下载地址:
把这个jar文件放到/usr/local/spark/jars/flume目录下
②、sudo cp ./spark-streaming-kafka-0-8_2.11-2.4.0.jar /usr/local/spark/jars/flume/
③、修改spark目录下conf/spark-env.sh文件中的SPARK_DIST_CLASSPATH变量.把flume的相关jar包添加到此文件中。
export SPARK_DIST_CLASSPATH=$(/usr/local/hadoop/bin/hadoopclasspath):$(/usr/local/hbase/bin/hbaseclasspath):/usr/local/spark/jars/flume/*:/usr/local/flume/lib/*
四、编写spark程序使用Flume数据源
创建python文件
cd /usr/local/spark/mycode

mkdir flume

cd flume

sudo vim FlumeEventCount.py
代码如下:
from __future__ import print_function

import sys

from pyspark import SparkContext

from pyspark.streaming import StreamingContext

from pyspark.streaming.flume import FlumeUtils

import pyspark

if __name__ == "__main__":

    if len(sys.argv) != 3:

        print("Usage: flume_wordcount.py <hostname> <port>", file=sys.stderr)

        exit(-1)

    sc = SparkContext(appName="FlumeEventCount")

    ssc = StreamingContext(sc, 10)

    hostname= sys.argv[1]

    port = int(sys.argv[2])

    stream=FlumeUtils.createStream(ssc,hostname,port,pyspark.StorageLevel.MEMORY_AND_DISK_SER_2)

    stream.pprint()

    stream.count().map(lambda cnt : "Recieve " + str(cnt) +" Flume events!!!!").pprint()

    ssc.start()

    ssc.awaitTermination()
五、效果测试
首先启动Spark streaming程序(基于pyspark) (终端1)
入参为本地localhose 端口44444(该端口对应flume-to-spark.conf中的sinks端口)
/usr/local/spark/bin/spark-submit --driver-class-path /usr/local/spark/jars/*:/usr/local/spark/jars/flume/* ./FlumeEventCount.py localhost 44444
然后启动一个新的终端,启动Flume Agent (终端2)
cd /usr/local/flume

bin/flume-ng agent --conf ./conf --conf-file ./conf/spark-streaming.conf --name a1 -Dflume.root.logger=INFO,console
最后再启动一个新的终端连接33333端口 (终端3)
telnet localhost 33333#输入hello world
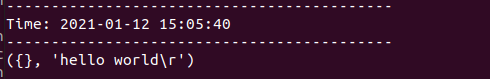
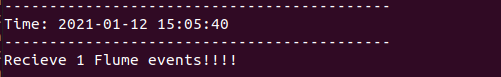
终端1结果如下:(分开返回两条信息)
学习交流,有任何问题还请随时评论指出交流。
Spark Streaming处理Flume数据练习的更多相关文章
- spark streaming集成flume
1. 安装flume flume安装,解压后修改flume_env.sh配置文件,指定java_home即可. cp hdfs jar包到flume lib目录下(否则无法抽取数据到hdfs上): $ ...
- Spark学习之路(十五)—— Spark Streaming 整合 Flume
一.简介 Apache Flume是一个分布式,高可用的数据收集系统,可以从不同的数据源收集数据,经过聚合后发送到分布式计算框架或者存储系统中.Spark Straming提供了以下两种方式用于Flu ...
- Spark 系列(十五)—— Spark Streaming 整合 Flume
一.简介 Apache Flume 是一个分布式,高可用的数据收集系统,可以从不同的数据源收集数据,经过聚合后发送到分布式计算框架或者存储系统中.Spark Straming 提供了以下两种方式用于 ...
- 通过Spark Streaming处理交易数据
Apache Spark 是加州大学伯克利分校的 AMPLabs 开发的开源分布式轻量级通用计算框架. 由于 Spark 基于内存设计,使得它拥有比 Hadoop 更高的性能(极端情况下可以达到 10 ...
- Spark Streaming 整合 Flume
Spark Streaming 整合 Flume 一.简介二.推送式方法 2.1 配置日志收集Flume 2.2 项目依赖 2.3 Spark Strea ...
- Spark Streaming揭秘 Day16 数据清理机制
Spark Streaming揭秘 Day16 数据清理机制 今天主要来讲下Spark的数据清理机制,我们都知道,Spark是运行在jvm上的,虽然jvm本身就有对象的自动回收工作,但是,如果自己不进 ...
- Spark Streaming接收Kafka数据存储到Hbase
Spark Streaming接收Kafka数据存储到Hbase fly spark hbase kafka 主要参考了这篇文章https://yq.aliyun.com/articles/60712 ...
- Spark Streaming从Flume Poll数据案例实战和内幕源码解密
本节课分成二部分讲解: 一.Spark Streaming on Polling from Flume实战 二.Spark Streaming on Polling from Flume源码 第一部分 ...
- cdh环境下,spark streaming与flume的集成问题总结
文章发自:http://www.cnblogs.com/hark0623/p/4170156.html 转发请注明 如何做集成,其实特别简单,网上其实就是教程. http://blog.csdn.n ...
随机推荐
- Day5 - 02 定义函数
定义函数 Python中定义函数要使用def语句. 依次写出函数名.括号.括号中的参数和冒号,在缩进块中编写函数体,通过return语句返回函数返回值.如: ...
- .net core WebAPI性能监控-MiniProfiler与Swagger集成
------------恢复内容开始------------ 安装Nuget Install-Package MiniProfiler.AspNetCore.Mvc Install-Package M ...
- AWT09-弹球小游戏
1.补充 为了让Java绘制动画,可以借助Swing的定时器,其构造为: 方法名 说明 Timer(int delay,ActionListener listener) 每间隔delay毫秒,自动触发 ...
- 安卓 Android Studio 下载
http://www.android-studio.org/ 下载地址 https://blog.csdn.net/qq_41976613/article/details/91432304 ...
- ElasticSearch中head插件的简单用法
1.首先在左侧打开Query栏. 2.Query下方的第一栏是分别输入es的地址.端口号.index.type. 3.Query下方的第二栏是输入将要执行的方式,旁边的下拉框是辅助选择执行的类型,如图 ...
- chrome 开发者工具使用一例
今天搜到了一篇我想看的文章,某网站上又是弹出注册小窗遮挡,又是一堆漂浮广告,还把字体搞成灰色. 右键审查元素,找到几个div,删掉:原来那个字体的灰色,是个什么script做的遮罩,也删掉. 然后整个 ...
- oranges 笔记第六章
OS 第六次实验随笔 第六章6.1-6.3相关的问题 进程状态保存与恢复 哪些状态 何时保存 保存在哪 如何恢复 特权级变换 用户进程到内核 内核回到用户进程 再次理解TSS .堆栈 从外环进入内环( ...
- 2020年下征文+没有计算机经验的宝妈也可以轻松领证一次过关啦 nice !相信努力总会收获
2020年下征文+没有计算机经验的宝妈也可以轻松领证http://www.1634.com.cn/ruankao/forum.php?mod=viewthread&tid=5363&f ...
- 会Python了不起吗?是的,简直开挂
前段时间听说了一件事,彻底刷新了我对"黑科技"的认知. 有一个小学弟,大学4年混得风生水起,恋爱.赚钱.写论文.找工作,样样都很顺利,简直是妥妥的人生赢家. 问他凭什么?张口就是: ...
- 上传报错,ITMS-90167,解决办法
ERROR ITMS-90167 No .app bundles found in the package 报这个错误的原因是上传工具的版本问题或者本地网络问题. 解决办法是使用在线最新的上传工具,推 ...