Hadoop的HDFS集群非常容易出现机器与机器之间磁盘利用率不平衡的情况,比如集群中添加新的数据节点。当HDFS出现不平衡状况的时候,将引发很多问题,比如MR程序无法很好地利用本地计算的优势,机器之间无法达到更好的网络带宽使用率,机器磁盘无法利用等等。可见,保证HDFS中的数据平衡是非常重要的。
在Hadoop中,包含一个Balancer程序,通过运行这个程序,可以使得HDFS集群达到一个平衡的状态,使用这个程序的命令如下:
 $HADOOP_HOME/bin/start-balancer.sh –t 10 
 
这个命令中-t参数后面跟的是HDFS达到平衡状态的磁盘使用率偏差值。如果机器与机器之间磁盘使用率偏差小于10%,那么我们就认为HDFS集群已经达到了平衡的状态。
 
Hadoop的开发人员在开发Balancer程序的时候,遵循了以下几点原则:
1.    在执行数据重分布的过程中,必须保证数据不能出现丢失,不能改变数据的备份数,不能改变每一个rack中所具备的block数量。
2.    系统管理员可以通过一条命令启动数据重分布程序或者停止数据重分布程序。
3.    Block在移动的过程中,不能暂用过多的资源,如网络带宽。
4.    数据重分布程序在执行的过程中,不能影响name node的正常工作。
集群执行balancer依旧不平衡的原因
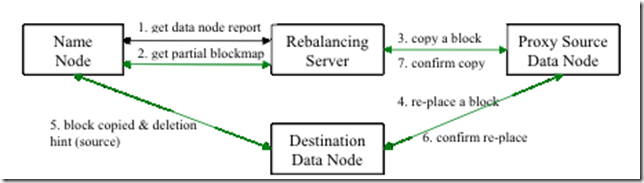
基于这些基本点,目前Hadoop数据重分布程序实现的逻辑流程如下图所示:
       
 
Rebalance程序作为一个独立的进程与name node进行分开执行。
1 Rebalance Server从Name Node中获取所有的Data Node情况:每一个Data Node磁盘使用情况。
2 Rebalance Server计算哪些机器需要将数据移动,哪些机器可以接受移动的数据。并且从Name Node中获取需要移动的数据分布情况。
3 Rebalance Server计算出来可以将哪一台机器的block移动到另一台机器中去。
4,5,6 需要移动block的机器将数据移动的目的机器上去,同时删除自己机器上的block数据。
7  Rebalance Server获取到本次数据移动的执行结果,并继续执行这个过程,一直没有数据可以移动或者HDFS集群以及达到了平衡的标准为止。
Hadoop现有的这种Balancer程序工作的方式在绝大多数情况中都是非常适合的。
现在我们设想这样一种情况:
1 数据是3份备份。
2 HDFS由2个rack(机架)组成。
3 2个rack中的机器磁盘配置不同,第一个rack中每一台机器的磁盘空间为1TB,第二个rack中每一台机器的磁盘空间为10TB。
4 现在大多数数据的2份备份都存储在第一个rack中。
在这样的一种情况下,HDFS级群中的数据肯定是不平衡的。现在我们运行Balancer程序,但是会发现运行结束以后,整个HDFS集群中的数据依旧不平衡:rack1中的磁盘剩余空间远远小于rack2。
这是因为Balance程序的开发原则1导致的。
简单的说,就是在执行Balancer程序的时候,不会将数据中一个rack移动到另一个rack中,所以就导致了Balancer程序永远无法平衡HDFS集群的情况。
针对于这种情况,可以采取2中方案:
1 继续使用现有的Balancer程序,但是修改rack中的机器分布。将磁盘空间小的机器分叉到不同的rack中去。
2 修改Balancer程序,允许改变每一个rack中所具备的block数量,将磁盘空间告急的rack中存放的block数量减少,或者将其移动到其他磁盘空间富余的rack中去。
----------------------------------------------------------------------------------------------------------
使用经验总结
由于历史原因,hadoop集群中的机器的磁盘空间的大小各不相同,而HDFS在进行写入操作时,并没有考虑到这种情况,所以随着数据量的逐渐增加,磁盘较小的datanode机器上的磁盘空间很快将被写满,从而触发了报警。
此时,不得不手工执行start-balancer.sh来进行balance操作,即使将dfs.balance.bandwidthPerSec  参数设置为10M/s,整个集群达到平衡也需要很长的时间,所以写了个crontab来每天凌晨来执行start-balancer.sh,由于此时集群不平衡的状态还没有那么严重,所以start-balancer.sh很快执行结束了。
另外需要注意的地方是,由于HDFS需要启动单独的Rebalance Server来执行Rebalance操作,所以尽量不要在NameNode上执行start-balancer.sh,而是找一台比较空闲的机器。
1) hadoop balance工具的用法:
To start:  
bin/start-balancer.sh [-threshold <threshold>]  
Example: bin/ start-balancer.sh  
start the balancer with a default threshold of 10%  
bin/ start-balancer.sh -threshold 5  
start the balancer with a threshold of 5%  
To stop:  
bin/ stop-balancer.sh  
2)影响hadoop balance工具的几个参数:
-threshold 默认设置:10,参数取值范围:0-100,参数含义:判断集群是否平衡的目标参数,每一个 datanode 存储使用率和集群总存储使用率的差值都应该小于这个阀值 ,理论上,该参数设置的越小,整个集群就越平衡,但是在线上环境中,hadoop集群在进行balance时,还在并发的进行数据的写入和删除,所以有可能无法到达设定的平衡参数值。
dfs.balance.bandwidthPerSec  默认设置:1048576(1 M/S),参数含义:设置balance工具在运行中所能占用的带宽,设置的过大可能会造成mapred运行缓慢


hadoop 中balance 机制的更多相关文章

  1. hbase中balance机制

    HBase是一种支持自动负载均衡的分布式KV数据库,在开启balance的开关(balance_switch)后,HBase的HMaster进程会自动根据指定策略挑选出一些Region,并将这些Reg ...

  2. 3 weekend110的hadoop中的RPC框架实现机制 + hadoop中的RPC应用实例demo

    hadoop中的RPC框架实现机制 RPC是Remotr Process Call, 进程间的远程过程调用,不是在一个jvm里. 即,Controller拿不到Service的实例对象. hadoop ...

  3. 1 weekend110的复习 + hadoop中的序列化机制 + 流量求和mr程序开发

    以上是,weekend110的yarn的job提交流程源码分析的复习总结 下面呢,来讲weekend110的hadoop中的序列化机制 1363157985066      13726230503  ...

  4. HADOOP高可用机制

    HADOOP高可用机制 HA运作机制 什么是HA HADOOP如何实现HA HDFS-HA详解 HA集群搭建 目标: 掌握分布式系统中HA机制的思想 掌握HADOOP内置HA的运作机制 掌握HADOO ...

  5. Hadoop中客户端和服务器端的方法调用过程

    1.Java动态代理实例 Java 动态代理一个简单的demo:(用以对比Hadoop中的动态代理) Hello接口: public interface Hello { void sayHello(S ...

  6. MapReduce中作业调度机制

    MapReduce中作业调度机制主要有3种: 1.先入先出FIFO      Hadoop 中默认的调度器,它先按照作业的优先级高低,再按照到达时间的先后选择被执行的作业. 2.公平调度器(相当于时间 ...

  7. Hadoop 中疑问解析

    Hadoop 中疑问解析 FAQ问题剖析 一.HDFS 文件备份与数据安全性分析1 HDFS 原理分析1.1 Hdfs master/slave模型 hdfs采用的是master/slave模型,一个 ...

  8. hadoop 错误处理机制

    hadoop 错误处理机制 1.硬件故障 硬件故障是指jobtracker故障或TaskTracker 故障 jobtracker是单点,若发生故障,目前hadoop 还无法处理,唯有选择最牢靠的硬件 ...

  9. Hadoop 中 IPC 的源码分析

    最近开始看 Hadoop 的一些源码,展开hadoop的源码包,各个组件分得比较清楚,于是开始看一下 IPC 的一些源码. IPC模块,也就是进程间通信模块,如果是在不同的机器上,那就可以理解为 RP ...

随机推荐

  1. case when then else end 与 decode 的区别

    case when  then else end : 条件可以有 等于 ,大于 ,小于 与 decode : 条件只可以有等于的.

  2. Docker 常用命令——容器

    1.新建并启动容器 docker run [option] images [command][arg]    #根据镜像新建容器并运行.如果本地没有镜像则从docker hub上拉取. --name ...

  3. Model验证简单易懂

    public bool UserSex { get; set; } //定义名字 [Display(Name = "年龄")] [Range(0, 150, ErrorMessag ...

  4. Python 整数 长整数 浮点数 字符串 列表 元组 字典的各种方法

    对于Python, 一切事物都是对象,对象基于类创建!! 注:查看对象相关成员var,type, dir 一.整数 如: 18.73.84 每一个整数都具备如下需要知道的功能: def bit_len ...

  5. (1)linux和oracle---环境搭建

    对linux和oracle一直是敬而远之,稍微有些了解.无奈由于工作需要这次要硬着头皮上了!@#!@@#$%^^ 对于重windows用户的我来说,简直是万种折磨. 算是做个记录吧,一定要坚持下去. ...

  6. u-boot-1.1.6第1阶段分析之start.S、lowlevel_init.S文件

    学习目标: 对start.S中每一行代码,都有基本了解 通过对start.S文件分析,对ARM920T架构的CPU的启动过程,有更清楚理解 U-boot属于两个阶段的Bootloader,第一阶段的文 ...

  7. python财经数据接口包Tushare pro的入门及简单使用方式(大数据,股票数据接口)

    最近在做一个项目,需要用到股票的数据,我在网上查了很久,最终发现在股票数据上面还是tushare比较专业,而且对于将来做金融行业的大数据这一块的,tushare绝对是你的一个好帮手,所以下面我就简单介 ...

  8. 大二作业——操作系统实验——C语言用双向链表,模拟实现动态分区式存储管理

    实验:动态分区式存储管理 实验内容: 编写程序模拟完成动态分区存储管理方式的内存分配和回收.实验具体包括:首先确定内存空闲分配表:然后采用最佳适应算法完成内存空间的分配和回收:最后编写主函数对所做工作 ...

  9. SOC中的DFT和BIST对比与比较-IC学习笔记(二)

    ATE:ATE是Automatic Test Equipment的缩写,根据客户的测试要求.图纸及参考方案,采用MCU.PLC.PC基于VB.VC开发平台,利用TestStand&LabVIE ...

  10. 【转】ASP.NET 防止同一用户同时登陆

    要防止同一用户同时登陆,首页应该记录在线用户的信息(这里与用户名为例),然后判断正在登陆的用户里面是否已存在.在这里使用一个cache存放已经登陆的用户名,但是还有一个问题就是要知道用户是什么时候离开 ...