
Spark之编程模型RDD
前言:Spark编程模型两个主要抽象,一个是弹性分布式数据集RDD,它是一种特殊集合,支持多种数据源,可支持并行计算,可缓存;另一个是两种共享变量,支持并行计算的广播变量和累加器。
1.RDD介绍
Spark大数据处理平台建立在RDD之上,RDD是Spark的核心概念,最主要的抽象之一。RDD和Spark之间的关系是,RDD是一种基于内存的具有容错性的集群抽象方法,Spark是这个抽象方法的实现。
RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变、可分区、里面的元素可并行计算的集合。RDD具有数据流模型的特点:自动容错、位置感知性调度和可伸缩性。RDD允许用户在执行多个查询时显式地将工作集缓存在内存中,后续的查询能够重用工作集,这极大地提升了查询速度。
1.1 RDD的特征
(1)分区(Partition):一个数据分片列表。能够将数据切分,切分好的数据能够进行并行计算,是数据集的原子组成部分。用户可以在创建RDD时指定RDD的分片个数,如果没有指定,那么就会采用默认值。默认值就是程序所分配到的CPU Core的数目。
(2)函数(Compute):一个计算RDD每个分片的函数。RDD的计算是以分片为单位的,每个RDD都会实现compute函数以达到这个目的。compute函数会对迭代器进行复合,不需要保存每次计算的结果。
(3)依赖(Dependency):RDD的每次转换都会生成一个新的RDD,所以RDD之间就会形成类似于流水线一样的前后依赖关系。在部分分区数据丢失时,Spark可以通过这个依赖关系重新计算丢失的分区数据,而不是对RDD的所有分区进行重新计算。
(4)优先位置(可选):一个列表,存储存取每个Partition的优先位置(preferred location)。对于一个HDFS文件来说,这个列表保存的就是每个Partition所在的块的位置。按照“移动数据不如移动计算”的理念,Spark在进行任务调度的时候,会尽可能地将计算任务分配到其所要处理数据块的存储位置。
(5)分区策略(可选):一个Partitioner,即RDD的分片函数,描述分区的模式和数据存放的位置。当前Spark中实现了两种类型的分片函数,一个是基于哈希的HashPartitioner,另外一个是基于范围的RangePartitioner。只有对于于key-value的RDD,才会有Partitioner,非key-value的RDD的Parititioner的值是None。Partitioner函数不但决定了RDD本身的分片数量,也决定了parent RDD Shuffle输出时的分片数量。
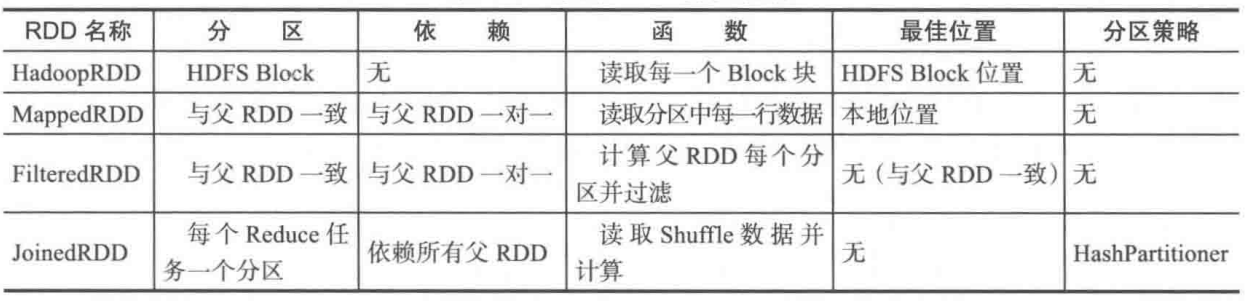
常见的RDD有很多种,每个Transformation操作都会产生一种RDD,一下是各种RDD特征比较。
1.2 RDD依赖
Spark之编程模型RDD的更多相关文章
- Spark核心编程---创建RDD
创建RDD: 1:使用程序中的集合创建RDD,主要用于进行测试,可以在实际部署到集群运行之前,自己使用集合构造测试数据,来测试后面的spark应用流程. 2:使用本地文件创建RDD,主要用于临时性地处 ...
- spark wordcount 编程模型详解
spark wordcount中一共经历多少个RDD?以及RDD提供的toDebugString 在控制台输入spark-shell 系统会默认创建一个SparkContext sc h ...
- Spark 编程模型(上)
Spark的编程模型 核心概念(注意对比MR里的概念来学习) Spark Application的组成 Spark Application基本概念 Spark Application编程模型 回顾sc ...
- Spark编程模型(博主推荐)
福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 Java全栈大联盟 ...
- Spark1.0.0 编程模型
Spark Application能够在集群中并行执行,其关键是抽象出RDD的概念(详见RDD 细解),也使得Spark Application的开发变得简单明了.下图浓缩了Spark的编程模型. w ...
- Spark编程模型(RDD编程模型)
Spark编程模型(RDD编程模型) 下图给出了rdd 编程模型,并将下例中用 到的四个算子映射到四种算子类型.spark 程序工作在两个空间中:spark rdd空间和 scala原生数据空间.在原 ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Spark中文指南(入门篇)-Spark编程模型(一)
前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apache Spark简介 Spark的四种运行模式 Spark基于Standlone的运行流程 Spark ...
- Spark:Spark 编程模型及快速入门
http://blog.csdn.net/pipisorry/article/details/52366356 Spark编程模型 SparkContext类和SparkConf类 代码中初始化 我们 ...
随机推荐
- linux 常用进程使用命令
查看进程占用pid ps aux | grep program_filter_word 杀死pid kill -
- ovs的卸载删除
参考博客1 参考博客2 需要更新.重装ovs时需要先卸载. 删除网桥.端口 ovs-vsctl del-br 交换机名 ovs-vsctl del-port 交换机名 端口名(网卡名) 关闭服务 su ...
- Xcode 5.1安装插件:规范凝视生成器VVDocumenter
类似java的多行凝视! 安装过程: 1.前往GitHub下载project文件:VVDocumenter-Xcode 2.用Xcode打开project,Command + B Build成功后,能 ...
- JAVA并发(一)
java并发的一系列框架和技术主要是由java.util.concurrent 包所提供.包下的所有类可以分为如下几大类: locks部分:显式锁(互斥锁和速写锁)相关: atomic部分:原子变量类 ...
- C++的六个函数
一.构造函数 在C++中,构造函数是六个函数中的第一个,当一个对象被创建时,在它的整个周期中,是一个由生到死的 过程,即构造函数创建对象,析构函数析构对象.在对象被创建时,调用构造函数创建一个对象,这 ...
- Elasticsearch入门和查询语法分析(ik中文分词)
全文搜索现在已经是很常见的功能了,当然你也可以用mysql加Sphinx实现.但开源的Elasticsearch(简称ES)目前是全文搜索引擎的首选.目前像GitHub.维基百科都使用的是ES,它可以 ...
- 【六】tf和cgi进行联合试验,完成日志服务器
[任务6]tf和cgi进行联合试验,完成日志服务器 [任务6]tf和cgi进行联合试验,完成日志服务器 改装gen-cpp目录下client.cpp文件 启动Nginx服务和gen-cpp目录下编译后 ...
- 树莓派3B+学习笔记:13、不间断会话服务screen
screen是一款能够实现多窗口远程控制的开源服务程序,简单来说就是为了解决网络异常中断或为了同时控制多个远程终端窗口而设计的程序.用户还可以使用screen服务程序同时在多个远程会话中自由切换,能够 ...
- linux查看文件命令tail的使用
一.介绍 linux tail命令用途是依照要求将指定的文件的最后部分输出到终端中,通俗讲来,就是把某个档案文件的最后几行显示到终端上,假设该档案有更新,tail会自己主动刷新,确保你看到最新的档案内 ...
- Opencv3.0-python: 编译报错color.cpp:7456: error: (-215) scn == 3 || scn == 4 的解决方案
结合Opencv3.0读取视频时,出现报错:C:\projects\opencv-python\opencv\modules\imgproc\src\color.cpp:11111: error: ( ...