
HIVE-分区表详解以及实例
HIVE中的分区表是什么,我们先看操作,然后再来体会。
创建一个分区表,分区的单位时dt和国家名

hive> create table logs(ts bigint,line string)

    > partitioned by (dt String,country string);
接下来我们创建要给分区
hive> load data local inpath '/root/hive/partitions/file1' into table logs

    > partition (dt='2001-01-01',country='GB');
上面语句的效果是在hdfs系统上建立了一个层级目录
-logs
-dt=2001-01-01
-country=GB
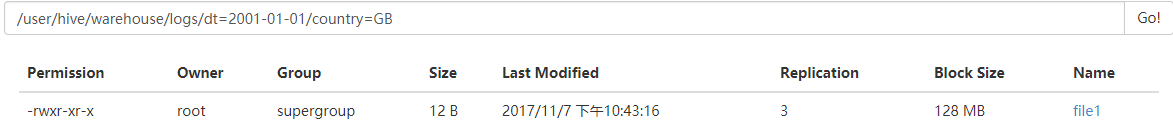
我们继续执行下面语句,先看一下什么效果

hive>  load data local inpath '/root/hive/partitions/file2' into table logs

    > partition (dt='2001-01-01',country='GB');

Loading data to table default.logs partition (dt=2001-01-01, country=GB)

OK

Time taken: 1.379 seconds

hive>  load data local inpath '/root/hive/partitions/file3' into table logs

    > partition (dt='2001-01-01',country='US');

Loading data to table default.logs partition (dt=2001-01-01, country=US)

OK

Time taken: 1.307 seconds

hive>  load data local inpath '/root/hive/partitions/file4' into table logs

    > partition (dt='2001-01-02',country='GB');

Loading data to table default.logs partition (dt=2001-01-02, country=GB)

OK

Time taken: 1.253 seconds

hive>  load data local inpath '/root/hive/partitions/file5' into table logs

    > partition (dt='2001-01-02',country='US');

Loading data to table default.logs partition (dt=2001-01-02, country=US)

OK

Time taken: 1.07 seconds

hive>  load data local inpath '/root/hive/partitions/file6' into table logs

    > partition (dt='2001-01-02',country='US');

Loading data to table default.logs partition (dt=2001-01-02, country=US)

OK

Time taken: 1.227 seconds
我们到HDFS上查看,发现建立了下面层级目录
/user/hive/warehouse/logs
├── dt=2001-01-01/
│ ├── country=GB/
│ │ ├── file1
│ │ └── file2
│ └── country=US/
│ └── file3
└── dt=2001-01-02/
├── country=GB/
│ └── file4
└── country=US/
├── file5
└── file6
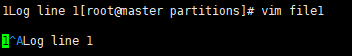
是加上所有files的内容基本上一样,蓝色的^A是系统默认分隔符。八进制是‘\001’.随后参考我的另一个文章。比较详细解释了分隔符。
总结:分区表的意思,其实想明白了就很简单。就是在系统上建立文件夹,把分类数据放在不同文件夹下面,加快查询速度。
关键点1:partitioned by (dt String,country string); 创建表格时,指明了这是一个分区表。将建立双层目录,第一次目录的名字和第二层目录名字规则
PARTITIONED BY子句中定义列,是表中正式的列,成为分区列。但是数据文件中并没有这些值,仅代表目录。
关键点2: partition (dt='2001-01-01',country='GB'); 上传数据时,把数据分别上传到不同分区中。也就是分别放在不同的子目录下。
理解分区就是文件夹分而治之,查询的时候可以当作列名来显示查询的范围。
查看分区结构

hive> show partitions logs;

OK

dt=2001-01-01/country=GB

dt=2001-01-01/country=US

dt=2001-01-02/country=GB

dt=2001-01-02/country=US
条件限定了country='GB'目录所以只有file1,2,4的内容输出
hive> select ts,dt,line

    > from logs

    > where country='GB';

OK

1    2001-01-01    Log line 1

2    2001-01-01    Log line 2

4    2001-01-02    Log line 4

现在只查看dt=2001-01-02目录下country=US的文件夹下的数据。
hive> select ts,dt,line
> from logs
> where dt='2001-01-02'
> and country='US';
OK
5 2001-01-02 Log line 5
6 2001-01-02 Log line 6
HIVE-分区表详解以及实例的更多相关文章
- XML参考 :XmlReader 详解、实例
XML参考 :XmlReader 详解.实例-- 详解 转:http://www.cnblogs.com/Dlonghow/archive/2008/07/28/1252191.html XML参考 ...
- Protocol Buffer技术详解(Java实例)
Protocol Buffer技术详解(Java实例) 该篇Blog和上一篇(C++实例)基本相同,只是面向于我们团队中的Java工程师,毕竟我们项目的前端部分是基于Android开发的,而且我们研发 ...
- Protocol Buffer技术详解(C++实例)
Protocol Buffer技术详解(C++实例) 这篇Blog仍然是以Google的官方文档为主线,代码实例则完全取自于我们正在开发的一个Demo项目,通过前一段时间的尝试,感觉这种结合的方式比较 ...
- Java学习-007-Log4J 日志记录配置文件详解及实例源代码
此文主要讲述在初学 Java 时,常用的 Log4J 日志记录配置文件详解及实例源代码整理.希望能对初学 Java 编程的亲们有所帮助.若有不足之处,敬请大神指正,不胜感激!源代码测试通过日期为:20 ...
- groupadd命令详解(实例)
groupadd命令详解(实例) 1.作用groupadd命令用于将新组加入系统. 2.格式groupadd [-g gid] [-o]] [-r] [-f] groupname 3.主要参数-g ...
- GLSL-几何着色器详解跟实例(GS:Geometry Shader)[转]
[OpenGL4.0]GLSL-几何着色器详解和实例(GS:Geometry Shader) 一.什么是几何着色器(GS:Geometry Shader) Input Assembler(IA)从顶点 ...
- CvMat、Mat、IplImage之间的转换详解及实例
见原博客:http://blog.sina.com.cn/s/blog_74a459380101obhm.html OpenCV学习之CvMat的用法详解及实例 CvMat是OpenCV比较基础的函数 ...
- C语言操作WINDOWS系统存储区数字证书相关函数详解及实例
C语言操作WINDOWS系统存储区数字证书相关函数详解及实例 以下代码使用C++实现遍历存储区证书及使用UI选择一个证书 --使用CertOpenSystemStore打开证书存储区. --在循环中 ...
- httpd配置文件详解及实例
httpd配置文件详解及实例 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.http协议的组成 http协议是C/S架构:我们可以把浏览器(如:IE,Firefox,Safar ...
- oracle partition table 分区表详解
Oracle partition table 分区表详解 分区表就是通过使用分区技术,将一张大表,拆分成多个表分区(独立的segment),从而提升数据访问的性能,以及日常的可维护性.分区表中,每个分 ...
随机推荐
- 【Topcoder】SRM157 DIV2总结
250分题:简单的二分,就是平常玩的猜数字游戏 代码:GitHub 500分题:给出一个员工一天的打卡时间段,要求求出员工这一天的工资.其中正常上班时间是6:00:00到18:00:00,薪水是wag ...
- js 职责链模式简要介绍
定义: 使多个对象都有机会处理请求,避免发送者与接受者之间的耦合关系,将对象连成一条链,沿着这条链传递请求,直到有一个对象处理它. 如何把对象串联起来?解决方法通常是将另一个对象作为新创建对象的参数, ...
- BYTE、HANDEL、DWORD等的定义
有时候引入第三方库之后,可能会存在标题的这些变量没有定义,原来这些变量都定义在windows.h里面,包含进去就行了(Qt的MSVC编译器)
- Android编译系统环境过程初始化分析【转】
本文转载自:http://blog.csdn.net/luoshengyang/article/details/18928789 Android源代码在编译之前,要先对编译环境进行初始化,其中最主要就 ...
- Go sqlx库
sqlx is a library which provides a set of extensions on go's standard database/sql library. sqlx sup ...
- Go 语言为Fibonacci函数实现Read方法
Go语言非常灵活,只要为对象实现了相应的方法就可以把他看成实现了某个接口,类似于Durk Type, 为Fibonacci实现Read方法,就可以像读取文件一样,去读取下一个Fibonacci值. 示 ...
- Linux 内核是如何构建
https://github.com/MintCN/linux-insides-zh 介绍 我不会告诉你怎么在自己的电脑上去构建.安装一个定制化的 Linux 内核,这样的资料太多了,它们会对你有帮助 ...
- 【P1714】切蛋糕(单调队列)
实在不明白难度等级,难不成前缀和是个很变态的东西? 说白了就是单调队列裸题,都没加什么别的东西,就是一个前缀和的计算,然而这个题也不是要用它优化,而是必须这么做啊. #include<iostr ...
- Freemarker 使用
Freemarker 使用 博客分类: JAVA freemarker 以下内容全部是网上收集: FreeMarker的模板文件并不比HTML页面复杂多少,FreeMarker模板文件主要由如下4个 ...
- QT 使用QSettings读写ini配置文件
利用Qsettings包一个类 RWIniFile, writeIni方法写文件, readIni方法读文件 rwinifile.h #ifndef RWINIFILE_H #define RWINI ...