
python爬虫实例——爬取歌单
学习自<<从零开始学python网络爬虫>>
爬取酷狗歌单,保存入csv文件
直接上源代码:(含注释)
import requests                     #用于请求网页获取网页数据

from bs4 import BeautifulSoup       #解析网页数据

import time                         #time库中的sleep()方法可以让程序暂停

import csv

'''

爬虫测试

酷狗top500数据

写入csv文件

'''

fp = open('D://kugou.csv','wt',newline='',encoding='utf-8')#创建csv

writer = csv.writer(fp)

writer.writerow(('rank','singer','song','time'))

#加入请求头

headers = {

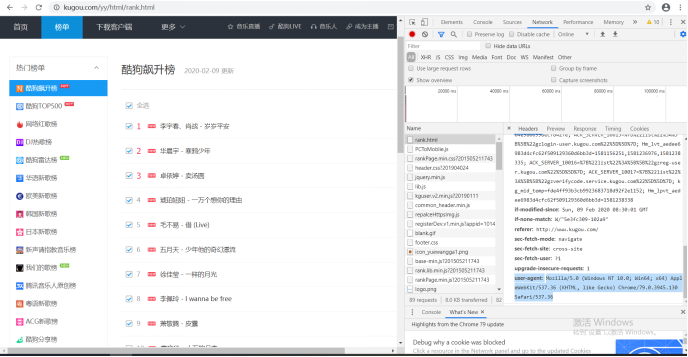
    'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'

}

#定义获取信息的函数

def get_info(url):

    wb_data = requests.get(url,headers=headers)#get方法加入请求头

    soup = BeautifulSoup(wb_data.text,'html.parser')#对返回结果进行解析

    #定位元素位置并通过selector方法获取

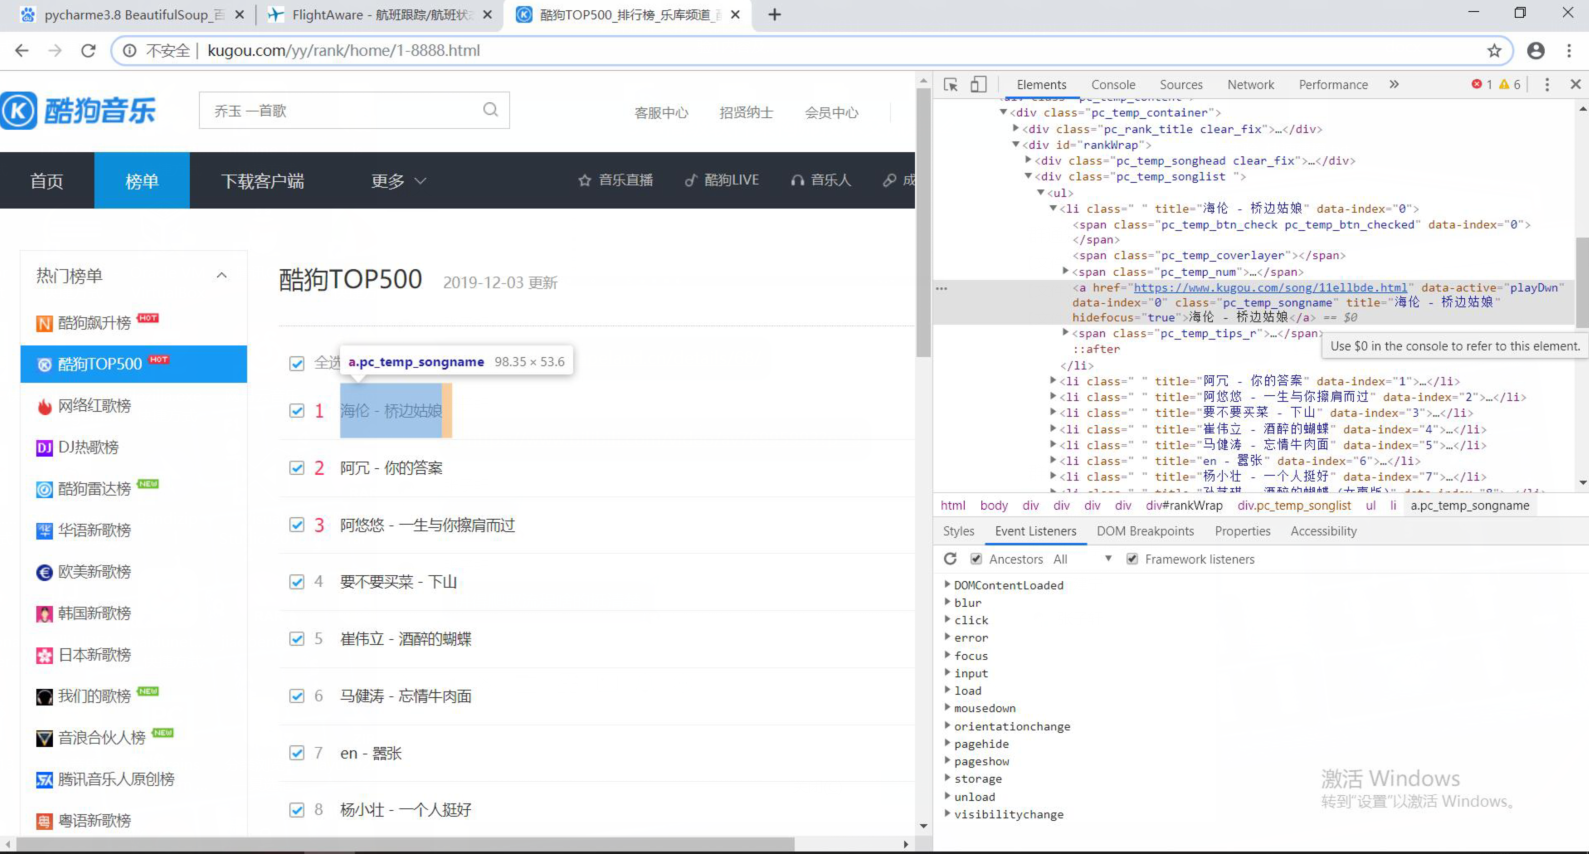
    ranks = soup.select('span.pc_temp_num')

    titles = soup.select('div.pc_temp_songlist > ul > li > a')

    times = soup.select('span.pc_temp_tips_r > span')

    for rank,title,time in zip(ranks,titles,times):

        data = {

            'rank':rank.get_text().strip(),

            'singer':title.get_text().split('-')[0],

            'song':title.get_text().split('-')[0],#通过split获取歌手和歌曲信息

            'time':time.get_text().strip()#get_text()获取文本内容

        }

        writer.writerow((rank.get_text().strip(),title.get_text().split('-')[0],title.get_text().split('-')[0],time.get_text().strip()))

        # 获取爬取信息并按字典格式打印

        #print(data)

#程序主入口

if __name__ == '__main__':

    urls = ['http://www.kugou.com/yy/rank/home/{}-8888.html'.format(str(i)) for i in range(1,4)]#构造多页url

    for url in urls:

        get_info(url)#循环调用

        time.sleep(1)#每循环一次,睡眠1秒,防止网页浏览频率过快导致爬虫失败
爬虫实例
浏览器:Chrome
请求头获取方法:
网站爬取:
python爬虫实例——爬取歌单的更多相关文章
- Python爬虫之爬取慕课网课程评分
BS是什么? BeautifulSoup是一个基于标签的文本解析工具.可以根据标签提取想要的内容,很适合处理html和xml这类语言文本.如果你希望了解更多关于BS的介绍和用法,请看Beautiful ...
- [Python爬虫] Selenium爬取新浪微博客户端用户信息、热点话题及评论 (上)
转载自:http://blog.csdn.net/eastmount/article/details/51231852 一. 文章介绍 源码下载地址:http://download.csdn.net/ ...
- from appium import webdriver 使用python爬虫,批量爬取抖音app视频(requests+Fiddler+appium)
使用python爬虫,批量爬取抖音app视频(requests+Fiddler+appium) - 北平吴彦祖 - 博客园 https://www.cnblogs.com/stevenshushu/p ...
- Python爬虫之爬取站内所有图片
title date tags layut Python爬虫之爬取站内所有图片 2018-10-07 Python post 目标是 http://www.5442.com/meinv/ 如需在非li ...
- python爬虫实战---爬取大众点评评论
python爬虫实战—爬取大众点评评论(加密字体) 1.首先打开一个店铺找到评论 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经 ...
- Python爬虫之爬取淘女郎照片示例详解
这篇文章主要介绍了Python爬虫之爬取淘女郎照片示例详解,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友们下面随着小编来一起学习学习吧 本篇目标 抓取淘宝MM ...
- python爬虫项目-爬取雪球网金融数据(关注、持续更新)
(一)python金融数据爬虫项目 爬取目标:雪球网(起始url:https://xueqiu.com/hq#exchange=CN&firstName=1&secondName=1_ ...
- Python 2.7_爬取CSDN单页面博客文章及url(二)_xpath提取_20170118
上次用的是正则匹配文章title 和文章url,因为最近在看Scrapy框架爬虫 需要了解xpath语法 学习了下拿这个例子练手 1.爬取的单页面还是这个rooturl:http://blog.csd ...
- Python 2.7_爬取CSDN单页面利用正则提取博客文章及url_20170114
年前有点忙,没来的及更博,最近看爬虫正则的部分 巩固下 1.爬取的单页面:http://blog.csdn.net/column/details/why-bug.html 2.过程 解析url获得网站 ...
随机推荐
- solr常见错误
这两天给客户部署独立的solr服务器遇到的错误,现在总结一下. 1. org.apache.solr.client.solrj.SolrServerException: Error executing ...
- springboot: xercesImpl.jar和xml-apis.jar (系统找不到指定的文件)
springboot内置的tomcat为8.5.23, tomcat在8.5.2 中 修改了加载jar的方式,8.5.2 版本会解析jar中MANIFEST.MF文件,当该文件包含class-path ...
- Jmeter参数化之数据库读取数据
以读取mysql数据库为例 1.下载一个mysql驱动包,最好去mysql官网下载 下载网址:https://dev.mysql.com/downloads/connector/j/ Select O ...
- 【linux】查看某个进程PID对应的文件句柄数量,查看某个进程当前使用的文件句柄数量
================================ 1.linux所有句柄查询 lsof -n|awk '{print $2}'|sort|uniq -c |sort -nr|more ...
- 单片机成长之路(51基础篇) - 023 N76e003 系统时钟切换到外部时钟
N76e003切换到外部时钟的资料很少(因为N76e003的片子是不支持无源晶振的,有源晶振的成本又很高,所以网上很少有对N76e003的介绍).有图有真相: 代码如下: main.c #includ ...
- C#中的System.Type和System.RuntimeType之间的区别
string str = string.Empty; Type strType = str.GetType(); Type strTypeType = strType.GetType(); strTy ...
- ThinkPHP各个目录是什么含义ThinkPHP怎么安装和使用
最近kdchxue看完了smarty之后,想学习下框架,于是乎就选择了ThinkPHP,听说这个框架简单易用,另外还是国产的!所以kdchxue毫不犹豫的就选择了ThinkPHP 了!下面看看Thin ...
- 解决:The web application [] registered the JDBC driver [] but failed to unregister it when the web application was stopped. To prevent a memory leak, the JDBC Driver has been forcibly unregistered.
问题描述 在将Spring Boot程序打包生成的war包部署到Tomcat后,启动Tomcat时总是报错,但是直接在IDEA中启动Application或者用"java -jar" ...
- React路由安装使用和多种方式传参
安装路由 npm i react-router-dom -S 引入路由 import { BowserRouter as Router, Route, Switch, ... } from " ...
- Gin-Go学习笔记七:Gin-Web框架 布局页面
模板使用 页面布局 1> 一个html页面由:head部分,body部分,内部css,内部js,外联css,外联的js这几部分组成.因此,一个布局文件也就需要针对这些进行拆分. 2> ...