
Python 2.7_First_try_爬取阳光电影网_20161206
之前看过用Scrapy 框架建立项目爬取 网页解析时候用的Xpath进行解析的网页元素 这次尝试用select方法匹配元素
1、入口爬取页面 http://www.ygdy8.com/index.html
2、用到模块 requests(网页源码下载) BeautifulSoup4(网页解析)
3、思路:首先由入口爬取页面进行获取网页上方栏目及对应url 如下图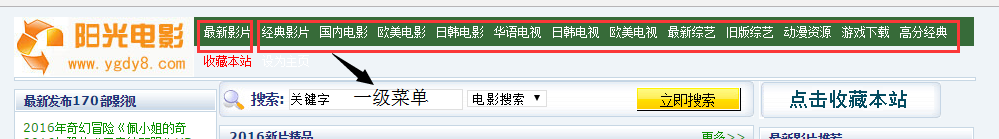
4、建立菜单url列表 for 循环再次进行解析 爬取每个一级菜单下的具体电影title 和url
5、问题:每个菜单下的url 进行再次解析后 由于网站内容不同 select 元素会出现非电影标题的连接和标题
6、python 代码
#coding:utf-8

import requests

from bs4 import BeautifulSoup as bs

#爬取入口

rooturl="http://www.ygdy8.com/index.html"

#获取网页源码

res=requests.get(rooturl)

#网站编码gb2312

res.encoding='gb2312'

#网页源码

html=res.text

soup=bs(html,'html.parser')

cate_urls = []

for cateurl in soup.select('.contain ul li a'):

    #网站分类标题

    cate_name=cateurl.text

    #分类url 进行再次爬取

    cate_url="http://www.ygdy8.com/"+ cateurl['href']

    cate_urls.append(cate_url)

    print "网站一级菜单:",cate_name,"菜单网址:",cate_url

#每个菜单url 解析

for i in range(len(cate_urls)):

    cate_listurl=cate_urls[i]

    res = requests.get(cate_listurl)

    res.encoding = 'gb2312'

    html = res.text

    soup = bs(html, 'html.parser')

    print "正在解析第"+str(i+1)+"个链接",cate_urls[i]

    contenturls=[]

    contents=soup.select('.co_content8 ul')[0].select('a')

    #print contents

    for title in contents:

        moivetitle=title.text

        moiveurl=title['href']

        contenturls.append(moiveurl)

        print moivetitle,moiveurl

print contenturls
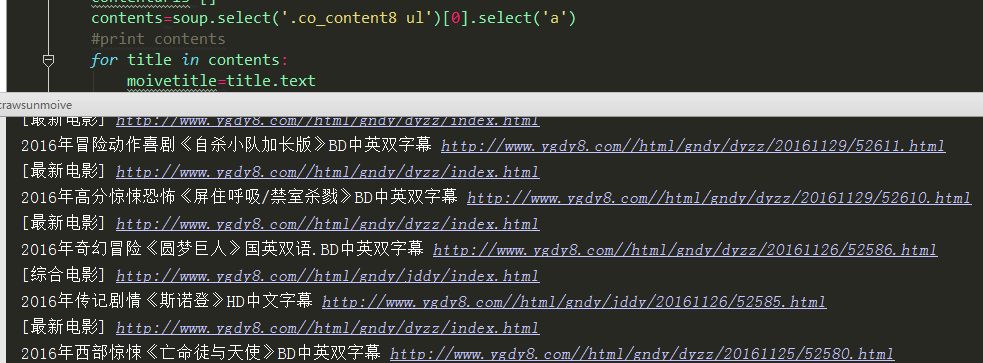
8、运行结果

Python 2.7_First_try_爬取阳光电影网_20161206的更多相关文章
- Python 2.7_Second_try_爬取阳光电影网_获取电影下载地址并写入文件 20161207
1.昨天文章http://www.cnblogs.com/Mr-Cxy/p/6139705.html 是获取电影网站主菜单 然后获取每个菜单下的电影url 2.今天是对电影url 进行再次解析获取下 ...
- scrapy爬取阳光电影网全站资源
说一下我的爬取过程吧 第一步: 当然是 scrapy startproject + 名字 新建爬虫项目 第二步: scrapy genspider -t crawl +爬虫名字+ 所爬取网站的 ...
- Python 3.6 爬取BD电影网
2018-07-10 #coding:utf-8 #coding:utf-8 from lxml import etree import requests import pandas import t ...
- 利用Python网络爬虫爬取学校官网十条标题
利用Python网络爬虫爬取学校官网十条标题 案例代码: # __author : "J" # date : 2018-03-06 # 导入需要用到的库文件 import urll ...
- 零基础Python爬虫实现(爬取最新电影排行)
提示:本学习来自Ehco前辈的文章, 经过实现得出的笔记. 目标网站 http://dianying.2345.com/top/ 网站结构 要爬的部分,在ul标签下(包括li标签), 大致来说迭代li ...
- python爬虫:爬取易迅网价格信息,并写入Mysql数据库
本程序涉及以下方面知识: 1.python链接mysql数据库:http://www.cnblogs.com/miranda-tang/p/5523431.html 2.爬取中文网站以及各种乱码处 ...
- 用python爬虫简单爬取 笔趣网:类“起点网”的小说
首先:文章用到的解析库介绍 BeautifulSoup: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索.修改分析树等功能. 它是一个工具箱,通过解析文档为用户提供 ...
- Python爬虫项目--爬取猫眼电影Top100榜
本次抓取猫眼电影Top100榜所用到的知识点: 1. python requests库 2. 正则表达式 3. csv模块 4. 多进程 正文 目标站点分析 通过对目标站点的分析, 来确定网页结构, ...
- python实战项目 — 爬取 校花网图片
重点: 1. 指定路径创建文件夹,判断是否存在 2. 保存图片文件 # 获得校花网的地址,图片的链接 import re import requests import time import os ...
随机推荐
- mysql控制台操作
显示表结构 : show create table table_name 复制表:insert into table_name1 select * from table_name2
- java SpringUtil获取bean
package com.whaty.framework.common.spring; import java.io.PrintStream; import org.springframework.be ...
- CDH自己安装方式Hbase master备份方式
hbase-daemon.sh start master 启动改命令会默认产生Hmaster 进程,等待主机宕机,zookeepr 监控
- JSBinding+SharpKit / JavaScript调试
注意: 1 Firefox 的版本用41 2 我发现调试很难用的,现在我都用打印 步骤参考图:
- Mysql分区简述
1. 数据量大的时候 mysql分表非常常用,但是mysql还可以分区. 2. 分区就是把同一张表放在不同的磁盘文件上, 当查询的时候首先定位是哪个分区(查询的时候一定要用到分区的key) 3. 分区 ...
- 线下线上对接的一种思路(本地erp与线上电子商务平台对接)
目前很多公司都希望本地的ERP能够与线上的电子商务平台进行对接. 但是很多的线下ERP系统商不愿意修改代码来做相应的对接,或者觉得太话费成本. 而对于企业本身,又会有很多的特殊需求. 下面略述一家进口 ...
- [转]App Store 审核、限时免费、排行、推荐机制技巧精华汇总
在 App Store 上,什么样的应用会得到推荐? 这个问题问的非常大,而且编辑推荐很多个人元素在里面,我试着用推荐Ovi Store应用的思路来回答一下: 关于应用: 1.首先这个应用最基本的功能 ...
- 关于查询扩展版ESI高被引论文的说明
https://yunpan.cn/ckk5RFV5Emvee 访问密码 e3f7
- UML精粹2 - 开发过程
迭代和瀑布过程 两者的本质区别是,你如何将一个项目分解为更小块. 瀑布风格基于活动来分解项目.为了构建软件,你不得不做某些活动:需求分析.设计.编码和测试.为期一年的项目可能有2个月的分析阶段,然后是 ...
- Angular(1)
1.设计原则 1.YAGNI 不要把未来需求引入当前工程 2.KISS keep it simple and stupid 语义化标记 合理注释 符合规定的命名 3.DRY(don't re ...