
Python 手写数字识别-knn算法应用
在上一篇博文中,我们对KNN算法思想及流程有了初步的了解,KNN是采用测量不同特征值之间的距离方法进行分类,也就是说对于每个样本数据,需要和训练集中的所有数据进行欧氏距离计算。这里简述KNN算法的特点:
优点:精度高,对异常值不敏感,无数据输入假定

缺点:计算复杂度高,空间复杂度高

适用数据范围:数值型和标称型(具有有穷多个不同值,值之间无序)
knn算法代码:
#-*- coding: utf-8 -*-

from numpy import *

import operator
import time
from os import listdir

def classify(inputPoint,dataSet,labels,k):

    dataSetSize = dataSet.shape[0]     #已知分类的数据集(训练集)的行数

    #先tile函数将输入点拓展成与训练集相同维数的矩阵,再计算欧氏距离

    diffMat = tile(inputPoint,(dataSetSize,1))-dataSet  #样本与训练集的差值矩阵

    sqDiffMat = diffMat ** 2                    #差值矩阵平方

    sqDistances = sqDiffMat.sum(axis=1)         #计算每一行上元素的和

    distances = sqDistances ** 0.5              #开方得到欧拉距离矩阵

    sortedDistIndicies = distances.argsort()    #按distances中元素进行升序排序后得到的对应下标的列表

    #选择距离最小的k个点

    classCount = {}

    for i in range(k):

        voteIlabel = labels[ sortedDistIndicies[i] ]

        classCount[voteIlabel] = classCount.get(voteIlabel,0)+1

    #按classCount字典的第2个元素(即类别出现的次数)从大到小排序

    sortedClassCount = sorted(classCount.items(), key = operator.itemgetter(1), reverse = True)

    return sortedClassCount[0][0]
下面介绍如何使用knn算法对手写识别数据进行分类,这里构造的分类系统只能识别数字0到9,数字经图形处理软件处理成具有相同的色彩和大小,宽高为32x32像素,为了便于处理,已将图像转换为文本格式,其效果图如下:
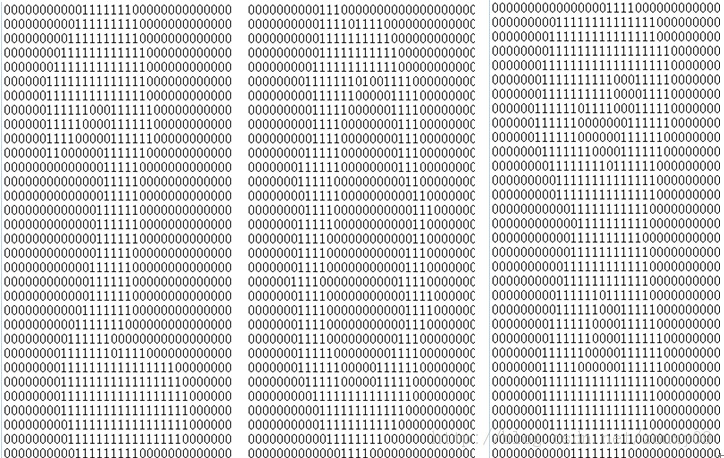
数据集可在这里下载,解压后有两个目录,其中目录trainingDigits中包含了1934个例子,命名规则如 9_45.txt,表示该文件的分类是9,是数字9的第45个实例,每个数字大概有200个实例。testDigits目录中包含946个例子。使用trainingDigits中的数据作为训练集,使用testDigits中的数据作为测试集测试分类的效果。两组数据没有重叠。
算法应用步骤如下:
1. 数据准备:数字图像文本向量化,这里将32x32的二进制图像文本矩阵转换成1x1024的向量。循环读出文件的前32行,存储在向量中。
#文本向量化 32x32 -> 1x1024
def img2vector(filename):

    returnVect = []

    fr = open(filename)

    for i in range(32):

        lineStr = fr.readline()

        for j in range(32):

            returnVect.append(int(lineStr[j]))

    return returnVect
2. 构建训练数据集:利用目录trainingDigits中的文本数据构建训练集向量,以及对应的分类向量
#从文件名中解析分类数字

def classnumCut(fileName):

   fileStr = fileName.split('.')[0]

    classNumStr = int(fileStr.split('_')[0])

    return classNumStr

#构建训练集数据向量,及对应分类标签向量

def trainingDataSet():

    hwLabels = []

    trainingFileList = listdir('trainingDigits')           #获取目录内容

    m = len(trainingFileList)

    trainingMat = zeros((m,1024))                          #m维向量的训练集

    for i in range(m):

        fileNameStr = trainingFileList[i]

        hwLabels.append(classnumCut(fileNameStr))

        trainingMat[i,:] = img2vector('trainingDigits/%s' % fileNameStr)

    return hwLabels,trainingMat
3. 测试集数据测试:通过测试testDigits目录下的样本,来计算算法的准确率。
#测试函数

def handwritingTest():

    hwLabels,trainingMat = trainingDataSet()    #构建训练集

    testFileList = listdir('testDigits')        #获取测试集

    errorCount = 0.0                            #错误数

    mTest = len(testFileList)                   #测试集总样本数

    t1 = time.time()

    for i in range(mTest):

        fileNameStr = testFileList[i]

        classNumStr = classnumCut(fileNameStr)

        vectorUnderTest = img2vector('testDigits/%s' % fileNameStr)

     #调用knn算法进行测试

        classifierResult = classify(vectorUnderTest, trainingMat, hwLabels, 3)

        print "the classifier came back with: %d, the real answer is: %d" % (classifierResult, classNumStr)

        if (classifierResult != classNumStr): errorCount += 1.0

    print "\nthe total number of tests is: %d" % mTest               #输出测试总样本数

    print "the total number of errors is: %d" % errorCount           #输出测试错误样本数

    print "the total error rate is: %f" % (errorCount/float(mTest))  #输出错误率

    t2 = time.time()

    print "Cost time: %.2fmin, %.4fs."%((t2-t1)//60,(t2-t1)%60)      #测试耗时

if __name__ == "__main__":

    handwritingTest()
运行结果如下:
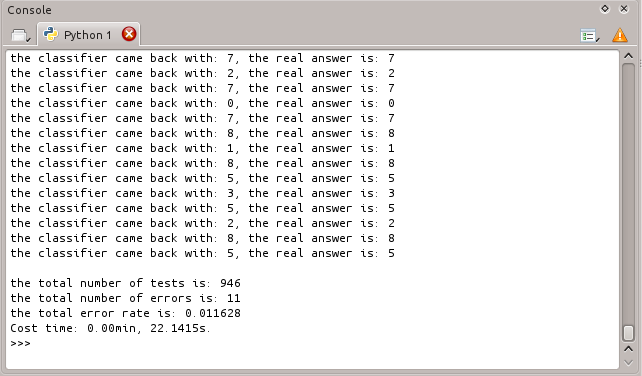
利用knn算法识别手写数字数据集,错误率为1.6%,算法的准确率还算可观。也可以通过改变变量k的值,观察错误率的变化,关于k值的选择,一般取一个比较小的数值,例如采用交叉验证法(简单来说,就是一部分样本做训练集,一部分做测试集)来选择最优的K值。
通过运行以上代码,我们会发现knn算法的执行效率并不高,因为算法需要为每个测试向量计算约2000次欧氏距离,每个距离计算包括1024个维度浮点运算,全部样本要执行900多次,可见算法实际耗时长,另外,knn算法必须保存全部数据集,每次需为测试向量准备2MB的存储空间(2个1024x1024矩阵的空间)。所以如何优化算法,减少存储空间和计算时间的开销,需要我们进一步深入学习。
参考资料:
《机器学习实战》
Python 手写数字识别-knn算法应用的更多相关文章
- 一看就懂的K近邻算法(KNN),K-D树,并实现手写数字识别!
1. 什么是KNN 1.1 KNN的通俗解释 何谓K近邻算法,即K-Nearest Neighbor algorithm,简称KNN算法,单从名字来猜想,可以简单粗暴的认为是:K个最近的邻居,当K=1 ...
- 基于OpenCV的KNN算法实现手写数字识别
基于OpenCV的KNN算法实现手写数字识别 一.数据预处理 # 导入所需模块 import cv2 import numpy as np import matplotlib.pyplot as pl ...
- Kaggle竞赛丨入门手写数字识别之KNN、CNN、降维
引言 这段时间来,看了西瓜书.蓝皮书,各种机器学习算法都有所了解,但在实践方面却缺乏相应的锻炼.于是我决定通过Kaggle这个平台来提升一下自己的应用能力,培养自己的数据分析能力. 我个人的计划是先从 ...
- 机器学习(二)-kNN手写数字识别
一.kNN算法是机器学习的入门算法,其中不涉及训练,主要思想是计算待测点和参照点的距离,选取距离较近的参照点的类别作为待测点的的类别. 1,距离可以是欧式距离,夹角余弦距离等等. 2,k值不能选择太大 ...
- 手写数字识别 ----卷积神经网络模型官方案例注释(基于Tensorflow,Python)
# 手写数字识别 ----卷积神经网络模型 import os import tensorflow as tf #部分注释来源于 # http://www.cnblogs.com/rgvb178/p/ ...
- 手写数字识别 ----Softmax回归模型官方案例注释(基于Tensorflow,Python)
# 手写数字识别 ----Softmax回归模型 # regression import os import tensorflow as tf from tensorflow.examples.tut ...
- [Python]基于CNN的MNIST手写数字识别
目录 一.背景介绍 1.1 卷积神经网络 1.2 深度学习框架 1.3 MNIST 数据集 二.方法和原理 2.1 部署网络模型 (1)权重初始化 (2)卷积和池化 (3)搭建卷积层1 (4)搭建卷积 ...
- kaggle 实战 (1): PCA + KNN 手写数字识别
文章目录 加载package read data PCA 降维探索 选择50维度, 拆分数据为训练集,测试机 KNN PCA降维和K值筛选 分析k & 维度 vs 精度 预测 生成提交文件 本 ...
- C#中调用Matlab人工神经网络算法实现手写数字识别
手写数字识别实现 设计技术参数:通过由数字构成的图像,自动实现几个不同数字的识别,设计识别方法,有较高的识别率 关键字:二值化 投影 矩阵 目标定位 Matlab 手写数字图像识别简介: 手写 ...
随机推荐
- JS中的各种类型转换规则(转)
JS中的类型转换非常恶心,大家都懂的,不过该学还是要学. 今天看犀牛书看到了转换规则,总结出来. X转字符串.数字.布尔值 X表示各种类型的值,直接上图: 值 转数字 转字符串 转布尔值 undefi ...
- 翻译:打造基于Sublime Text 3的全能python开发环境
原文地址:https://realpython.com/blog/python/setting-up-sublime-text-3-for-full-stack-python-development/ ...
- TCP/IP协议学习(三) STM32中ETH驱动配置注意事项
1.MII/RMII/SMI接口连接和配置 SMI又称站点管理接口,用于cpu与外置PHY芯片通讯,配置相关参数,包含MDC和MDIO两个管脚(CPU上有对应引脚,当然用普通GPIO口模拟SMI管理也 ...
- 20160928_CentOS6.4x64_Oracle11gR2x64
1.“Oracle Database 11g Release 2” 下载地址: http://www.oracle.com/technetwork/database/enterprise-editio ...
- table表格中实现tbody部分可滚动,且thead部分固定
1.想要实现表格的thead部分固定切tbody部分可滚动,就需要将thead与tbody进行分离,具体做法是 1.设置thead,tbody都为display:block: 2.设置th与td的宽度 ...
- AngularJS: 'Template for directive must have exactly one root element' when using 'th' tag in directive template
.controller('HomeController', function($scope,$location) { $scope.userName='天下大势,为我所控!'; $scope.clkU ...
- “LC.exe”已退出,代码为 -1
造成这个问题的原因一般是引入了第三方插件,自己遇到的问题是引入了devexpress...... 1.找到Properties文件夹licenses.licx文件,然后右键选择删除就可以了,调试运行正 ...
- roscpp
不服气不行,写ROS这伙就是比我知道的库函数多 inti函数:初始化节点是简单读些命令行参数和环境配置来配置节点名呀,命名空间呀和命名重映射之类东西. 其是在roscpp里面解释很清楚了,只是,我当时 ...
- hdu 1032
题目的意思是把输入的i,j 从i到j的每一个数 做循环,输出循环次数最大的值 易错的地方:做循环是容易直接用i进行计算 i=i/2:或i=i*3+1: 这样i的值改变就不能在做下面数的循环 #incl ...
- Octopus系列之代码备份
代码 $.extend($.validator.messages, { required: "This field is required.", remote: "Ple ...