
hbase-2.0.4集群部署
hbase-2.0.4集群部署
1. 集群节点规划:
rzx1	HMaster,HRegionServer

rzx2	HRegionServer

rzx3	HRegionServer
前提:搭建好hadoop集群
2. 在rzx1节点上配置执行环境的JAVA_HOME和是否利用自带Zookeeper
在hbase目录下:vim conf/hbase-env.sh
export JAVA_HOME=/home/bigdata/software/jdk1.8.0_201

export HBASE_MANAGES_ZK=false ##不使用自带Zookeeper
其他配置参数在配置开发测试集群使用默认,生产环境根据数据量而定配置
3. 在rzx1节点上配置hbase在HDFS上存储的路径和外部zookeeper地址
在hbase目录下:vim conf/ hdfs-site.xml
<configuration>

<!-- 指定hbase在HDFS上存储的路径 -->

<property>

<name>hbase.rootdir</name>

     <value>hdfs://rzx1:9000/hbase</value>

</property>

<!-- 指定hbase是分布式的 -->

<property>

      <name>hbase.cluster.distributed</name>

      <value>true</value>

 </property>

 <!-- 指定zk的地址,多个用“,”分割 -->

 <property>

 	  <name>hbase.zookeeper.quorum</name>

       <value>rzx1,rzx2,rzx3</value>

 </property>

</configuration>
注意在配置zk的时候只配置域名或IP就可以了,不要配置端口如rzx1:2181这样配置虽然对zookeeper启动没有任何影响,但是之后如果搭建kylin集群会报错的
4. 将hadoop etc/hadoop下的core-site.xml,hdfs-site.xml复制到hbase conf/下
在hbase目录下(hbase和hadoop同级目录)
cp  ../hadoop-2.7.7/etc/hadoop/core-site.xml  conf/

cp  ../hadoop-2.7.7/etc/hadoop/core-site.xml  conf/
因为hbase的数据本质上存储在hdfs的,且hbase执行引擎是MapReduce
5. 配置HRegionServer,修改 regionservers文件
在hbase目录下:vim conf/regionservers
rzx1

rzx2

rzx3
如果想rzx1上只是HMaster,则配rzx2,rzx3即可
6. 在主节点rzx1上将配置好的hbase目录scp到rzx2,rzx3上
在hbase目录的上层目录下:
scp  -r  hbase-2.0.4 root@rzx1:/home/bigdata/software/

scp  -r  hbase-2.0.4 root@rzx2:/home/bigdata/software/
7. 在三个节点上都配置hbase环境变量
前提:已经配置好java, hadoop, hive,zookeeper环境变量
vim ~/.bashrc添加:
export HBASE_HOME=/home/bigdata/software/hbase-2.0.4

export PATH=$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$HIVE_HOME/bin:$ZK_HOME/bin:$KAFKA_HOME/bin:$HBASE_HOME/bin:$HCAT_HOME/bin:$KYLIN_HOME/bin:$PATH
8. 在主节点上启动hbase
前提:已经正确启动zookeeper集群
start-hbase.sh
9. jps查看进程
rzx1节点上应该有: HMaster, HRegionServer这两个进程
rzx2,rzx3节点上只有HRegionServer一个进程
10. 启动无误后可以访问hbase web UI界面: http://rzx1:16010/master-status
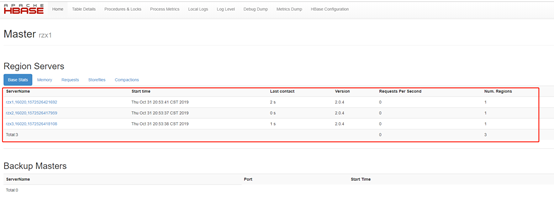
主要查看ServerName是否和预期一致,也就是配置的HRegionServer
说明:这里只是简易的开发测试集群搭建配置,实际数据量过大的生产环境配置可能相对复杂些
hbase-2.0.4集群部署的更多相关文章
- redis3.0.5集群部署安装详细步骤
Redis集群部署文档(centos6系统) (要让集群正常工作至少需要3个主节点,在这里我们要创建6个redis节点,其中三个为主节点,三个为从节点,对应的redis节点的ip和端口对应关系如下) ...
- Storm1.0.3集群部署
Storm集群部署 所有集群部署的基本流程都差不多:下载安装包并上传.解压安装包并配置环境变量.修改配置文件.分发安装包.启动集群.查看集群是否部署成功. 1.所有的集群上都要配置hosts vi ...
- HBase HA的分布式集群部署(适合3、5节点)
本博文的主要内容有: .HBase的分布模式(3.5节点)安装 .HBase的分布模式(3.5节点)的启动 .HBase HA的分布式集群的安装 .HBase HA的分布式集群的启动 .H ...
- 1--redis3.0.5集群部署安装详细步骤
Redis集群部署文档(centos6系统) (要让集群正常工作至少需要3个主节点,在这里我们要创建6个redis节点,其中三个为主节点,三个为从节点,对应的redis节点的ip和端口对应关系如下) ...
- redis-5.0.5 集群部署
之前写过一套基于redis-4.0.6版本的测试集群部署 https://www.cnblogs.com/mrice/p/10730309.html 最近生产环境需要部署一套redis-5.0.5版本 ...
- redis 3.0的集群部署
转载请注明出处:http://hot66hot.iteye.com/admin/blogs/2050676 最近研究redis-cluster,正好搭建了一个环境,遇到了很多坑,系统的总结下,等到re ...
- (转)redis 3.0的集群部署
一:关于redis cluster 1:redis cluster的现状 reids-cluster计划在redis3.0中推出,可以看作者antirez的声明:http://antirez.com/ ...
- redis3.0.7集群部署手册
1.用root登录主机2.将redis-3.0.7.tar.gz传送到主机3.将rubygems-update-2.5.2.gem,redis-3.0.0.gem传送到主机4.解压redis-3.0. ...
- linux下redis4.0.2集群部署(利用Ruby脚本命令)
一.原生命令方式和Ruby脚本方式区别 利用Ruby脚本部署和用原生命令部署,节点准备的步骤都是一样的,节点启动后的握手,以及主从.槽分配,利用Ruby脚本一步就能完成,利用原生命令需要一步一步地执行 ...
随机推荐
- vue中Template 制作模版
一.直接写在选项里的模板 直接在构造器里的template选项后边编写.这种写法比较直观,但是如果模板html代码太多,不建议这么写. javascript代码: var app=new Vue({ ...
- JUC线程池
原创转载请注明出处:https://www.cnblogs.com/agilestyle/p/11443644.html newFixedThreadPool 重用指定数目(nThreads)的线程, ...
- Axure 部件的交互样式
选中的 时 需要设置事件
- C变量
C 变量 变量其实只不过是程序可操作的存储区的名称.C 中每个变量都有特定的类型,类型决定了变量存储的大小和布局,该范围内的值都可以存储在内存中,运算符可应用于变量上. 变量的名称可以由字母.数字和下 ...
- nginx的基础概念
http://tengine.taobao.org/book/index.html 算是看书笔记吧,太多了就用自己的话写一下了 nginx是以多进程 的方式来工作的,启动时会有一个master进程 ...
- Android程序中欢迎界面
额,在做项目中,肯定首先要用到欢迎界面,下面是我在做项目中用的最简单的一个欢迎界面,即打开程序时,先是显示一张图片,然后等一段时间后图片消失,进入登录界面.直接上代码,有注释也不用解释了: 首先是We ...
- kafka manager遇到的一些问题
1.启动后第一个报错如下: [error] k.m.a.c.BrokerViewCacheActor - Failed to get broker metrics for BrokerIdentity ...
- mysql存储过程、函数、触发器、
当数据库版本不允许直接使用存储过程.函数的语法时用delimiter // 将结束符改成//用完之后再写delimiter;将结束符改回来即可,调用过程.函数用call+其名字即可返回结果 delim ...
- Apache的虚拟主机功能(基于IP、域名、端口号)
Apache虚拟主机就是在一个Apache服务器上配置多个虚拟主机,实现一个服务器提供多站点服务,其实就是访问同一个服务器上的不同目录. 主要有三种方法: 1.通过不同的IP地址 2.通过不同的域名 ...
- GNU Linux 64汇编学习
函数调用传参: 第一个参数:rdi, 第二个参数:rsi 函数调用栈结构: 返回值 第一个参数 第二个参数 +----------+ rsp-24 | a | +----------+ rsp-16 ...