
Caffe学习系列(4):激活层(Activiation Layers)及参数
在激活层中,对输入数据进行激活操作(实际上就是一种函数变换),是逐元素进行运算的。从bottom得到一个blob数据输入,运算后,从top输入一个blob数据。在运算过程中,没有改变数据的大小,即输入和输出的数据大小是相等的。
输入:n*c*h*w
输出:n*c*h*w
常用的激活函数有sigmoid, tanh,relu等,下面分别介绍。
1、Sigmoid
对每个输入数据,利用sigmoid函数执行操作。这种层设置比较简单,没有额外的参数。

层类型:Sigmoid
示例:
layer {

  name: "encode1neuron"

  bottom: "encode1"

  top: "encode1neuron"

  type: "Sigmoid"

}
2、ReLU / Rectified-Linear and Leaky-ReLU
ReLU是目前使用最多的激活函数,主要因为其收敛更快,并且能保持同样效果。
标准的ReLU函数为max(x, 0),当x>0时,输出x; 当x<=0时,输出0
f(x)=max(x,0)
层类型:ReLU
可选参数:
negative_slope:默认为0. 对标准的ReLU函数进行变化,如果设置了这个值,那么数据为负数时,就不再设置为0,而是用原始数据乘以negative_slope
layer {

  name: "relu1"

  type: "ReLU"

  bottom: "pool1"

  top: "pool1"

}
RELU层支持in-place计算,这意味着bottom的输出和输入相同以避免内存的消耗。
3、TanH / Hyperbolic Tangent
利用双曲正切函数对数据进行变换。
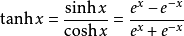
层类型:TanH
layer {

  name: "layer"

  bottom: "in"

  top: "out"

  type: "TanH"

}
4、Absolute Value
求每个输入数据的绝对值。
f(x)=Abs(x)
层类型:AbsVal
layer {

  name: "layer"

  bottom: "in"

  top: "out"

  type: "AbsVal"

}
5、Power
对每个输入数据进行幂运算
f(x)= (shift + scale * x) ^ power
层类型:Power
可选参数:
power: 默认为1
scale: 默认为1
shift: 默认为0
layer {

  name: "layer"

  bottom: "in"

  top: "out"

  type: "Power"

  power_param {

    power: 2

    scale: 1

    shift: 0

  }

}
6、BNLL
binomial normal log likelihood的简称
f(x)=log(1 + exp(x))
层类型:BNLL
layer {

  name: "layer"

  bottom: "in"

  top: "out"

  type: “BNLL”

}
Caffe学习系列(4):激活层(Activiation Layers)及参数的更多相关文章
- Caffe学习系列(3):视觉层(Vision Layers)及参数
所有的层都具有的参数,如name, type, bottom, top和transform_param请参看我的前一篇文章:Caffe学习系列(2):数据层及参数 本文只讲解视觉层(Vision La ...
- 转 Caffe学习系列(3):视觉层(Vision Layers)及参数
所有的层都具有的参数,如name, type, bottom, top和transform_param请参看我的前一篇文章:Caffe学习系列(2):数据层及参数 本文只讲解视觉层(Vision La ...
- Caffe 学习系列
学习列表: Google protocol buffer在windows下的编译 caffe windows 学习第一步:编译和安装(vs2012+win 64) caffe windows学习:第一 ...
- Caffe学习系列(23):如何将别人训练好的model用到自己的数据上
caffe团队用imagenet图片进行训练,迭代30多万次,训练出来一个model.这个model将图片分为1000类,应该是目前为止最好的图片分类model了. 假设我现在有一些自己的图片想进行分 ...
- Caffe学习系列(12):训练和测试自己的图片
学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测试模型的整个流程. 一.准备数据 有条件的同学,可以去 ...
- 转 Caffe学习系列(12):训练和测试自己的图片
学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测试模型的整个流程. 一.准备数据 有条件的同学,可以去 ...
- Caffe学习系列——工具篇:神经网络模型结构可视化
Caffe学习系列——工具篇:神经网络模型结构可视化 在Caffe中,目前有两种可视化prototxt格式网络结构的方法: 使用Netscope在线可视化 使用Caffe提供的draw_net.py ...
- Caffe学习系列(12):训练和测试自己的图片--linux平台
Caffe学习系列(12):训练和测试自己的图片 学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测 ...
- Caffe学习系列(22):caffe图形化操作工具digits运行实例
上接:Caffe学习系列(21):caffe图形化操作工具digits的安装与运行 经过前面的操作,我们就把数据准备好了. 一.训练一个model 右击右边Models模块的” Images" ...
- Caffe学习系列(21):caffe图形化操作工具digits的安装与运行
经过前面一系列的学习,我们基本上学会了如何在linux下运行caffe程序,也学会了如何用python接口进行数据及参数的可视化. 如果还没有学会的,请自行细细阅读: caffe学习系列:http:/ ...
随机推荐
- 使用ObjectOutputStream进行socket通信的时候出现固定读到四个字节乱码的问题
问题描述: 最近在写一个通信相关的项目,服务器端和客户端通过socket进行通信.本来想利用read的阻塞特性,服务器端和客户端按照一定的流程进行文件读写.结果发现客户端或者服务器read方法一直都返 ...
- 多线程--毕向东java基础教程视频学习笔记
目录 1.多线程运行的安全问题 2.多线程同步代码块 3.同步方法的锁是this 4.静态同步方法的锁是Class对象 5.单例设计模式(面试中的考点) 6.死锁(一个发生死锁的例子) 多线程运行的安 ...
- Oracle instr函数与SqlServer charindex的区别
INSTR(C1,C2[,I[,J]]) [功能]在一个字符串中搜索指定的字符,返回发现指定的字符的位置; [说明]多字节符(汉字.全角符等),按1个字符计算 [参数] C1 被搜索的字符串 ...
- 设置IE兼容模式的几种方法
一.指定文件兼容性模式要为你的网页指定文件模式,需要在你的网页中使用meta元素放入x-ua-compatible http-equiv 标头.1. 强制ie8使用ie8模式来解析,而且那个兼容性视图 ...
- ajax跨域 自定义header问题总结
遇到的问题:已经在ajax里面添加自定义参数,但是没有生效 beforeSend : function(request) { request.setRequestHeader("region ...
- 第七篇 :微信公众平台开发实战Java版之如何获取微信用户基本信息
在关注者与公众号产生消息交互后,公众号可获得关注者的OpenID(加密后的微信号,每个用户对每个公众号的OpenID是唯一的.对于不同公众号,同一用户的openid不同). 公众号可通过本接口来根据O ...
- codeforces C. Triangle
C. Triangle time limit per test 1 second memory limit per test 256 megabytes input standard input ou ...
- SQL TUNNING
In a Nested Loops Join, for example, the first accessed table is called the outer table and the seco ...
- CentOS 7 安装Redis 2.8.7
1.下载软件: wget wget http://download.redis.io/releases/redis-2.8.7.tar.gz 2.解压软件并编译安装: tar -zxvf redis- ...
- codeforces 709A A. Juicer(水题)
题目链接: A. Juicer 题意: 给出n个橘子,汁漫出来了就倒出来,反正就是要求要倒几次; 思路: AC代码: #include <iostream> #include <cs ...