
Spark 概念学习系列之Spark存储管理机制
Spark存储管理机制
概要
01 存储管理概述
02 RDD持久化
03 Shuffle数据存储
04 广播变量与累加器
01 存储管理概述
思考:
RDD,我们可以直接使用而无须关心它的实现细节,RDD是Spark的基础,但是有个问题大家也许会比较关心:RDD所操作的数据究竟在哪里?它是如何存储的。
回顾:

1.1 、存储管理模块架构—从架构上来看
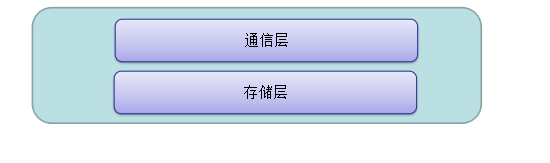
1.1.1 通信层
通信层面采用主从方式实现通信(主从节点间互换消息)
1.1.2 存储层
存储层负责提供接口来存储数据(可把数据存储到内存,磁盘,或者远端)
1.2 存储管理模块架构—从功能上来看
1.2.1 RDD缓存
整个存储管理模块主要的工作是作为RDD的缓存,包括基于内存和磁盘的缓存
1.2.2 Shuffle数据的持久化
Shuffle中间结果的数据也是交由存储管理模块进行管理的。Shuffle性能的好坏直接影响了Spark应用程序整体的性能,因此存储管理模块中对于Shuffle数据的处理有别于传统的RDD。
1.2.3 缓存
注意:还有其他数据的存储,请移步。见
储模块由操作类BlockManager统一对外提供服务
1.3 存储管理模块架构—通信层

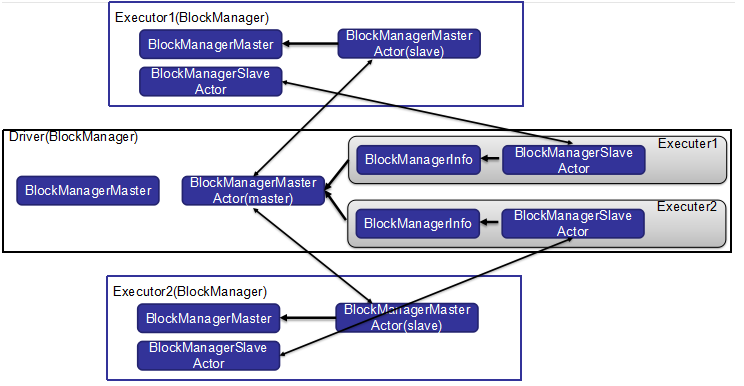
1.4 存储管理模块架构—通信层--BlockManager
(1)BlockManager类通过BlockManagerMaster进行通信;
(2)主节点的BlockManager会包含所有从节点的BlockManager信息;
(3)主从节点之间通过各自的BlockManagerMasterActor来进行相互通信;
1.5 存储管理模块架构—存储层

1.6 存储管理模块架构—数据块与分区的关系
我们知道,RDD是基于分区(partition)来计算的。
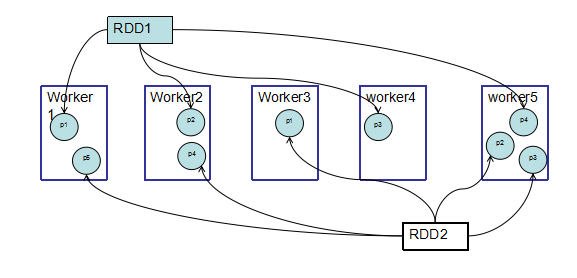
在存储管理中,存储是以block为单位的。实际上RDD的partition与block是一一对应的。他两是通过映射关系联系到一起的。
具体映射关系:block名=“rddID+分区索引号”。

02 RDD持久化
2.1 回顾—RDD控制操作
persist操作,可以将RDD持久化到不同层次的存储介质,以便后续操作重复使用。
1.cache:RDD[T]
2.persist:RDD[T]
3.persist(level:StorageLevel):RDD[T]
首次使用RDD的时候,我们可以选择对RDD进行持久化,当再次使用RDD是就可以直接从之前的缓存中获取而无需再次进行计算。对于需要反复使用的RDD会带来很大的性能改善。
2.2 持久化级别

2.3 如何选择持久化级别
首选MEMORY_ONLY;其次选MEMORY_ONLY_SER;
如果数据量大且重新计算的开销大,那就用MEMORY_AND_DISK;
如果要确保快速的恢复机制,那就选MEMORY_ONLY_2,
MEMORY_AND_DISK_2(因为有备份)
注意:具体选择时需要结合应用特点以及机器性能做出权衡
2.4 缓存淘汰机制
当数据超过缓存阈值时:Spark会丢弃一部分内存中的数据或者将一部分数据从内存移出到磁盘中(LRU),具体情况依据RDD的持久化选项。
如果是直接丢弃数据的话,程序会否报错呢?
答案是不一定的。如果被删除的数据的祖先是可被回溯到的,那么可以通过重新计算得到丢失的数据;相反,程序会报错哦。
RDD 还有一个方法叫作unpersist(),调用该方法可以手动把持久化的RDD 从缓存中移除
03 Shuffle数据持久化

shuffle数据必须是在磁盘上进行缓存,不能选择在内存中缓存;
RDD在磁盘持久化时一个block对应一个文件,而shuffle数据块只是逻辑上的概念,存储方式因实现方式不同而不同:0
默认将shuffle数据块,也就是一个bucket映射成文件(文件过多)
另外一种方式是将shuffle数据块映射成文件中的一段(将spark.shuffle.consolidateFiles设置为TRUE)
04、广播变量和累加器
4.1 广播变量--Broadcast Variables
实现数据在每个节点上都有一份拷贝
广播变量也是存储模块来管理的,以MEMORY_AND_DISK方式存储
 val signPrefixes = sc.broadcast(loadCallSignTable())

            val countryContactCounts = contactCounts.map{case (sign, count) =>

                val country = lookupInArray(sign, signPrefixes.value)

                (country, count)

            }.reduceByKey((x, y) => x + y)

            countryContactCounts.saveAsTextFile(outputDir + "/countries.txt")
4.2 累加器--Accumulators
提供了将工作节点中的值聚合到驱动器程序中的简单语法
    val sc = new SparkContext(...)

            val file = sc.textFile("file.txt")

            val blankLines = sc.accumulator() // 创建Accumulator[Int]并初始化为0

            val callSigns = file.flatMap(line => {

            if (line == "") {

            blankLines +=  // 累加器加1

            }

            line.split(" ")

            })

            callSigns.saveAsTextFile("output.txt")

            println("Blank lines: " + blankLines.value)
Spark 概念学习系列之Spark存储管理机制的更多相关文章
- Spark 概念学习系列之Spark 多语言编程
不多说,直接上干货! Spark 同时支持Scala.Python.Java 三种应用程序API编程接口和编程方式, 考虑到大数据处理的特性,一般会优先使用Scala进行编程,其次是Python,最后 ...
- Spark 概念学习系列之Spark基本概念和模型(十八)
打好基础,别小瞧它! spark的运行模式多种多样,在单机上既可以本地模式运行,也可以伪分布模式运行.而当以分布式的方式在集群中运行时.底层的资源调度可以使用Mesos或者Yarn,也可使用spark ...
- Spark 概念学习系列之Spark Core(十五)
不多说,直接上干货! 最关键的是转换算子Transformations和缓存算子Actions. 主要是对RDD进行操作. RDD Objects -> Scheduler(DAGSched ...
- Spark RDD概念学习系列之Spark Hash Shuffle内幕彻底解密(二十)
本博文的主要内容: 1.Hash Shuffle彻底解密 2.Shuffle Pluggable解密 3.Sorted Shuffle解密 4.Shuffle性能优化 一:到底什么是Shuffle? ...
- Spark Streaming概念学习系列之Spark Streaming容错
Spark Streaming容错 检查点机制-checkpoint 什么是检查点机制? Spark Streaming 周期性地把应用数据存储到诸如HDFS 或Amazon S3 这样的可靠存储系统 ...
- Spark RDD概念学习系列之Spark的算子的作用(十四)
Spark的算子的作用 首先,关于spark算子的分类,详细见 http://www.cnblogs.com/zlslch/p/5723857.html 1.Transformation 变换/转换算 ...
- Spark SQL概念学习系列之Spark SQL概述
很多人一个误区,Spark SQL重点不是在SQL啊,而是在结构化数据处理! Spark SQL结构化数据处理 概要: 01 Spark SQL概述 02 Spark SQL基本原理 03 Spark ...
- Spark RDD概念学习系列之Spark的算子的分类(十一)
Spark的算子的分类 从大方向来说,Spark 算子大致可以分为以下两类: 1)Transformation 变换/转换算子:这种变换并不触发提交作业,完成作业中间过程处理. Transformat ...
- Spark RDD概念学习系列之Spark的数据存储(十二)
Spark数据存储的核心是弹性分布式数据集(RDD). RDD可以被抽象地理解为一个大的数组(Array),但是这个数组是分布在集群上的. 逻辑上RDD的每个分区叫一个Partition. 在Spar ...
随机推荐
- Java 开发 2.0: 现实世界中的 Redis
原文地址:http://www.ibm.com/developerworks/cn/java/j-javadev2-22/ 之前,我已在本系列中讨论过 NoSQL 的概念,也介绍了一些与 Java 平 ...
- rowcount和@@rowcount的区别
1 rowcount rowcount的作用就是用来限定后面的sql在返回指定的行数之后便停止处理,比如下面的示例, set rowcount 10select * from 表A 这样的查询只会返回 ...
- 清空/var/adm/wtmp 文件内容
清/var/adm/wtmp 文件内容 用于显示登录系统和重启机器的情况 /var/adm/wtmp文件过大. 可用du -sm /var/adm/wtmp查看 cat /dev/null>/v ...
- 2017-2018年红头发新版Cisco认证网络工程师(CCNA-R&S)全新讲解分享
网名"红头发",多年授课经验,业内资深思科认证讲师,其所写的CISCO认证原创技术文章风靡各大网站与培训机构.精通CISCO各类路由交换产品,熟悉JUNIPER M/T系列路由产品 ...
- shell中IF的用法介绍
一.语法结构 if [ condition ] then statements [elif condition then statements. ..] [else ...
- tee---将数据重定向到文件,
tee命令用于将数据重定向到文件,另一方面还可以提供一份重定向数据的副本作为后续命令的stdin.简单的说就是把数据重定向到给定文件和屏幕上. 存在缓存机制,每1024个字节将输出一次.若从管道接收输 ...
- POJ 1006 Biorhythms (数论-中国剩余定理)
Biorhythms Time Limit: 1000MS Memory Limit: 10000K Total Submissions: 111285 Accepted: 34638 Des ...
- 62.C++文件操作list实现内存检索,实现两千万数据秒查
1 #include <iostream> #include <fstream> #include <cstdlib> #include <string> ...
- 分享一下10个常用jquery片段
1. 图片预加载 (function($) { var cache = []; // Arguments are image paths relative to the current page. ...
- 小米开源文件管理器MiCodeFileExplorer-源码研究(3)-使用最多的工具类Util
Util.java,使用最广泛~代码中很多地方,都写了注释说明~基本不需要怎么解释了~ package net.micode.fileexplorer.util; import java.io.Fil ...