
BeautifulSoup图片爬取
------------恢复内容开始------------
BeautifulSoup介绍:
简单来说,Beautiful Soup 是 python 的一个库,最主要的功能是从网页抓取数据。官方解释如下:
Beautiful Soup 提供一些简单的、python 式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。 Beautiful Soup 自动将输入文档转换为 Unicode 编码,输出文档转换为 utf-8 编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup 就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。 Beautiful Soup 已成为和 lxml、html6lib 一样出色的 python 解释器,为用户灵活地提供不同的解析策略或强劲的速度。
以下为爬取网页图片的例子:
爬取图片的网页地址:https://pic.netbian.com/4kdongman/
先创建一个requests的请求,然后使用BeautifulSoup的lxml HTML解析器去解析网页
url = 'https://pic.netbian.com/4kdongman/'

headers = {

    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/97.0.4692.71 Safari/537.36'

}

r = requests.get(url,headers=headers)
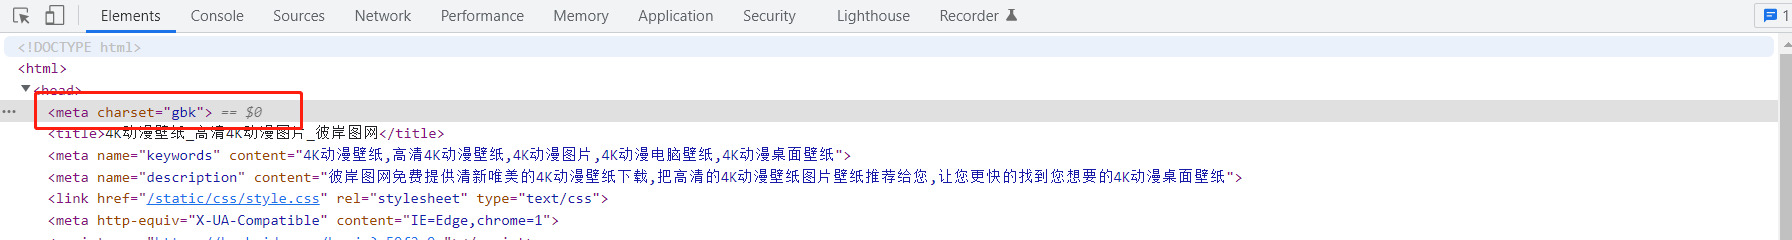
#设置编码为gbk,要不然会乱码
r.encoding='gbk'
#使用lxml解析器解析
soup = BeautifulSoup(r.text,'lxml')
编码格式可以从网页html中看到
接下来可以先定位到所有图片的整体div,例如class=’slist‘这个div,然后再定位每张图片的img标签,提取相关数据,得到每张图片的url地址
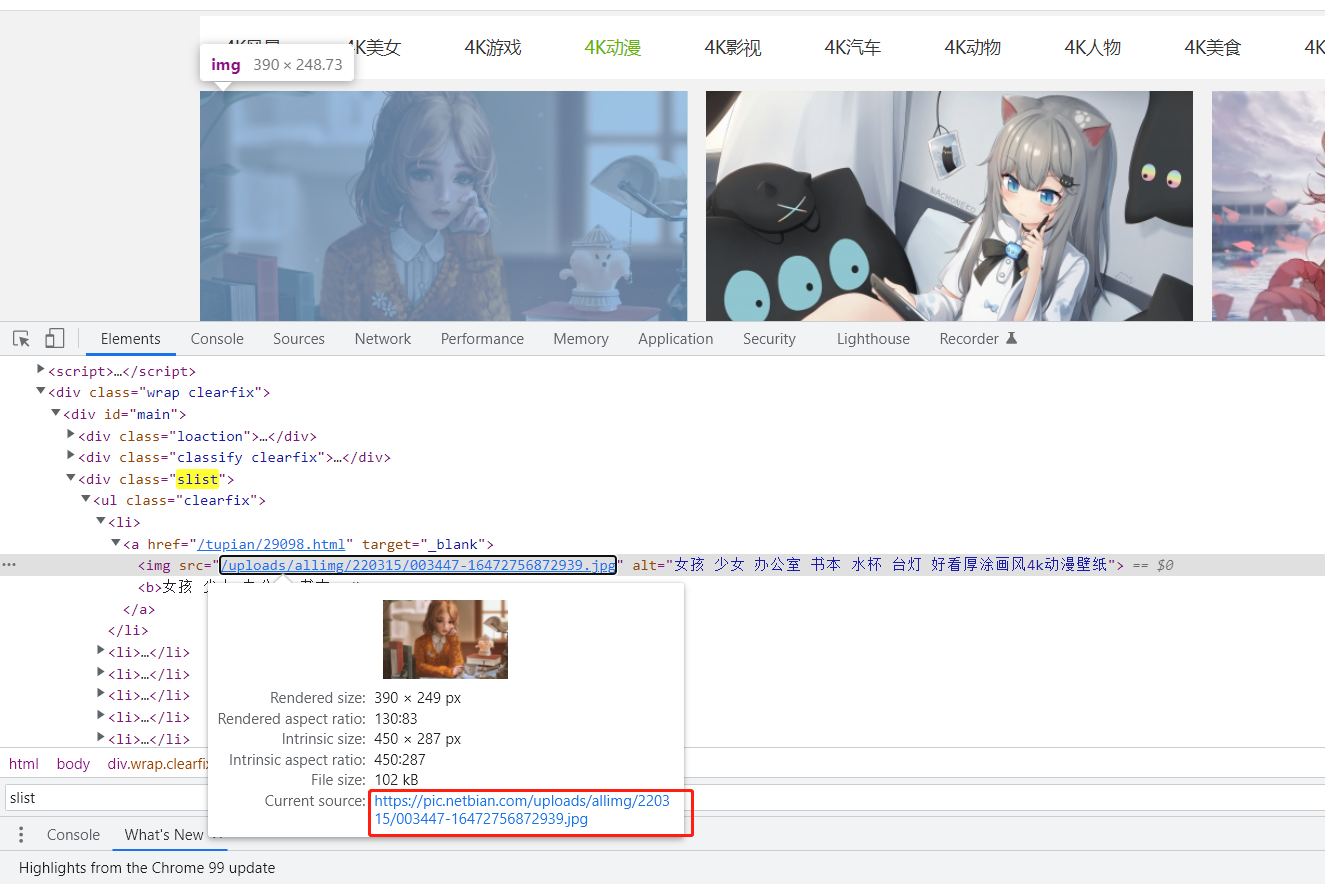
#定位所有图片的整体div
all_list = soup.find_all(attrs={'class': 'slist'})
#定位所有的img标签

img_list = all_list[0].find_all('img')
#遍历每个img标签

for img in img_list:

    img_url = img['src']

    name = img['alt']
  #拼接图片url地址

    img_url = 'https://pic.netbian.com' + img_url
  #图片名称

    print(name)
  #图片url

    print(img_url)
获取到每张图片的url地址后,就可以直接将其下载下来
方法一:with open直接将图片用字节流写入保存
 r_img = requests.get(img_url)

 with open('./img/'+name+'.jpg','wb+') as f:
#content返回的是二进制数据,如果你是取文本,你可以使用r.txt,如果取图片和文件,则是r.content

 f.write(r_img.content)
方法二:直接使用urllib.request.urlretrieve下载
#第一个参数为要下载文件的url,第二个参数为本地保存路径以及文件名的路径
urllib.request.urlretrieve(img_url,'./img/'+name+'.jpg')
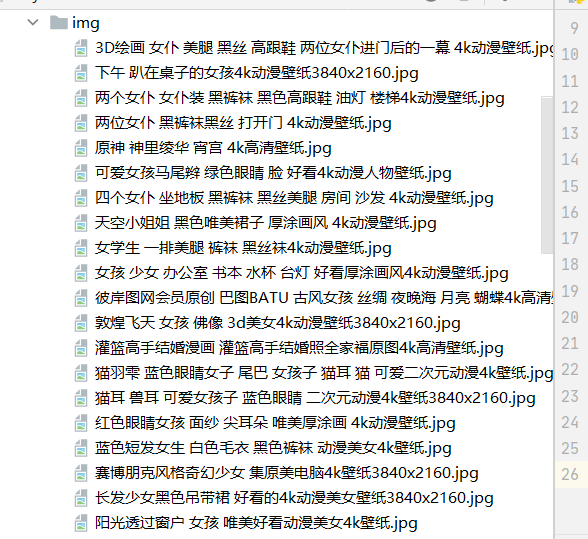
两种都可以实现,图片的下载,我保存的图片的地址为当前目录的img,从下面图片可以看到已经全部下载了
完整代码如下:
import urllib.request

import requests

from bs4 import BeautifulSoup

url = 'https://pic.netbian.com/4kdongman/'

headers = {

    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/97.0.4692.71 Safari/537.36'

}

r = requests.get(url,headers=headers)

#设置编码为gbk,要不然会乱码

r.encoding='gbk'

#使用lxml解析器解析

soup = BeautifulSoup(r.text,'lxml')

all_list = soup.find_all(attrs={'class': 'slist'})

img_list = all_list[0].find_all('img')

for img in img_list:

    img_url = img['src']

    name = img['alt']

    img_url = 'https://pic.netbian.com' + img_url

    print(name)

    # r_img = requests.get(img_url)

    # with open('./img/'+name+'.jpg','wb+') as f:

    #     f.write(r_img.content)

    urllib.request.urlretrieve(img_url,'./img/'+name+'.jpg')

    print('已经保存完成:'+img_url)
------------恢复内容结束------------
BeautifulSoup图片爬取的更多相关文章
- Python爬虫入门教程 26-100 知乎文章图片爬取器之二
1. 知乎文章图片爬取器之二博客背景 昨天写了知乎文章图片爬取器的一部分代码,针对知乎问题的答案json进行了数据抓取,博客中出现了部分写死的内容,今天把那部分信息调整完毕,并且将图片下载完善到代码中 ...
- 用BeautifulSoup简单爬取BOSS直聘网岗位
用BeautifulSoup简单爬取BOSS直聘网岗位 爬取python招聘 import requests from bs4 import BeautifulSoup def fun(path): ...
- 4k图片爬取+中文乱码
4k图片爬取+中文乱码 此案例有三种乱码解决方法,推荐第一种 4k图片爬取其实和普通图片爬取的过程是没有本质区别的 import requests import os from lxml import ...
- scrapy之360图片爬取
#今日目标 **scrapy之360图片爬取** 今天要爬取的是360美女图片,首先分析页面得知网页是动态加载,故需要先找到网页链接规律, 然后调用ImagesPipeline类实现图片爬取 *代码实 ...
- [Python_scrapy图片爬取下载]
welcome to myblog Dome地址 爬取某个车站的图片 item.py 中 1.申明item 的fields class PhotoItem(scrapy.Item): # define ...
- 爬虫07 /scrapy图片爬取、中间件、selenium在scrapy中的应用、CrawlSpider、分布式、增量式
爬虫07 /scrapy图片爬取.中间件.selenium在scrapy中的应用.CrawlSpider.分布式.增量式 目录 爬虫07 /scrapy图片爬取.中间件.selenium在scrapy ...
- python+BeautifulSoup+多进程爬取糗事百科图片
用到的库: import requests import os from bs4 import BeautifulSoup import time from multiprocessing impor ...
- 使用BeautifulSoup自动爬取微信公众号图片
爬取微信分享的图片,根据不同的页面自行修改,使用BeautifulSoup爬取,自行格局HTML修改要爬取图片的位置 import re import time import requests imp ...
- 网络爬虫之网站图片爬取-python实现
版本1.5 本次简单添加了四路多线程(由于我电脑CPU是四核的),速度飙升.本想试试xPath,但发现反倒是多此一举,故暂不使用 #-*- coding:utf-8 -*- import re,url ...
随机推荐
- java中args是什么意思?
1. 字符串变量名(args)属于引用变量,名字代号而已,可以自己取的. 2.总的来说就是个存放字符串数组用的, 去掉就不知道 "args" 声明的变量是什么类型了. 3.如果有 public sta ...
- CSS控制图片大小
转载请注明来源:https://www.cnblogs.com/hookjc/ 1.CSS控制背景图片: 对于一个网页,我们开始设计的时候,可能没有过多的去想背景图到底是什么,因为大多都是设计背 ...
- 超详细的node/v8/js垃圾回收机制
前言 垃圾回收器是一把十足的双刃剑.其好处是可以大幅简化程序的内存管理代码,因为内存管理无需程序员来操作,由此也减少了(但没有根除)长时间运转的程序的内存泄漏.对于某些程序员来说,它甚至能够提升代码的 ...
- 在CentOS中安装与配置Server JRE 8
感谢大佬:https://my.oschina.net/zx0211/blog/508221?p=1 其实也很简单: 1.从http://www.oracle.com/technetwork/java ...
- #pragma mark指令
1.#pragma mark指令的使用 功能:简单来说就是对代码的分组,方便代码查找和导航用的 它们告诉Xcode编译器,要在编辑器窗格顶部的方法和函数弹出菜单中将代码分隔开.一些类(尤其是一些控制器 ...
- MySQL--数据表操作--行转列和列转行
原创:转载需注明原创地址 https://www.cnblogs.com/fanerwei222/p/11782549.html MySQL--数据表操作: 会用到的查询操作. 1. Limit的用法 ...
- rpm与yum安装及管理程序
安装及管理程序 1.Linux应用程序基础 2.RPM软件包管理工具 3.yum源仓库创建 1.应用程序与系统命令的关系如图: 典型应用程序的目录结构如图: 常见的软件包封装类型如图: 2.RPM包 ...
- ASP.NET Core 6框架揭秘实例演示[03]:Dapr初体验
也许你们可能没有接触过Dapr,但是一定对它"有所耳闻",感觉今年它一下子就火了,一时间很多人都在谈论它.我们从其命名(Dapr的全称是"分布式应用运行时Distribu ...
- 框架3.1--V·P·N简介
目录 框架3.1-VPN简介 1.晨考 2.昨日问题 3.今日内容 4.vpn的简介 5.VPN的作用 6.VPN的种类 7.介绍OpenVPN 框架3.1-VPN简介 1.晨考 1.画iptable ...
- HMS Core积极探索基于硬件耳返的功能,帮助唱吧整体唱歌延迟率降低60%
唱吧的使命是让唱歌更简单.让生活更美好,其布局的K歌业务专注于让曲库更全.音质更好,开创了同框合唱.弹唱等有意思的游戏类K歌玩法.为了让用户拥有更加沉浸的娱乐体验,唱吧与HMS Core积极探索基于硬 ...