
selenium_采集药品数据
Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门
https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6EmUbbW&id=564564604865
数据源
http://118.114.237.85:8081/searchbio.aspx
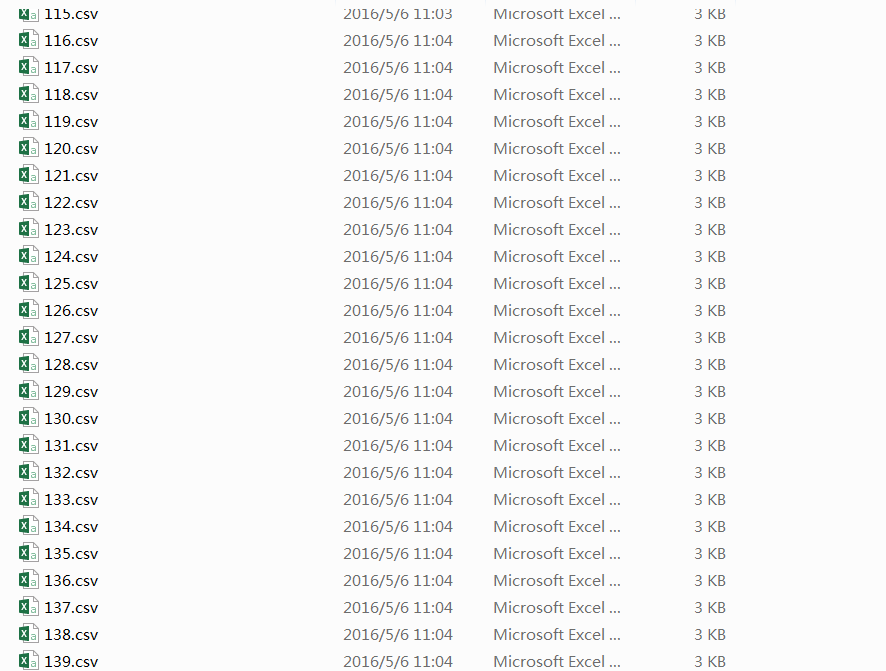
采集内容字段有的对不整齐,
def Get_one_table()函数需要修改

# -*- coding: utf-8 -*-

"""

Spyder Editor

采集思路:采一页,保存一页

This is a temporary script file.

"""

import requests,bs4,csv,time,selenium

from selenium import webdriver

list_allContent=[]

site="http://piqianfa.scsyjs.org/"

site1="http://118.114.237.85:8081/searchbio.aspx"

charset="gb2312"

browser=webdriver.Firefox()

browser.get(site1)

pages=196

#这种方式采集下来很粗糙,容易错位

def Get_one_table():

    elems=browser.find_elements_by_tag_name("tr")

    content=elems[0].text

    list_content=content.split("\n")

    #列表内个数

    num=len(list_content)

    list_content2=list_content[3:num]

    list_allContent.append(list_content2)

    return list_content2

'''

list_content2[2]

Out[13]: '批签蜀检201600220 人血白蛋白 20% 25ml 5g/瓶 201601A010 26931瓶 2021年1月22日

成都蓉生药业有限责任公司 该批制品符合规定,判定合格 2016-05-04'

'''

def Write_table_to_csv(fileName,list_tableContent):

    #对列表格式修改,字符串写入的格式不对

    list_tableContent1=[i.split(" ") for i in list_tableContent]

    file=open(fileName,'w',newline='')

    writer1=csv.writer(file)

    writer1.writerows(list_tableContent1)

    file.close()

def Click_next_page():

    linkElem=browser.find_element_by_link_text("下一页")

    linkElem.click()

def Get_fileName():

    pass

for i in range(1,pages+1):

    list_tableContent=Get_one_table()

    Click_next_page()

    fileName=str(i)+".csv"

    Write_table_to_csv(fileName,list_tableContent)
def Get_one_table()函数需要修改
# -*- coding: utf-8 -*-

"""

Created on Fri May  6 10:24:18 2016

@author: Administrator

"""

import requests,bs4,csv,time,selenium

from selenium import webdriver

site1="http://118.114.237.85:8081/searchbio.aspx"

charset="gb2312"

browser=webdriver.Firefox()

browser.get(site1)

elems=browser.find_elements_by_class_name("tb")

elems1= elems[1:]

content=[i.text for i in elems1]

'''

elems=browser.find_elements_by_class_name("tr")

elems

Out[33]: []

elems=browser.find_elements_by_class_name("tb")

elems[1].text

Out[25]: '批签蜀检201600221'

elems[2].text

Out[26]: '静注人免疫球蛋白(pH4)'

elems[3].text

Out[27]: '2.5g(5%,50ml)/瓶'

elems[4].text

Out[28]: '201602005'

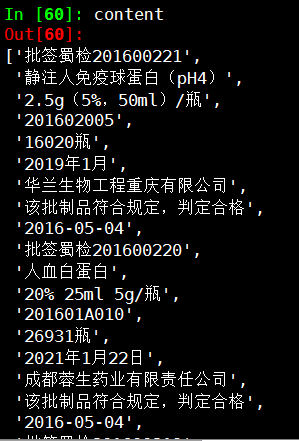
content

Out[60]:

['批签蜀检201600221',

 '静注人免疫球蛋白(pH4)',

 '2.5g(5%,50ml)/瓶',

 '201602005',

 '16020瓶',

 '2019年1月',

 '华兰生物工程重庆有限公司',

 '该批制品符合规定,判定合格',

 '2016-05-04',

 '批签蜀检201600220',

 '人血白蛋白',

 '20% 25ml 5g/瓶',

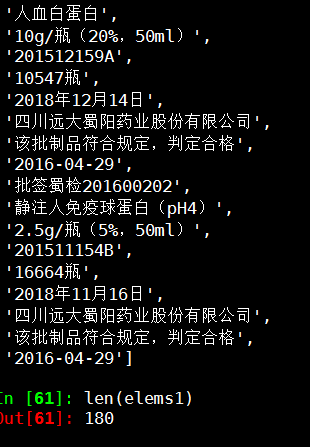
  '批签蜀检201600202',

 '静注人免疫球蛋白(pH4)',

 '2.5g/瓶(5%,50ml)',

 '201511154B',

 '16664瓶',

 '2018年11月16日',

 '四川远大蜀阳药业股份有限公司',

 '该批制品符合规定,判定合格',

 '2016-04-29']

len(elems1)

Out[61]: 180

'''

'''

content=elems[0].text

list_content=content.split("\n")

#列表内个数

num=len(list_content)

list_content2=list_content[3:num]

'''
selenium_采集药品数据的更多相关文章
- selenium_采集药品数据2_采集所有表格
Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门 https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6E ...
- selenium_采集药品数据1_采集第一页表格
Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门 https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6E ...
- C#+HtmlAgilityPack+XPath带你采集数据(以采集天气数据为例子)
第一次接触HtmlAgilityPack是在5年前,一些意外,让我从技术部门临时调到销售部门,负责建立一些流程和寻找潜在客户,最后在阿里巴巴找到了很多客户信息,非常全面,刚开始是手动复制到Excel, ...
- Gobblin采集kafka数据
作者:Syn良子 出处:http://www.cnblogs.com/cssdongl 转载请注明出处 找时间记录一下利用Gobblin采集kafka数据的过程,话不多说,进入正题 一.Gobblin ...
- API例子:用Python驱动Firefox采集网页数据
1,引言 本文讲解怎样用Python驱动Firefox浏览器写一个简易的网页数据采集器.开源Python即时网络爬虫项目将与Scrapy(基于twisted的异步网络框架)集成,所以本例将使用Scra ...
- Performance Monitor采集性能数据
Performance Monitor采集性能数据 Windows本身为我们提供了很多好用的性能分析工具,大家日常都使用过资源管理器,在里面能即时直观的看到CPU占用率.物理内存使用量等信息.此外新系 ...
- 【Android 应用开发】分析各种Android设备屏幕分辨率与适配 - 使用大量真实安卓设备采集真实数据统计
.主要是为了总结一下 对这些概念有个直观的认识; . 作者 : 万境绝尘 转载请注明出处 : http://blog.csdn.net/shulianghan/article/details/198 ...
- Android 音视频开发(四):使用 Camera API 采集视频数据
本文主要将的是:使用 Camera API 采集视频数据并保存到文件,分别使用 SurfaceView.TextureView 来预览 Camera 数据,取到 NV21 的数据回调. 注: 需要权限 ...
- 分析各种Android设备屏幕分辨率与适配 - 使用大量真实安卓设备采集真实数据统计
一. 数据采集 源码GitHub地址 : -- SSH : git@github.com:han1202012/DisplayTest.git; -- HTTP : https://github.co ...
随机推荐
- 同步手绘板——将View的内容映射成Bitmap转图片导出
在Android中自有获取view中的cache内容,然后将内容转换成bitmap,方法名是:getDrawingCache(),返回结果为Bitmap,但是刚开始使用的时候,得到的结果都是null, ...
- beta版使用说明
StudyAssistant说明书 我们的软件使用简单方便,下面就让我们在介绍软件界面的同时一同来介绍我们的软件使用方法: 1.这是我们软件的首页界面,单刀直入,简单明了,四科同时类课程,更好的帮助同 ...
- Beta 冲刺 随笔合集
团队展示: Team一二一 Beta 冲刺 凡事预则立 Beta冲刺 一 Beta冲刺 二 Beta冲刺 三 Beta冲刺 四 Beta冲刺 五 Beta冲刺 六 Beta冲刺 七 Beta总结 用户 ...
- 使用composer遇到的问题及解决方法
可以尝试利用composer下载Yii框架,编辑composer.json文件: { "require":{ "yiisoft/yii2":"~2.0 ...
- 开源的CAS实现SSO
https://www.ibm.com/developerworks/cn/opensource/os-cn-cas/index.html ISC是基于CAS定制的,使用的高级的代理模式. https ...
- yum install 报错[Errno 14] curl#37 - Couldn't open file /mnt/repodata/repomd.xml
1.然后按照网上的一些修改,先是执行: yum cleam all 然后 yum makecache,问题还是没解决,继续报错. 其实这两条命令就是清空缓存,然后再重新缓存的意思,有时候可能有效. 2 ...
- JetBrains全系列破解
教程开始: 进入自己安装idea路径的bin目录下,将刚刚下载好的JetbrainsCrack.jar复制到此目录下: 还是在bin目录下,找到idea.exe.vmoptions和idea64.ex ...
- springMVC 使用WebApplicationContext获取ApplicationContext对象
主要用于从application中获取bean 1.applicationContext 在web.xml中使用listener配置 <context-param> <param-n ...
- PHP的安装,编译,扩展工具
1.基本容易混淆的概念 pecl php的社区贡献扩展库,全称为PHP Extension Community Library, 是php的底层库, 使用C语言编写 pear php的应用扩展库,全称 ...
- Test Scenarios for a window
1 check if default window size is correct2 check if child window size is correct3 check if there is ...