
机器学习-无监督机器学习-密度聚类DBSCAN-19
1. DBSCAN
Density based clustering
DBSCAN不要求我们指定cluster簇的数量,避免了异常值,并且在任意形状和大小的cluster簇中工作得非常好。它没有质心,聚类簇是通过将相邻的点连接在一起的过程形成的。
超参数:
Epsilon (ɛ):设置的最大半径。
最小点数目(minPts):在一个邻域的半径内minPts数的邻域被认为是一个簇。请记住,初始点包含在minPts中。
核心点:在其近邻距离内至少有minPts个数据点。
对核心点的邻域内的每个点进行评估,以确定它是否在epsilon距离内有minPts (minPts包括点本身)。如果该点满足minPts标准,它将成为另一个核心点,cluster簇将扩展。如果一个点不满足minPts标准,它成为边界点。
离群点:这些点不是近邻点,也不是边界点。这些点位于低密度地区。
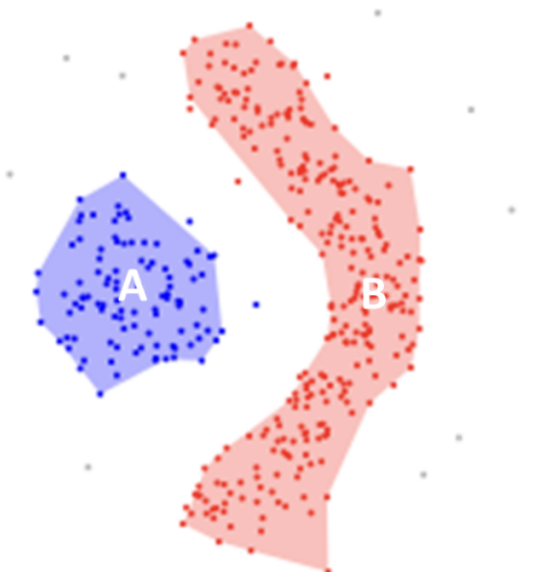
2. OPTICS
Ordering Points To Identify Cluster Structure
目标是识别聚类的内部结构
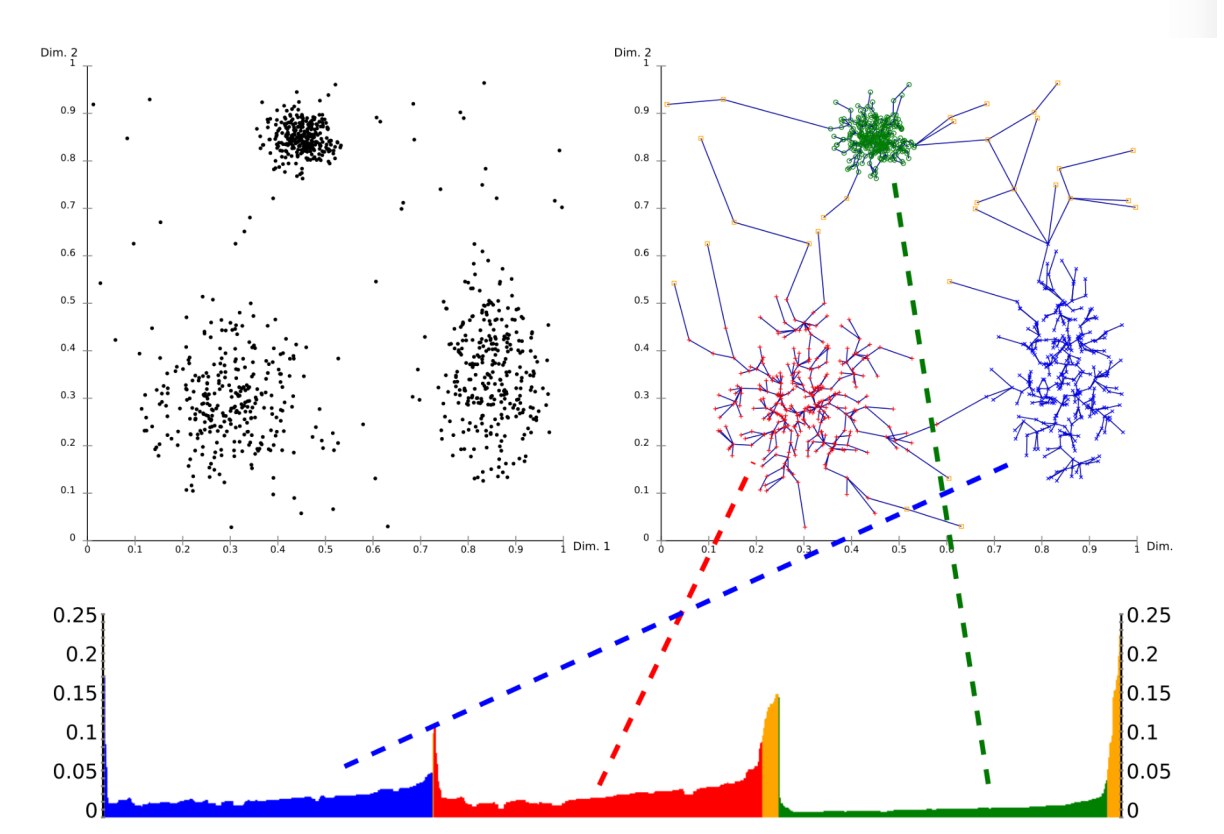
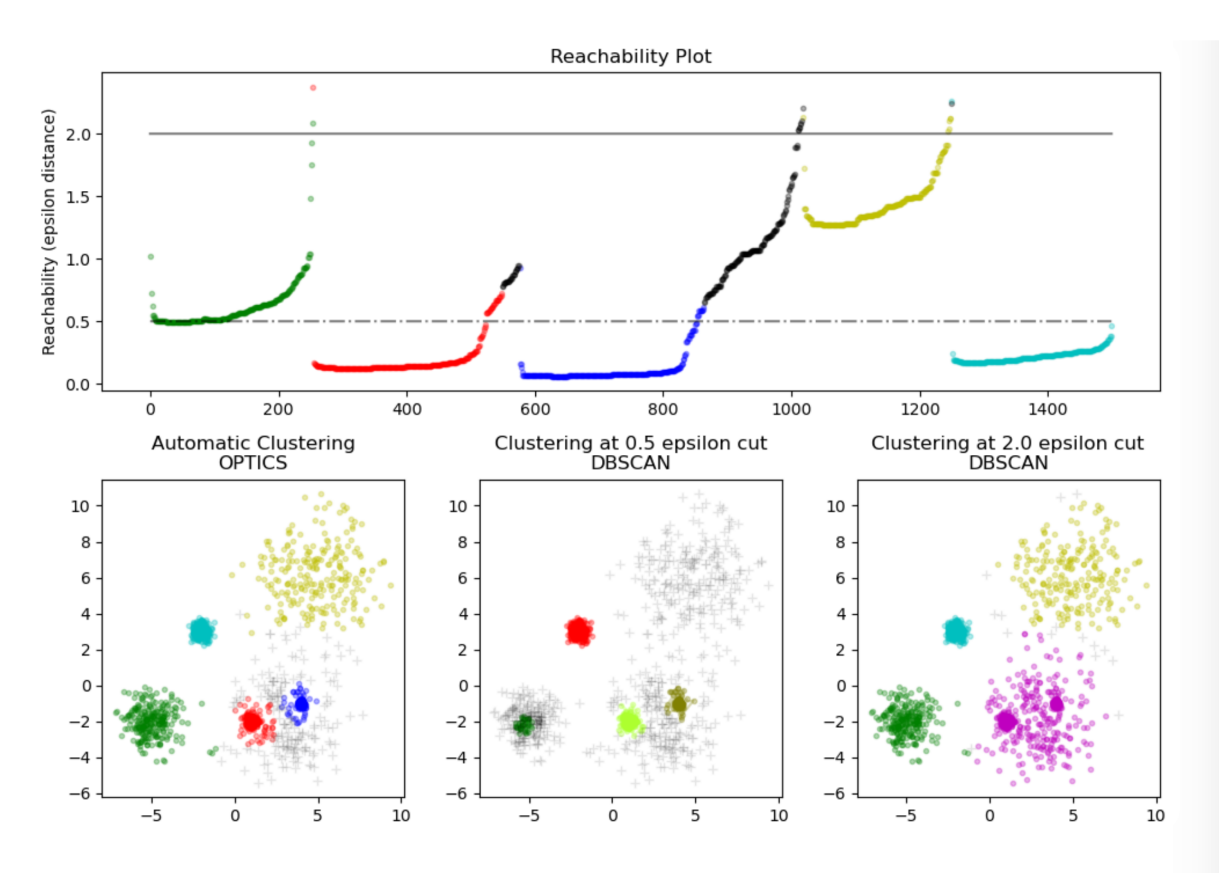
这个算法本身核心并不直接划分数据到不同的聚类簇。它仅生成一个关于可达距离(纵轴)图形,然后再去读取这个图形做进一步的 聚类。这个图形本质上记录了数据点被处理的顺序(横轴),而
不是数据点的具体划分。这是与DBSCAN最大的不同。
可达距离图:
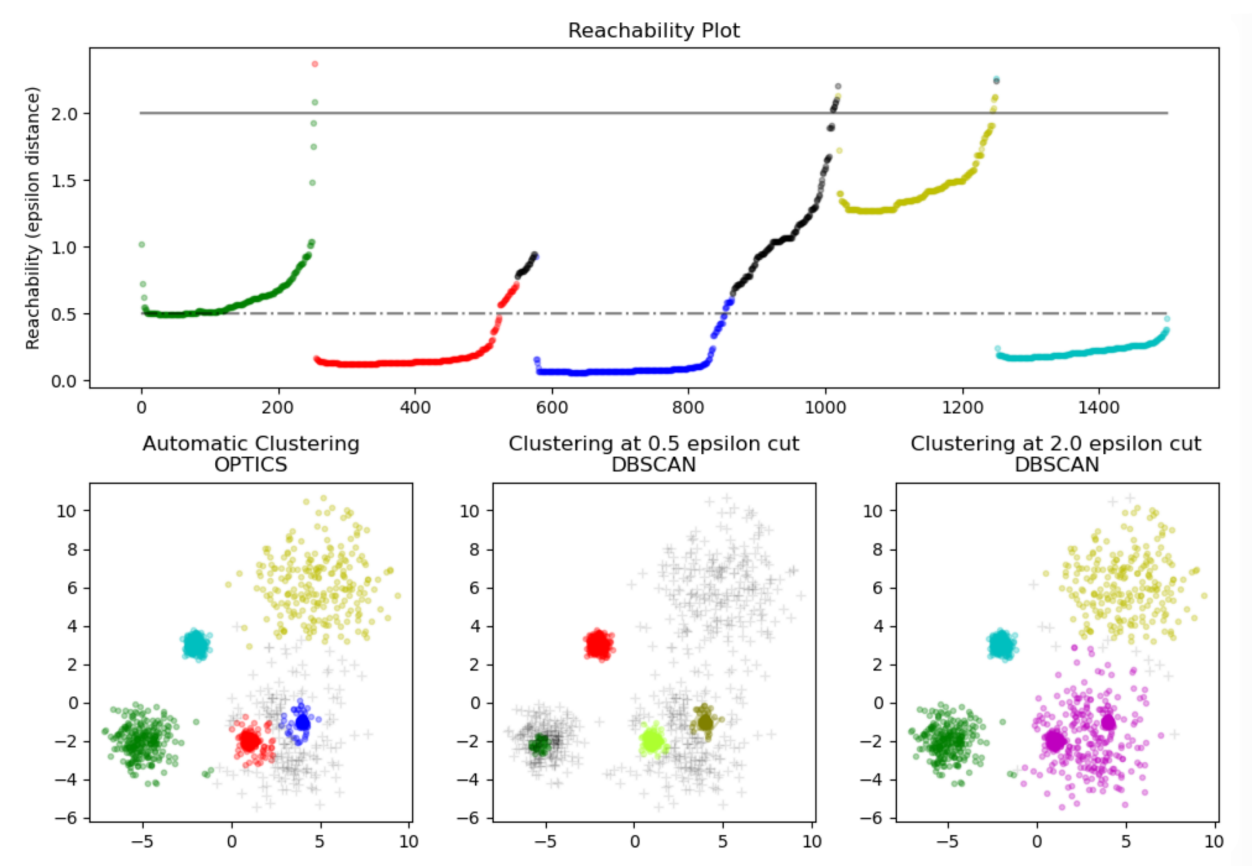
在DBCSAN算法中需要输入两个参数:epsilon和minPts ,选择不同的参数会导致最终聚类的结果千差万别,因此DBCSAN对于输入参数过于敏感。OPTICS算法的提出就是为了帮助DBSCAN算法选择合适的参数,降低输入参数的敏感度。
两个重要的概念:
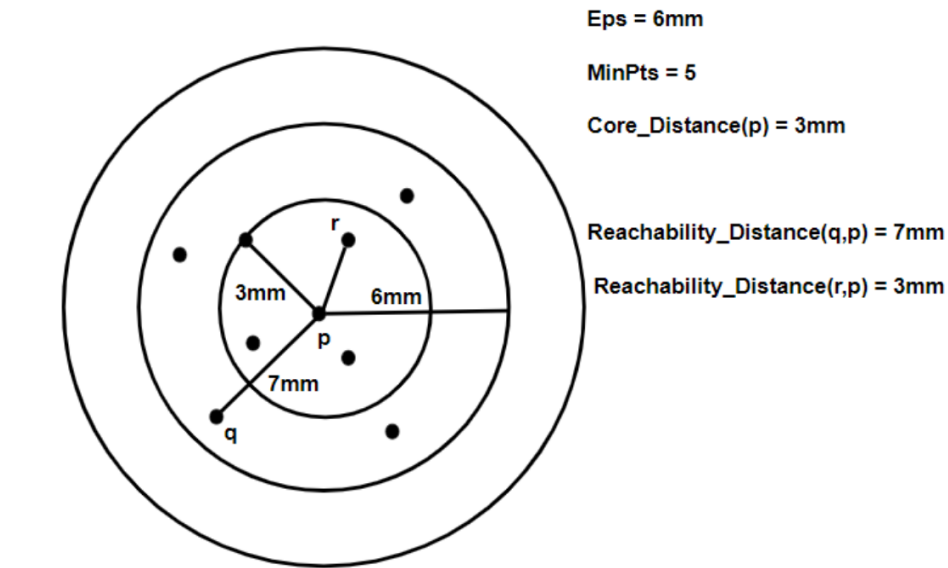
核心距离:是确定一个给定点是核心点的半径最小值。如果给定点不是一个核心点,那么它的核心距离是 无穷大。
可达距离:
定义相对其它数据点q。点p和q之间的可达距离是p点的核心距离与p和q之间的欧氏距离的最大值 max(core_dist(p), eula(p, q))
仔细品味这两张 可达距离 云图
2. MeanShift
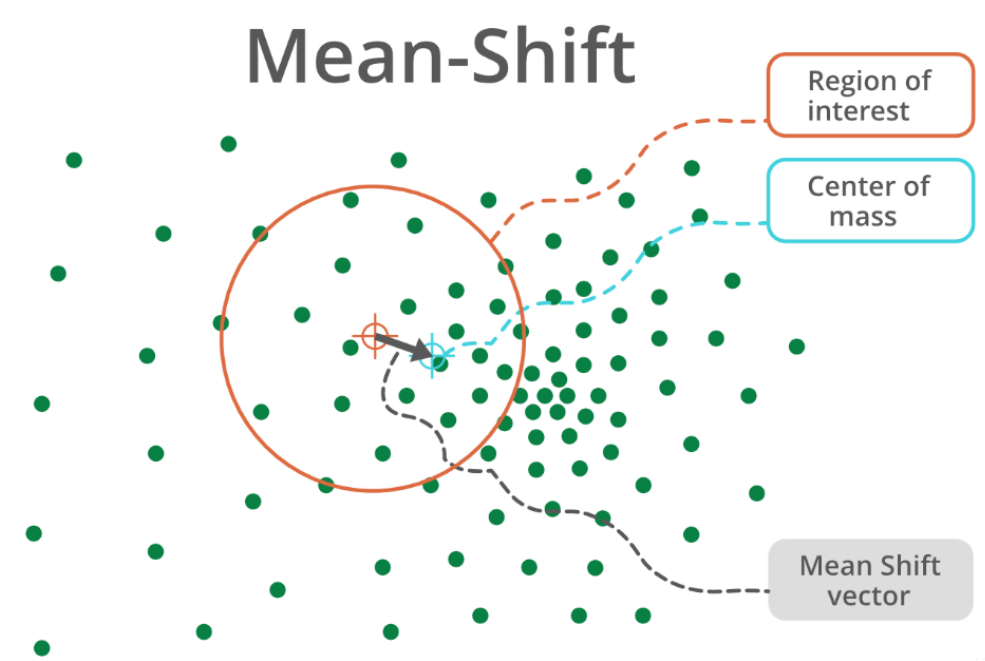
均值漂移, 在目标追踪中应用广泛。本身其实是一种基于密度的聚类算法。
计算某一点A与其周围半径R内的向量距离的平均值M,计算出该点下一步漂移(移动)的方向(A=M+A)
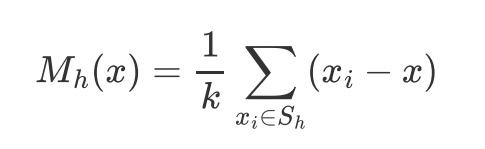
MeanShift向量表示区域中k个样本点相对于点x求偏移量再平均,求出来的向量指向概率密度梯度的方向(指向真实质心方向)。
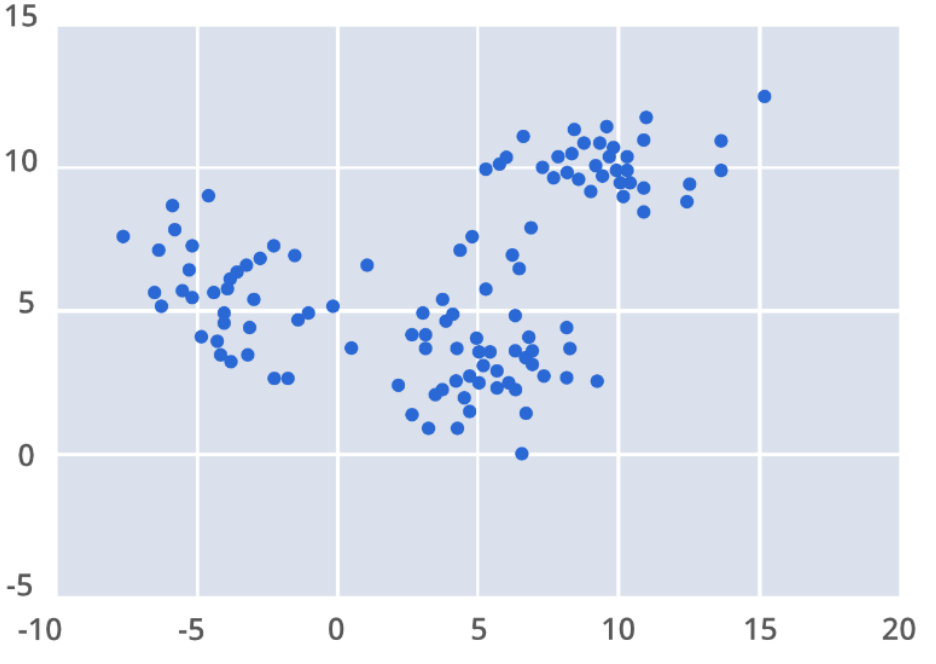
MeanShift的扩展:
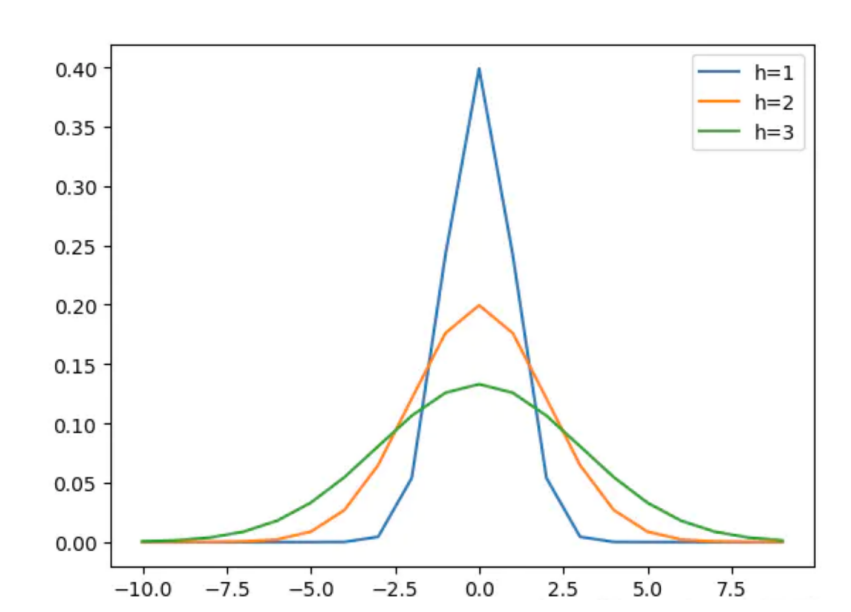
不同的簇包含的数据看成是正太分布采样得到的。

机器学习-无监督机器学习-密度聚类DBSCAN-19的更多相关文章
- 吴裕雄 python 机器学习——密度聚类DBSCAN模型
import numpy as np import matplotlib.pyplot as plt from sklearn import cluster from sklearn.metrics ...
- 密度聚类 - DBSCAN算法
参考资料:python机器学习库sklearn——DBSCAN密度聚类, Python实现DBScan import numpy as np from sklearn.cluster impo ...
- 聚类——密度聚类DBSCAN
Clustering 聚类 密度聚类——DBSCAN 前面我们已经介绍了两种聚类算法:k-means和谱聚类.今天,我们来介绍一种基于密度的聚类算法——DBSCAN,它是最经典的密度聚类算法,是很多算 ...
- 31(1).密度聚类---DBSCAN算法
密度聚类density-based clustering假设聚类结构能够通过样本分布的紧密程度确定. 密度聚类算法从样本的密度的角度来考察样本之间的可连接性,并基于可连接样本的不断扩张聚类簇,从而获得 ...
- 密度聚类 DBSCAN
刘建平:DBSCAN密度聚类算法 https://www.cnblogs.com/pinard/p/6208966.html API 的说明: https://www.jianshu.com/p/b0 ...
- 机器学习(十)—聚类算法(KNN、Kmeans、密度聚类、层次聚类)
聚类算法 任务:将数据集中的样本划分成若干个通常不相交的子集,对特征空间的一种划分. 性能度量:类内相似度高,类间相似度低.两大类:1.有参考标签,外部指标:2.无参照,内部指标. 距离计算:非负性, ...
- <机器学习>无监督学习算法总结
本文仅对常见的无监督学习算法进行了简单讲述,其他的如自动编码器,受限玻尔兹曼机用于无监督学习,神经网络用于无监督学习等未包括.同时虽然整体上分为了聚类和降维两大类,但实际上这两类并非完全正交,很多地方 ...
- 基于密度聚类的DBSCAN和kmeans算法比较
根据各行业特性,人们提出了多种聚类算法,简单分为:基于层次.划分.密度.图论.网格和模型的几大类. 其中,基于密度的聚类算法以DBSCAN最具有代表性. 场景 一 假设有如下图的一组数据, 生成数据 ...
- 学习笔记CB008:词义消歧、有监督、无监督、语义角色标注、信息检索、TF-IDF、隐含语义索引模型
词义消歧,句子.篇章语义理解基础,必须解决.语言都有大量多种含义词汇.词义消歧,可通过机器学习方法解决.词义消歧有监督机器学习分类算法,判断词义所属分类.词义消歧无监督机器学习聚类算法,把词义聚成多类 ...
- 1(1).有监督 VS 无监督
对比一 : 有标签 vs 无标签 有监督机器学习又被称为“有老师的学习”,所谓的老师就是标签.有监督的过程为先通过已知的训练样本(如已知输入和对应的输出)来训练,从而得到一个最优模型,再将这个模型应用 ...
随机推荐
- The second day learning summary
1.什么是接口测试? 接口测试是测试系统组件间接口的一种测试.接口测试主要用于外部系统与系统之间以及内部各个子系统之间的交互点,定义特定的交互点,然后通过这些交互点来,通过一些特殊的规则也就是协议,来 ...
- flask上下文、g变量、current_app
在flask中的上下文分为两种 : 请求上下文 (request context) 也就是和请求相关的上下文,记录一些请求相关的数据. 包含: 1.request请求对象 2.session会话 应用 ...
- Celery将任务分发到不同的队列,交给不同的Worker处理
https://docs.celeryq.dev/en/stable/userguide/routing.html#routing-tasks https://blog.csdn.net/wangle ...
- Javascript实现Canvas绘图 —— 2D绘图之填充、描边及绘制矩形
Canvas绘图的实现: <canvas>元素负责在页面中设定一个区域,通过JS动态地在这个区域中绘制图形. IE9+.Firefox1.5+.Safari2+.Opera9+.Chrom ...
- [转]NLog学习笔记
配置文件 NLog所有的配置信息都可以写到一个单独的xml文件中,也可以在程序代码中进行配置. 配置文件位置 启动的时候,NLog会试图查找配置文件完成自动配置,查找的文件依次如下(找到配置信息则结束 ...
- Typora远程代码执行漏洞 - CVE-2023-2317
Typora - CVE-2023-2317 简介 Typora一个常用的markdown编辑器,在1.6.7之前存在XSS漏洞,可以通过传入参数触发来加载恶意的JavaScript代码 分析 在ty ...
- 小乌龟(TortoiseGit)配置SSH
小乌龟(TortoiseGit)配置SSH 使用gerrit作为项目管理,使用console窗口命令,我真是不记得太多git命令,因此交给小乌龟可视化操作,简单方便.这里记录下配置SSH公钥私钥. 前 ...
- 突破开源Redis的内存限制,存算分离的GaussDB到底有多能“装”?
摘要:GaussDB(for Redis)(下文简称高斯Redis)是华为云数据库团队自主研发的兼容Redis协议的云原生数据库,该数据库采用计算存储分离架构,突破开源Redis的内存限制,可轻松扩展 ...
- Preload与Prefetch的区别以及webpack项目中如何优化
preload 与prefetch 的区别 preload 是一个声明式 fetch,可以强制浏览器在不阻塞 document 的 onload 事件的情况下请求资源. preload 顾名思义就是一 ...
- 重磅!Github宣布面向团队免费
GitHub CEO Nat Friedman 宣布已面向全体 GitHub 用户和团队提供不限制协作人数的私有仓库,并宣称 GitHub 的全部核心功能现已对所有人免费提供. 公告称: 到目前为止, ...