
Hadoop完全分布式的配置
选取机器sam01作为主节点,并进行分布式文件的配置
1.进入Hadoop配置文件路径/usr/local/hadoop/etc/hadoop(这里我把Hadoop安装在/usr/local目录下)
2.配置core-site.xml文件
<configuration>

    <!-- hdfs的地址名称:schame,ip,port-->

    <!-- 在Hadoop1.x的版本中,默认使用的端口是9000。在Hadoop2.x的版本中,默认使>用端口是8020 -->

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://sam01:8020</value>

    </property>

    <!-- hdfs的基础路径,被其他属性所依赖的一个基础路径 -->

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/usr/local/hadoop/tmp</value>

    </property>

</configuration>
3.配置hdfs-site.xml文件
<configuration>

    <!-- namenode守护进程管理的元数据文件fsimage存储的位置-->

    <property>

        <name>dfs.namenode.name.dir</name>

        <value>file://${hadoop.tmp.dir}/dfs/name</value>

    </property>

    <!-- 确定DFS数据节点应该将其块存储在本地文件系统的何处-->

    <property>

        <name>dfs.datanode.data.dir</name>

        <value>file://${hadoop.tmp.dir}/dfs/data</value>

    </property>

    <!-- 块的副本数-->

    <property>

        <name>dfs.replication</name>

        <value>3</value>

    </property>

    <!-- 块的大小(128M),下面的单位是字节-->

    <property>

        <name>dfs.blocksize</name>

        <value>134217728</value>

    </property>

    <!-- secondarynamenode守护进程的http地址:主机名和端口号。参考守护进程布局-->

    <property>

        <name>dfs.namenode.secondary.http-address</name>

        <value>sam02:50090</value>

    </property>

    <!-- namenode守护进程的http地址:主机名和端口号。参考守护进程布局-->

    <property>

        <name>dfs.namenode.http-address</name>

        <value>sam01:50070</value>

    </property>

</configuration>
4.配置mapred-site.xml
这里初始为mapred-site.xml.template文件,需要复制为mapred-site.xml文件
cp mapred-site.xml.template mapred-site.xml
<configuration>

    <!-- namenode守护进程管理的元数据文件fsimage存储的位置-->

    <property>

        <name>dfs.namenode.name.dir</name>

        <value>file://${hadoop.tmp.dir}/dfs/name</value>

    </property>

    <!-- 确定DFS数据节点应该将其块存储在本地文件系统的何处-->

    <property>

        <name>dfs.datanode.data.dir</name>

        <value>file://${hadoop.tmp.dir}/dfs/data</value>

    </property>

    <!-- 块的副本数-->

    <property>

        <name>dfs.replication</name>

        <value>3</value>

    </property>

    <!-- 块的大小(128M),下面的单位是字节-->

    <property>

        <name>dfs.blocksize</name>

        <value>134217728</value>

    </property>

    <!-- secondarynamenode守护进程的http地址:主机名和端口号。参考守护进程布局-->

    <property>

        <name>dfs.namenode.secondary.http-address</name>

        <value>sam02:50090</value>

    </property>

    <!-- namenode守护进程的http地址:主机名和端口号。参考守护进程布局-->

    <property>

        <name>dfs.namenode.http-address</name>

        <value>sam01:50070</value>

    </property>

</configuration>
6.配置yarn-site.xml
<configuration>

    <!-- 指定yarn的shuffle技术-->

    <property>

        <name>yarn.nodemanager.aux-services</name>

       <value>mapreduce_shuffle</value>

    </property>

    <!-- 指定resourcemanager的主机名-->

    <property>

        <name>yarn.resourcemanager.hostname</name>

        <value>sam01</value>

    </property>

    <!--下面的可选-->

    <!--指定shuffle对应的类 -->

        <property>

        <name>yarn.nodemanager.aux-services.mapreduce_shuffle.class</name>

     <value>org.apache.hadoop.mapred.ShuffleHandler</value>

        </property>

        <!--配置resourcemanager的内部通讯地址-->

        <property>

        <name>yarn.resourcemanager.address</name>

        <value>sam01:8032</value>

        </property>

        <!--配置resourcemanager的scheduler的内部通讯地址-->

        <property>

        <name>yarn.resourcemanager.scheduler.address</name>

        <value>sam01:8030</value>

        </property>

        <!--配置resoucemanager的资源调度的内部通讯地址-->

        <property>

        <name>yarn.resourcemanager.resource-tracker.address</name>

        <value>sam01:8031</value>

        </property>

        <!--配置resourcemanager的管理员的内部通讯地址-->

        <property>

        <name>yarn.resourcemanager.admin.address</name>

        <value>sam01:8033</value>

        </property>

        <!--配置resourcemanager的web ui 的监控页面-->

        <property>

        <name>yarn.resourcemanager.webapp.address</name>

        <value>sam01:8088</value>

        </property>

</configuration>
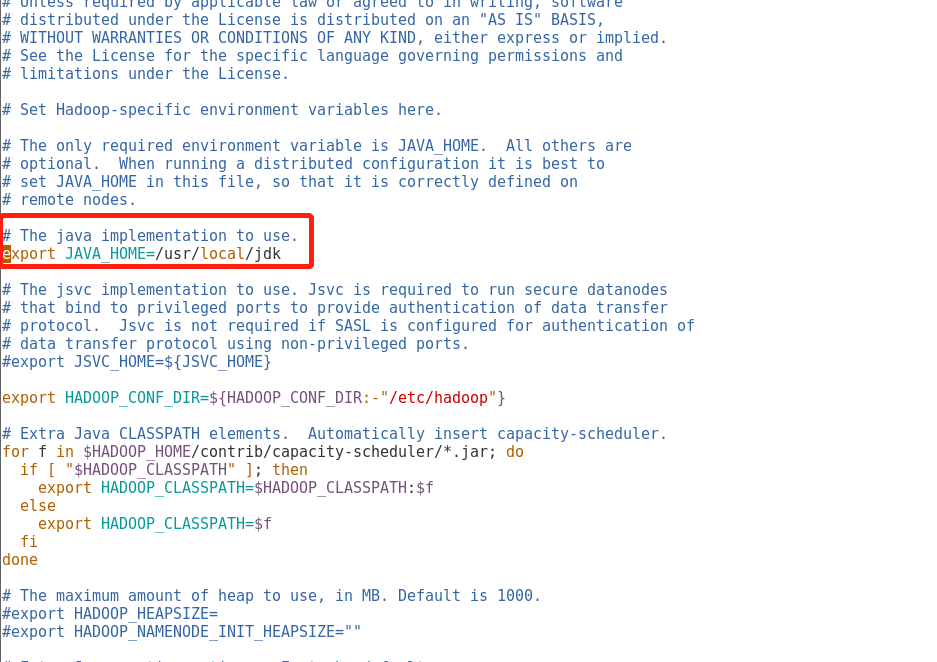
7.配置hadoop-env.sh文件
# The java implementation to use.

export JAVA_HOME=/usr/local/jdk
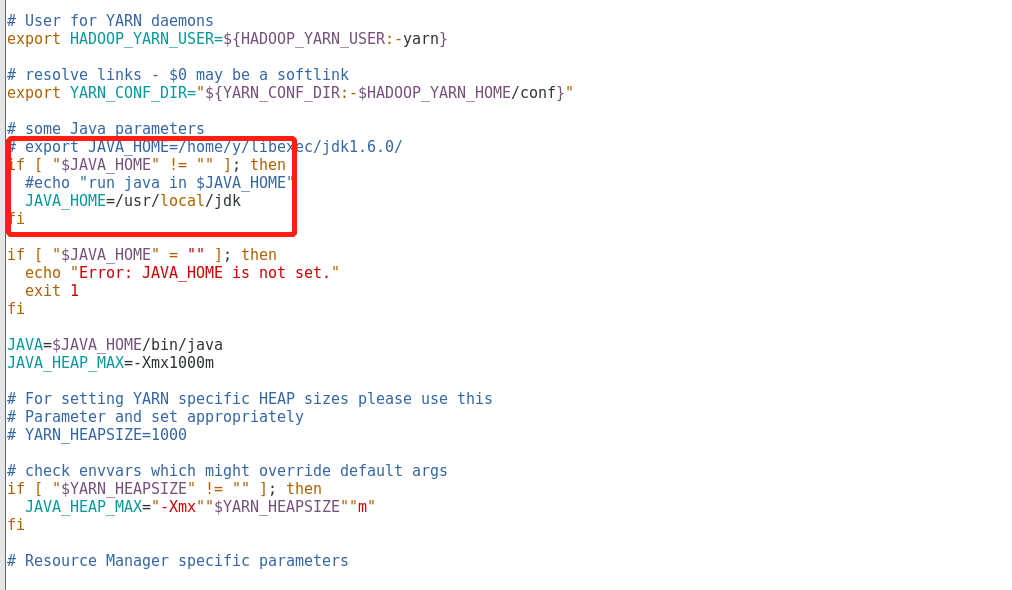
8.配置yarn-env.sh文件
 #echo "run java in $JAVA_HOME"

  JAVA_HOME=/usr/local/jdk
9.配置slaves文件,此文件用于指定datanode守护进程所在的机器节点主机名
sam01

sam02

sam03
10.同步Hadoop配置文件到其余的节点
cd /usr/local

scp -r hadoop/ sam02:$PWD

scp -r hadoop/ sam03:$PWD
Hadoop完全分布式的配置的更多相关文章
- Hadoop完全分布式安装配置完整过程
一. 硬件.软件准备 1. 硬件设备 为了方便学习Hadoop,我采用了云服务器来配置Hadoop集群.集群使用三个节点,一个阿里云节点.一个腾讯云节点.一个华为云节点,其中阿里云和腾讯云都是通过使用 ...
- Hadoop 伪分布式安装配置
- 基于Centos搭建 Hadoop 伪分布式环境
软硬件环境: CentOS 7.2 64 位, OpenJDK- 1.8,Hadoop- 2.7 关于本教程的说明 云实验室云主机自动使用 root 账户登录系统,因此本教程中所有的操作都是以 roo ...
- Hadoop学习笔记(一):ubuntu虚拟机下的hadoop伪分布式集群搭建
hadoop百度百科:https://baike.baidu.com/item/Hadoop/3526507?fr=aladdin hadoop官网:http://hadoop.apache.org/ ...
- hadoop的安装和配置(三)完全分布式模式
博主会用三篇文章为大家详细说明hadoop的三种模式: 本地模式 伪分布模式 完全分布模式 完全分布式模式: 前面已经说了本地模式和伪分布模式,这两种在hadoop的应用中并不用于实际,因为几乎没人会 ...
- 在Linux(Centos7)系统上对进行Hadoop分布式配置以及运行Hadoop伪分布式实例
在Linux(Centos7)系统上对进行Hadoop分布式配置以及运行Hadoop伪分布式实例 ...
- Hadoop伪分布式配置
一步一步来: 安装VMWARE简单,安装CentOS也简单 但是,碰到了一个问题:安装的虚拟机没有图形化界面 最后,我选择了CentOS-7-x86_64-DVD-1503-01.iso镜像 配置用户 ...
- Data - Hadoop伪分布式配置 - 使用Hadoop2.8.0和Ubuntu16.04
系统版本 anliven@Ubuntu1604:~$ uname -a Linux Ubuntu1604 4.8.0-36-generic #36~16.04.1-Ubuntu SMP Sun Feb ...
- 使用docker搭建hadoop环境,并配置伪分布式模式
docker 1.下载docker镜像 docker pull registry.cn-hangzhou.aliyuncs.com/kaibb/hadoop:latest 注:此镜像为阿里云个人上传镜 ...
随机推荐
- STM32新建模板之库文件
一.新建项目文件夹 在桌面创建项目文件夹,用于存放工程,命名为"stm32f10x_project" 在项目文件夹中创建3个文件夹,分别命名为:CMSIS.OUTPUT.STM32 ...
- (onlyoffice)在CentOS及其衍生产品上安装Linux的Document Server
介绍 Document Server是一个在线办公套件,包括用于文本,电子表格和演示文稿的查看器和编辑器,与Office Open XML格式完全兼容:.docx,.xlsx,.pptx,并支持实时协 ...
- LINUX学习--nginx服务器的安装
一.安装环境 操作系统CentOS6.8 关闭SeLinux和iptables防火墙 二.网络yum源 将下面的软件下载到 /etc/yum.repos.d/ 的目录下 官方基础:http:// ...
- 硬核 - Java 随机数相关 API 的演进与思考(上)
本系列将 Java 17 之前的随机数 API 以及 Java 17 之后的统一 API 都做了比较详细的说明,并且将随机数的特性以及实现思路也做了一些简单的分析,帮助大家明白为何会有这么多的随机数算 ...
- Elasticsearch基础知识学习
概要 ElasticSearch是一个基于Lucene的搜索服务器.它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口.Elasticsearch是用Java开发的,并作为Ap ...
- 两张Number()函数图和Boolean()函数图
- 使用.NET 6开发TodoList应用(26)——实现Configuration和Option的强类型绑定
系列导航及源代码 使用.NET 6开发TodoList应用文章索引 需求 在上一篇文章使用.NET 6开发TodoList应用(25)--实现RefreshToken中,我们通过使用Configura ...
- Spark-寒假-实验3
1.安装 Hadoop 和 Spark 进入 Linux 系统,参照本教程官网"实验指南"栏目的"Hadoop 的安装和使用",完成 Hadoop 伪分布式模式 ...
- gin框架中的路由拆分与注册
基本的路由注册 下面最基础的gin路由注册方式,适用于路由条目比较少的简单项目或者项目demo. package main import ( "net/http" "gi ...
- Servlet-斜杠在web中不同意义
Servlet-斜杠在web中不同意义 在web中 / 斜杠是一种绝对路径 / 斜杠 如果被浏览器解析,得到的地址是:http://ip/port/ / 斜杠 如果被服务器解析,得到的地址是:http ...