
Solr5.5高级应用(基于tomcat9)
一.配置solr
1.配置
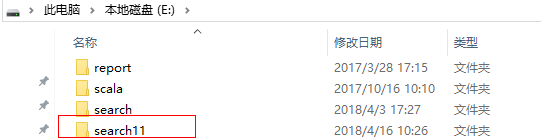
注意:要是想放到其它路径下,可以修改此路径下的web.xml配置文件

修改内容如下:
<!-- 将solrhome的绝对路径写入env-entry-value -->
<env-entry>
<env-entry-name>solr/home</env-entry-name>
<!--例如:E:/search11/solr/server/solr-->
<env-entry-value>你的core的上级路径</env-entry-value>
<env-entry-type>java.lang.String</env-entry-type>
</env-entry>
2.点击tomcat的bin目录下的startup.bat启动

3.在浏览器上输入http://你的ip:8080/solr/index.html#/ 查看

4.选择test-core,执行查看

二.配置HanLP分词器
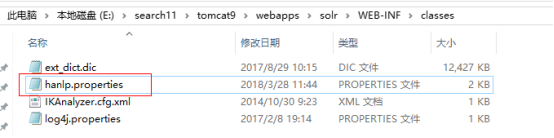
1. 配置配置文件
从下载的HanLP中获取hanlp.properties配置文件,放置到下面的路径中。
2. 导入HanLP词典
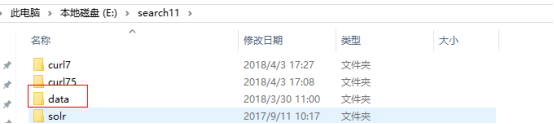
从下载的HanLP中拷贝data到下图目录下,该data包含Hanlp中提供的词库和模型。
3. 导入jar包
把HanLP中的hanlp-1.5.0.jar和hanlp-1.5.0.sources.jar放到tomcat的该目录下

4. 修改hanlp.properties中的,改成data的上级目录
一、配置HanLP分词器
1.配置分词器
在使用该分词器的core中的managed-schema文件中添加
<fieldType name="text_cn" class="solr.TextField">
<analyzer type="index">
<tokenizer class="com.hankcs.lucene.HanLPTokenizerFactory"
enableIndexMode="true" enablePlaceRecognize="true" enableOrganizationRecognize="true" customDictionaryPath="E:\search11\data\dictionary\custom\自定义词典.txt"/>
<filter class="solr.StopFilterFactory" ignoreCase="true" words="stopwords.txt" />
<filter class="solr.LowerCaseFilterFactory"/>
</analyzer>
<analyzer type="query">
<!-- 切记不要在query中开启index模式 -->
<tokenizer class="com.hankcs.lucene.HanLPTokenizerFactory"
enableIndexMode="false" enablePlaceRecognize="true" enableOrganizationRecognize="true" customDictionaryPath="E:\search11\data\dictionary\custom\自定义词典.txt"/>
<filter class="solr.StopFilterFactory" ignoreCase="true" words="stopwords.txt" />
<filter class="solr.SynonymFilterFactory" synonyms="synonyms.txt"
ignoreCase="true" expand="true"/>
<filter class="solr.LowerCaseFilterFactory"/>
</analyzer>
</fieldType>
2.修改使用该分词器的字段

3.结果

三.配置Tika文档提取器
1. 首先在core中添加tika文档搜索
<requestHandler name="/update/extract" class="org.apache.solr.handler.extraction.ExtractingRequestHandler" startup="lazy">
<lst name="defaults">
<!-- All the main content goes into "text"... if you need to return
the extracted text or do highlighting, use a stored field. -->
<str name="fmap.content">text</str>
<str name="lowernames">false</str>
<str name="uprefix">ignored_</str>
<!-- capture link hrefs but ignore div attributes -->
</lst>
</requestHandler>
2. 配置tika解析文档的分类字段
<!-- Tika字段 -->
<field name="PK" type="string" indexed="true" stored="true" required="true" multiValued="false"/>
<field name="BT" type="string" indexed="true" stored="true" termVectors="true" multiValued="false"/>
<field name="ZZ" type="string" indexed="true" stored="true" multiValued="true"/>
<field name="NR" type="text_cn" indexed="true" stored="true" termVectors="true" termPositions="true" termOffsets="true"/>
<field name="CJSJ" type="date" indexed="true" stored="true" />
3. 修改tomcat的server.xml配置
<Connector port="8080" protocol="HTTP/1.1"
connectionTimeout="20000"
redirectPort="8443"
maxHttpHeaderSize ="104857600" maxPostSize="0" />
注意:
maxHttpHeaderSize :设置最大上传头大小
maxPostSize:解除post提交大小限制
4. 结果

四.配置HTML及相关样式过滤器
<fieldType name="text_general" class="solr.TextField" positionIncrementGap="100">
<analyzer type="index">
<tokenizer class="solr.StandardTokenizerFactory"/>
<!-- 清除\n样式 -->
<charFilter class="solr.MappingCharFilterFactory"
mapping="mapping-FoldToASCII.txt"/>
<charFilter class="solr.HTMLStripCharFilterFactory"/><!-- 清除HTML样式 -->
<filter class="solr.StopFilterFactory" ignoreCase="true" words="stopwords.txt" />
<filter class="solr.LowerCaseFilterFactory"/>
</analyzer>
<analyzer type="query">
<tokenizer class="solr.StandardTokenizerFactory"/>
<charFilter class="solr.HTMLStripCharFilterFactory"/><!-- 清除HTML样式 -->
<filter class="solr.StopFilterFactory" ignoreCase="true" words="stopwords.txt" />
<filter class="solr.SynonymFilterFactory" synonyms="synonyms.txt"
ignoreCase="true" expand="true"/>
<filter class="solr.LowerCaseFilterFactory"/>
</analyzer>
</fieldType>
五.配置MLT文档相识度搜索
1.添加配置
<!-- Solr More like this 文件相似度搜索用到此配置 -->
<requestHandler name="/mlt" class="solr.MoreLikeThisHandler">
<lst name="defaults">
<!-- wt即writer type,即返回的数据的MIME类型,如json,xml等等 -->
<str name="wt">json</str>
<str name="fl">
ZSYBS,ZSYWT,ZSYDA,ZSBS,XH,ZSDZT,CZRBS,ZZBM,DQBM,FJFZBS,
SCJBS,ZSYWB,YXQ,YDHS,GDMB,ZSLX,CZSJ,CJSJ</str><!-- 需要返回的字段 -->
<str name="mlt.qf"> <!-- 设置 mlt.fl中的各个字段的权重 -->
ZSYWT^2.0 ZSYWB^1.0
</str>
<str name="mlt.fl">ZSYWT,ZSYWB</str><!-- 指定用于判断是否相似的字段 -->
<str name="mlt.match.include">true</str>
<!-- 指定最小的分词频率,小于此频率的分词将不会被计算在内 -->
<str name="mlt.mintf">1</str>
<!-- 指定最小的文档频率,分词所在文档的个数小于此值的话将会被忽略 -->
<str name="mlt.mindf">1</str>
<!-- 指定分词的最小长度,小于此长度的单词将被忽略。 -->
<str name="mlt.minwl">2</str>
<!-- 默认值5. 设置返回的相似的文档数 -->
<int name="mlt.count">10</int>
<str name="df">ZSYBS</str>
<str name="q.op">AND</str>
</lst>
</requestHandler>
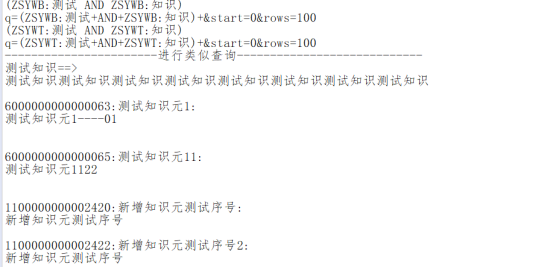
2.测试结果
六.配置SolrJ高亮展示
1. 高亮的默认配置
<!-- Highlighting defaults -->
<str name="hl">on</str>
<str name="hl.fl">content features title name</str>
<str name="hl.preserveMulti">true</str>
<str name="hl.encoder">html</str>
<str name="hl.simple.pre"><b></str>
<str name="hl.simple.post"></b></str>
<str name="f.title.hl.fragsize">0</str>
<str name="f.title.hl.alternateField">title</str>
<str name="f.name.hl.fragsize">0</str>
<str name="f.name.hl.alternateField">name</str>
<str name="f.content.hl.snippets">3</str>
<str name="f.content.hl.fragsize">200</str>
<str name="f.content.hl.alternateField">content</str>
<str name="f.content.hl.maxAlternateFieldLength">750</str>
2. 启用高亮
SolrQuery solrQuery = new SolrQuery();
solrQuery.setQuery("ZSYWT:交易电价"); //设置查询关键字
solrQuery.setHighlight(true); //开启高亮
solrQuery.addHighlightField("ZSYWT"); //高亮字段
solrQuery.addHighlightField("ZSYWB"); //高亮字段
solrQuery.setHighlightSimplePre("<font color='red'>"); //高亮单词的前缀
solrQuery.setHighlightSimplePost("</font>"); //高亮单词的后缀
solrQuery.setParam("hl.fl", "ZSYWT");
七.配置搜索关键词自动补全(汉字,拼音)
添加配置
<searchComponent name="suggest" class="solr.SuggestComponent">
<lst name="suggester">
<str name="name">mySuggester</str>
<str name="lookupImpl">FuzzyLookupFactory</str>
<str name="dictionaryImpl">DocumentDictionaryFactory</str>
<str name="field">ZSYWT_PINYIN</str><!--匹配字段,可以使用copyField实现多列-->
<!--权重,用于排序-->
<!--<str name="weightField">ZSYWB</str>-->
<str name="suggestAnalyzerFieldType">text_cn</str>
</lst>
</searchComponent>
<requestHandler name="/suggest" class="solr.SearchHandler" startup="lazy">
<lst name="defaults">
<str name="suggest">true</str>
<str name="suggest.build">true</str>
<str name="suggest.dictionary">mySuggester</str><!--与上面保持一致-->
<str name="suggest.count">10</str>
</lst>
<arr name="components">
<str>suggest</str>
</arr>
</requestHandler>
2.设置搜索字段
<!-- 设置自动补全 -->
<field name="ZSYWT_PINYIN" type="text_cn" indexed="true"
stored="true" multiValued="true"/>
<copyField source="PINYIN" dest="ZSYWT_PINYIN"/>
<copyField source="ZSYWT" dest="ZSYWT_PINYIN"/>
3.测试结果

八.搜索关键词自动纠错
代码实现:
public Collection<List<String>> getAutomaticErrorCorrection(String content)
throws SolrServerException, IOException {
HttpSolrServer server = new HttpSolrServer(url);
SolrQuery params = new SolrQuery();
params.set("qt", "/suggest");
//全部转换为拼音
StringBuilder sb = new StringBuilder();
char[] array = content.toCharArray();
for(int j=0;j<array.length;j++){
if(isChineseByBlockStyle(array[j])){
List<Pinyin> pinyinMidList = HanLP.convertToPinyinList(""+array[j]);
for (Pinyin pinyin : pinyinMidList)
{
sb.append(pinyin.getPinyinWithoutTone());
}
}else{
sb.append(array[j]);
}
}
params.setQuery(sb.toString());
QueryResponse response = null;
response = server.query(params);
SuggesterResponse suggest = response.getSuggesterResponse();
Collection<List<String>> collection = suggest.getSuggestedTerms().values();
server.close();
return collection;
}
Solr5.5高级应用(基于tomcat9)的更多相关文章
- ASP.NET MVC 随想录——探索ASP.NET Identity 身份验证和基于角色的授权,中级篇
在前一篇文章中,我介绍了ASP.NET Identity 基本API的运用并创建了若干用户账号.那么在本篇文章中,我将继续ASP.NET Identity 之旅,向您展示如何运用ASP.NET Ide ...
- ASP.NET Identity 身份验证和基于角色的授权
ASP.NET Identity 身份验证和基于角色的授权 阅读目录 探索身份验证与授权 使用ASP.NET Identity 身份验证 使用角色进行授权 初始化数据,Seeding 数据库 小结 在 ...
- Azure 标准与高级托管磁盘存储的相互转换
托管磁盘提供两种存储选项:高级(基于 SSD)和标准(基于 HDD). 它允许基于性能需求在这两个选项之间轻松切换,并保障最短停机时间. 非托管磁盘不具备此功能. 但可以轻松转换为托管磁盘,以便在这两 ...
- Apache Spark 2.2中基于成本的优化器(CBO)(转载)
Apache Spark 2.2最近引入了高级的基于成本的优化器框架用于收集并均衡不同的列数据的统计工作 (例如., 基(cardinality).唯一值的数量.空值.最大最小值.平均/最大长度,等等 ...
- ip route rule 路由策略 高级路由 捆绑 网桥
http://lwfs.net/2005/11/28/10/ #!/bin/bash IP0= IP1= GW0= GW1= NET0= NET1= DEV0=eth0 DEV1=eth1 # com ...
- OpenGL的学习资源
OpenGL是3D图形接口工业标准,使用上非常简单,所有API不过上百个函数,但理解OpenGL就没那么简单,本文总结OpenGL的学习资源,包括官方资料.网上教程.示例程序等. Wikipedia: ...
- Python学习手册(1入门知识-数据类型)
UNIX env查找技巧 在一些UNIX系统上,可以用这样一种方法避免硬编码Python解释器的路径,在文件的特定的第一行注释中写上这样一句话. #! usr/bin/env/ python...sc ...
- Android开发工具之Dash
作为一名死coder,每天最常见的动作就是查看各种API文档,你一定也有过同时打开N个窗口(HTML.PDF.CHM),不停的在编辑器与文档之间切换的感受吧?怎么说呢,其实我很讨厌这种枯燥无味的动作, ...
- Dash
作为一名死coder,每天最常见的动作就是查看各种API文档,你一定也有过同时打开N个窗口(HTML.PDF.CHM),不停的在编辑器与文档之间切换的感受吧?怎么说呢,其实我很讨厌这种枯燥无味的动作, ...
随机推荐
- 2012-2014 三年浙江 acm 省赛 题目 分类
The 9th Zhejiang Provincial Collegiate Programming Contest A Taxi Fare 25.57% (166/649) (水 ...
- 一套能体现 RBAC 的表结构设计
1.RBAC 概述 2.表结构设计 2.1.用户表 2.2.角色表 2.3.权限表 2.4.用户角色(关系)表 2.5.角色权限(关系)表 3.总结 1.RBAC 概述 RBAC(Role-Based ...
- TensorflowSharp安装和使用入门
Tensorflow是一个人工智能框架.TensorflowSharp是对Tensorflow C语言版接口的封装,便于C#开发人员在项目中使用Tensorflow. 一.使用方法 Tensorflo ...
- istio小结
一.概述 测试环境已经跑了很长时间的istio了,也更新到了最新的istio-1.1.性能相较之前提升很大,官方给出的测试数据说是延迟降低到了8ms,但是实际测试确实访问速度有很大的提升,但是确实还是 ...
- XML概念定义以及如何定义xml文件编写约束条件java解析xml DTD XML Schema JAXP java xml解析 dom4j 解析 xpath dom sax
本文主要涉及:xml概念描述,xml的约束文件,dtd,xsd文件的定义使用,如何在xml中引用xsd文件,如何使用java解析xml,解析xml方式dom sax,dom4j解析xml文件 XML来 ...
- Git 撤销所有未提交(Commit)的内容
撸了好多代码,但是突然设计改了(~~o(>_<)o ~~):或者引入个第三方库,后来又发现用不着,想删掉,但文件太多了(比如几百个):那,怎么办呢,都不想了...Git 比人聪明,所以能很 ...
- 翻译:man getopt(1)中文手册
NAME getopt - 解析命令行选项(加强版) SYNOPSIS getopt optstring parameters getopt [options] [--] optstring para ...
- [转]centos每天自动备份mysql数据库
本文转自:https://www.cnblogs.com/chongchong88/p/5566645.html #!/bin/bash PATH=/bin:/sbin:/usr/bin:/usr/s ...
- 【转载】C#检测客户端输入的内容是否含有危险字符串
用户在客户端提交的内容有时候并不可信,如果客户端提交的内容中含有危险字符串信息,则很有可能造成应用程序安全性问题,如SQL注入风险等.因此在接收客户端提交过来的数据后,我们首先需要判断数据中是否含有危 ...
- Linux服务器GlashFish的Domain管理
1.本文内容 Glassfish(V3.1)的Domain创建,删除,登陆,部署等 Linux客户端工具: SecureCRTPortable和 WinSCP (请自行下载) 2.1 新建Domain ...