
idea配置pyspark
默认python已经配好,并已经导入idea,只剩下pyspark的安装
1、解压spark-2.1.0-bin-hadoop2.7放入磁盘目录
D:\spark-2.1.0-bin-hadoop2.7
2、将D:\spark-2.1.0-bin-hadoop2.7\python\pyspark拷贝到目录Python的Lib\site-packages
3、在idea中配置spark环境变量
(1)

(2)
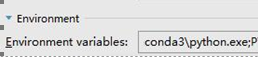
(3)

其中,需要配置的是SPARK_HOME。
如果系统中有多个版本的python,或者系统找不到python的位置,则需要配置PYSPARK_PYTHON ,我这里使用的是conda的python, E:\Program Files\Anaconda3\python.exe
(4) 安装py4j
pip install py4j
4、创建session需要注意的地方
from pyspark.sql import SparkSession

# appName中的内容不能有空格,否则报错

spark = SparkSession.builder.master("local[*]").appName("WordCount").getOrCreate()

#获取上下文

sc = spark.sparkContext

带有空格报错情况如下:

5、创建上下文,两种方式
#第一种

conf = SparkConf().setAppName('test').setMaster('local')

sc = SparkContext(conf=conf)

#第二种

sc=SparkContext('local','test')
6、实例(读取文件并打印)
from pyspark import SparkContext, SparkConf

conf = SparkConf().setAppName('test').setMaster('local')

sc = SparkContext(conf=conf)

rdd = sc.textFile('d:/scala/log.txt')

print(rdd.collect())
结果:
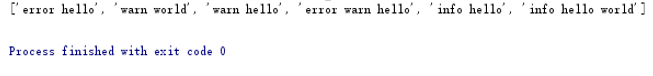
注意:还有一种错误如下所示
Java.util.NoSuchElementException: key not found: _PYSPARK_DRIVER_CALLBACK_HOST
这是因为版本的问题,可能pyspark的版本与spark不匹配
例如:

spark是2.1.0

所以当使用pip安装pyspark时需要带上版本号:

pip install pyspark==2.1.;

皆为2.1版本
idea配置pyspark的更多相关文章
- win10下Anaconda3在虚拟环境python_version=3.5.3 中配置pyspark
1. 序经过了一天的修炼,深深被恶心了,在虚拟环境中配置pyspark花式报错,由于本人实在是不想卸载3.6版的python,所以硬刚了一天,终于摸清了配置方法,并且配置成功,不抱怨了,开讲: 2. ...
- Anaconda中配置Pyspark的Spark开发环境
1.windows下载并安装Anaconda集成环境 URL:https://www.continuum.io/downloads 2.在控制台中测试ipython是否启动正常 3.安装JDK 3.1 ...
- 如何在windows下安装配置pyspark notebook
第一步:安装anaconda anaconda自带一系列科学计算包 下载链接:http://pan.baidu.com/s/1b4jWlg 密码:fqq3 接着配置环境变量:如我安装在D盘下 试一 ...
- (1)安装----anaconda3下配置pyspark【单机】
1.确保已经安装jdk和anaconda3.[我安装的jdk为1.8,anaconda的python为3.6] 2.安装spark,到官网 http://spark.apache.org/downlo ...
- pycharm中配置pyspark
1 下载官网spark-2.1.1-bin-hadoop2.7.tgz(版本自己选择),解压将文件放在了指定路径下,这个文件夹里面有python文件,python文件下还有两个压缩包py4j-some ...
- Ubuntu下导入PySpark到Shell和Pycharm中(未整理)
实习后面需要用到spark,虽然之前跟了edX的spark的课程以及用spark进行machine learning,但那个环境是官方已经搭建好的,但要在自己的系统里将PySpark导入shell(或 ...
- 大数据高可用集群环境安装与配置(09)——安装Spark高可用集群
1. 获取spark下载链接 登录官网:http://spark.apache.org/downloads.html 选择要下载的版本 2. 执行命令下载并安装 cd /usr/local/src/ ...
- Spark 的 python 编程环境
Spark 可以独立安装使用,也可以和 Hadoop 一起安装使用.在安装 Spark 之前,首先确保你的电脑上已经安装了 Java 8 或者更高的版本. Spark 安装 访问Spark 下载页面, ...
- windows下安装spark-python
首先需要安装Java 下载安装并配置Spark 从官方网站Download Apache Spark™下载相应版本的spark,因为spark是基于hadoop的,需要下载对应版本的hadoop才行, ...
随机推荐
- 复杂的POI导出Excel表格(多行表头、合并单元格)
poi导出excel有两种方式: 第一种:从无到有的创建整个excel,通过HSSFWorkbook,HSSFSheet HSSFCell, 等对象一步一步的创建出工作簿,sheet,和单元格,并添加 ...
- 初级模拟电路:4-1 BJT交流分析概述
回到目录 BJT晶体管的交流分析(也叫小信号分析)是模拟电路中的一个难点,也可以说是模电中的一个分水岭.如果你能够把BJT交流分析的原理全都搞懂,那之后的学习就是一马平川了.后面的大部分内容,诸如:场 ...
- 1(1).有监督 VS 无监督
对比一 : 有标签 vs 无标签 有监督机器学习又被称为“有老师的学习”,所谓的老师就是标签.有监督的过程为先通过已知的训练样本(如已知输入和对应的输出)来训练,从而得到一个最优模型,再将这个模型应用 ...
- 推荐系统| ① Movies概述
数据生命周期 项目系统架构 用户可视化:主要负责实现和用户的交互以及业务数据的展示,主体采用AngularJS2进行实现,部署在Apache服务上. 综合业务服务:主要实现JavaEE层面 ...
- String对象及正则表达式
1,String和string还是有区别的,一个就是用双引号或单引号包括起来的数据就是字符串,另一个本质是数组多个字符串组成的只读字符数组: 2,你说string他是数组吧,他和数组还是有点区别的,他 ...
- input函数的运用和注意 小知识点
首先先写出代码来 Name=input('请输入你的名字:') print(Name) 终端的显示如下: 请输入你的名字: 与之前的所有的函数有一个巨大的不同点,就是在终端处,我们可以输入任意的内容. ...
- Java 后台请求第三方系统接口详解
//调用第三方系统接口 PrintWriter out = null; BufferedReader in = null; JSONObject jsonObject = null; Closeabl ...
- 使用IntelliJ IDEA创建第一个Mawen项目
咳咳...首先各位在学习SSM框架的时候,单个单个学完之后,老夫掐指一算(其实,我是个小鲜肉),各位必定会去整合SSM,这个时候,老夫又掐指一算,各位必定会碰到个mawen的东西,在这里,我可以告诉各 ...
- Python实现变声器功能,萝莉音御姐音都有的哦
登录百度AL开发平台 在控制台选择语音合成 创建应用 填写应用信息 在应用列表获取(Appid.API Key.Secret Key) 6. 安装pythonsdk 安装使用Python SDK有如下 ...
- JS基础语法---内置对象
js学习中三种对象: 内置对象----js系统自带的对象 自定义对象---自己定义的构造函数创建的对象 浏览器对象---BOM的时候讲 内置对象: Math Date String Array Obj ...