
Spark 学习笔记之 aggregateByKey
aggregateByKey:
import org.apache.spark.SparkContext

import org.apache.spark.rdd.RDD

import org.apache.spark.sql.SparkSession

object TransformationsDemo {

  def main(args: Array[String]): Unit = {

    val sparkSession = SparkSession.builder().appName("TransformationsDemo").master("local[1]").getOrCreate()

    val sc = sparkSession.sparkContext

    testAggregateByKey(sc)

  }

  private def testAggregateByKey(sc: SparkContext) = {

    var data = sc.parallelize(List((1,3),(1,2),(1,4),(2,3),(3,6),(3,8)),1)

    def seq(a:Int, b:Int) : Int ={

      println("seq: " + a + "\t " + b)

      math.max(a,b)

    }

    def comb(a:Int, b:Int) : Int ={

      println("comb: " + a + "\t " + b)

      a + b

    }

    data.aggregateByKey(0)(seq, comb).collect.foreach(println)

  }

}
运行结果:
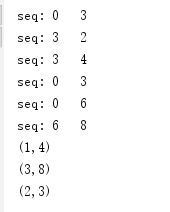
运行结果分析:
根据Key值的不同,可以分为3个组:
(1) (1,3),(1,2),(1,4);
(2) (2,3);
(3) (3,6),(3,8)。
这3个组分别进行seqOp,也就是(K,V)里面的V和0进行math.max()运算,运算结果和下一个V继续运算,以第一个组为例,运算过程是这样的:
0, 3 => 3
3, 2 => 3
3, 4 => 4
所以最终结果是(1,4)。
第二组结果是(2,3)。
第三组结果是(3,8)。
combOp是对把各分区的V加起来,由于这里并没有分区,所以实际上是不起作用的。
修改下代码,添加分区:
  private def testAggregateByKey(sc: SparkContext) = {

    var data = sc.parallelize(List((1,3),(1,2),(1,4),(2,3),(3,6),(3,8)),3)

    def seq(a:Int, b:Int) : Int ={

      println("seq: " + a + "\t " + b)

      math.max(a,b)

    }

    def comb(a:Int, b:Int) : Int ={

      println("comb: " + a + "\t " + b)

      a + b

    }

    data.aggregateByKey(0)(seq, comb).collect.foreach(println)

  }
运行结果:
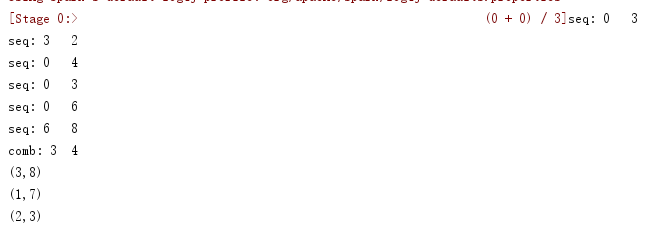
运行结果分析:
根据Key值的不同,可以分为3个区:
(1) (1,3),(1,2);
(2) (1,4),(2,3);
(3) (3,6),(3,8)。
区内先做求最大值
第一组结果是(1,3)。
第二组结果是(1,4),(2,3)。
第三组结果是(3,8)。
combOp是对把各分区的V加起来,由于此次有分区,所以(1,3)和(1,4),做合并操作,结果:(1, 7)。
Spark 学习笔记之 aggregateByKey的更多相关文章
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
- spark学习笔记总结-spark入门资料精化
Spark学习笔记 Spark简介 spark 可以很容易和yarn结合,直接调用HDFS.Hbase上面的数据,和hadoop结合.配置很容易. spark发展迅猛,框架比hadoop更加灵活实用. ...
- Spark学习笔记2(spark所需环境配置
Spark学习笔记2 配置spark所需环境 1.首先先把本地的maven的压缩包解压到本地文件夹中,安装好本地的maven客户端程序,版本没有什么要求 不需要最新版的maven客户端. 解压完成之后 ...
- Spark学习笔记3(IDEA编写scala代码并打包上传集群运行)
Spark学习笔记3 IDEA编写scala代码并打包上传集群运行 我们在IDEA上的maven项目已经搭建完成了,现在可以写一个简单的spark代码并且打成jar包 上传至集群,来检验一下我们的sp ...
- Spark学习笔记-GraphX-1
Spark学习笔记-GraphX-1 标签: SparkGraphGraphX图计算 2014-09-29 13:04 2339人阅读 评论(0) 收藏 举报 分类: Spark(8) 版权声明: ...
- Spark学习笔记3——RDD(下)
目录 Spark学习笔记3--RDD(下) 向Spark传递函数 通过匿名内部类 通过具名类传递 通过带参数的 Java 函数类传递 通过 lambda 表达式传递(仅限于 Java 8 及以上) 常 ...
- Spark学习笔记0——简单了解和技术架构
目录 Spark学习笔记0--简单了解和技术架构 什么是Spark 技术架构和软件栈 Spark Core Spark SQL Spark Streaming MLlib GraphX 集群管理器 受 ...
- Spark学习笔记2——RDD(上)
目录 Spark学习笔记2--RDD(上) RDD是什么? 例子 创建 RDD 并行化方式 读取外部数据集方式 RDD 操作 转化操作 行动操作 惰性求值 Spark学习笔记2--RDD(上) 笔记摘 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
随机推荐
- 百度之星初赛A轮 A 度度熊拼三角 贪心
度度熊拼三角 Accepts: 2536 Submissions: 4433 Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 6553 ...
- codeforces 808 E. Selling Souvenirs (dp+二分+思维)
题目链接:http://codeforces.com/contest/808/problem/E 题意:最多有100000个物品最大能放下300000的背包,每个物品都有权值和重量,为能够带的最大权值 ...
- R语言基础入门
请先安装好R和RStudio 如果不干别的,控制台就是一个内置计算器 2 * 3 #=> 6 sqrt(36) #=> 6, square root log10(100) #=> 2 ...
- 3、pytest中文文档--编写断言
目录 编写断言 使用assert编写断言 编写触发期望异常的断言 特殊数据结构比较时的优化 为失败断言添加自定义的说明 关于断言自省的细节 复写缓存文件 去使能断言自省 编写断言 使用assert编写 ...
- Dapper学习(二)之Query相关
0. FIrst , Single & Default 使用这个方法时要小心,First 和 Single 是不同的. 这里,对这个表做下说明: 如果使用 First , 当没有查到元素时,会 ...
- Vue兄弟组件通信
Vue兄弟组件通信之借助中央事件总线 下载链接:https://www.yinxiangit.com 其实要实现兄弟组件通信,就算是通过父子组件通信的方式也是可以达到的,如 子 ——>父——&g ...
- 049 模块6-wordcloud库的使用
目录 一.wordcloud库基本介绍 1.1 wordcloud库概述 1.2 wordcloud库的安装 二.wordcloud库使用说明 2.1 wordcloud库基本使用 2.2 wordc ...
- android 定时提醒 - Notification
定时弹出 demo ,代码如下: 1.MainActivity.java public class MainActivity extends Activity implements OnClickLi ...
- 面试贴:java异常小结
java的异常处理在面试中通常是个敏感的话题,这里我从整体框架方面稍微作一下我的小结. java的异常都继承Throwable这个类,也就是都可以抛出来的异常,在这个祖先类下,又分为如下子类: 1.E ...
- setuptools的安装
Python 2.x: sudo apt-get install python-setuptools (python2.x版本执行此命令) Python 3.x: su ...