
《master the game of GO wtth deep neural networks and tree search》研究解读
现在”人工智能“如此火爆的一大直接原因便是deepmind做出的阿尔法狗打败李世石,从那时开始计算机科学/人工智能成为了吹逼的主流。记得当时还是在学校晚新闻的时候看到的李世石输的消息,这个新闻都是我给打开的hhhhh,对当时场景的印象还是蛮深的。现在涵哥就带大家追根溯源,看看把人工智能推上吹逼大道的研究与技术到底是怎么一回事。
在研读aphago工作原理前建议先学完david silver的RL基础课,这样读起来才有意思。
文章分了五个小块,分别是:
supervised learning of policy networks
reinforcement learning of policy networks
reinforcement learning of value networks
searching with policy and value networks
evaluating the playing strength of AlphaGO
如果用一句话说明白alphaGO是怎么工作的,那应该是“combines the policy and value network with MCTS”.
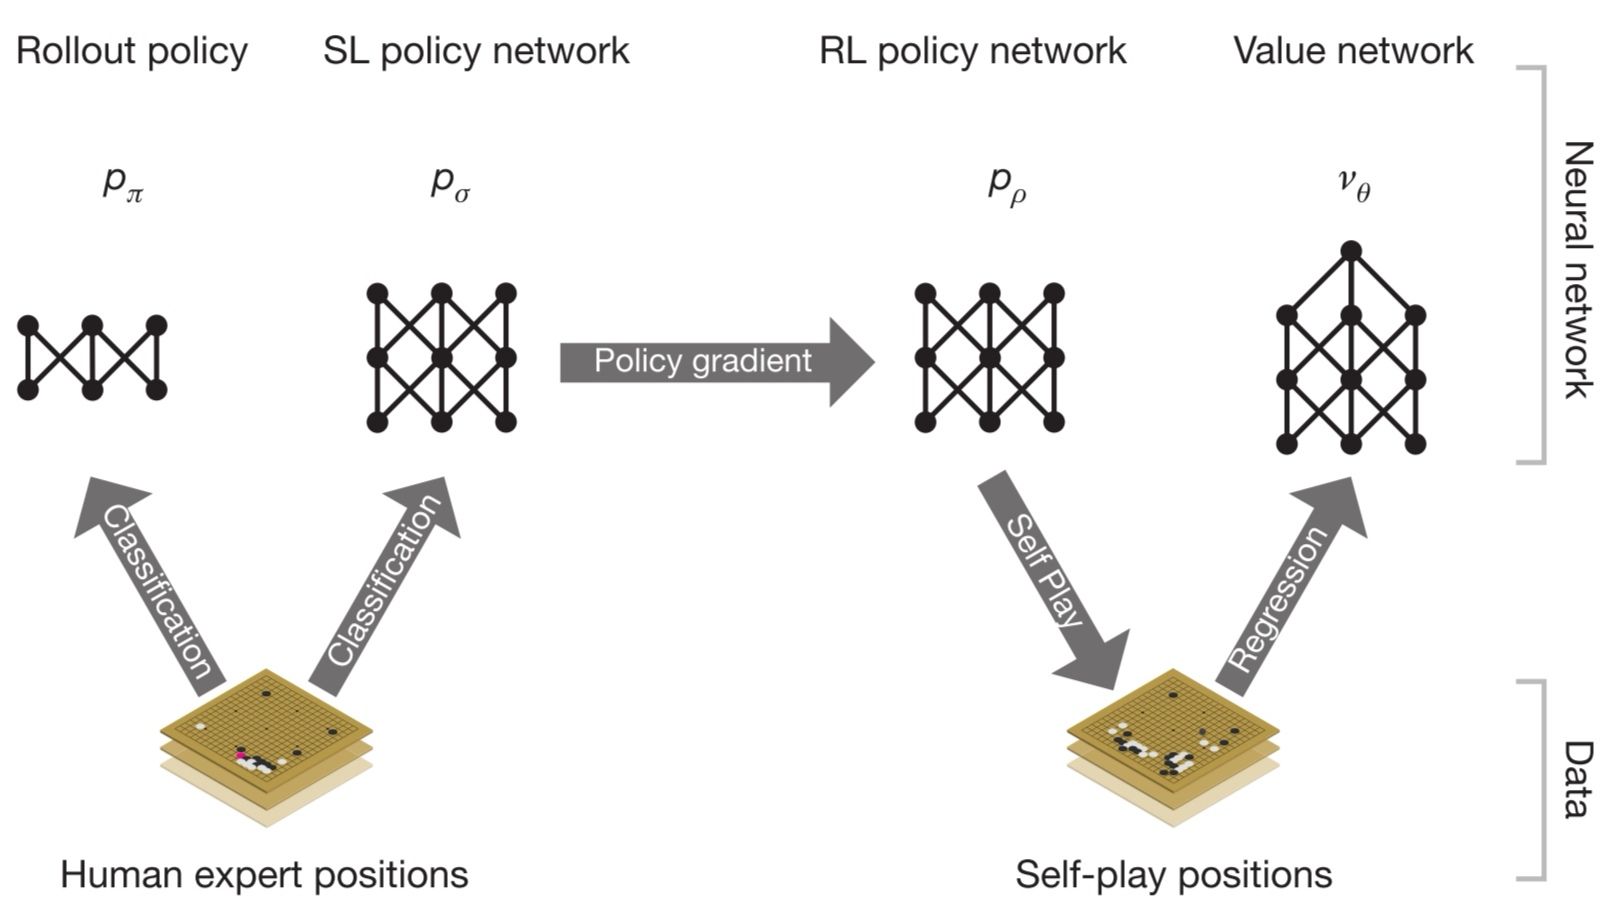
我们先从最基础的policy approximator引入。supervised learning of policy network 是一个由CNN+rectifier_nonlinearities+softmax组成的十三层的神经网络,输入the board state representation也就是当前的棋盘图像(用s表示),输出a probability distribution over all legal moves也就是选择所有符合规则的下一步走法中每一种的可能性(用a表示)。训练数据集来自KGS GO Sever即库存的人类大师对局,采用随机梯度上升法(SGA)进行训练优化————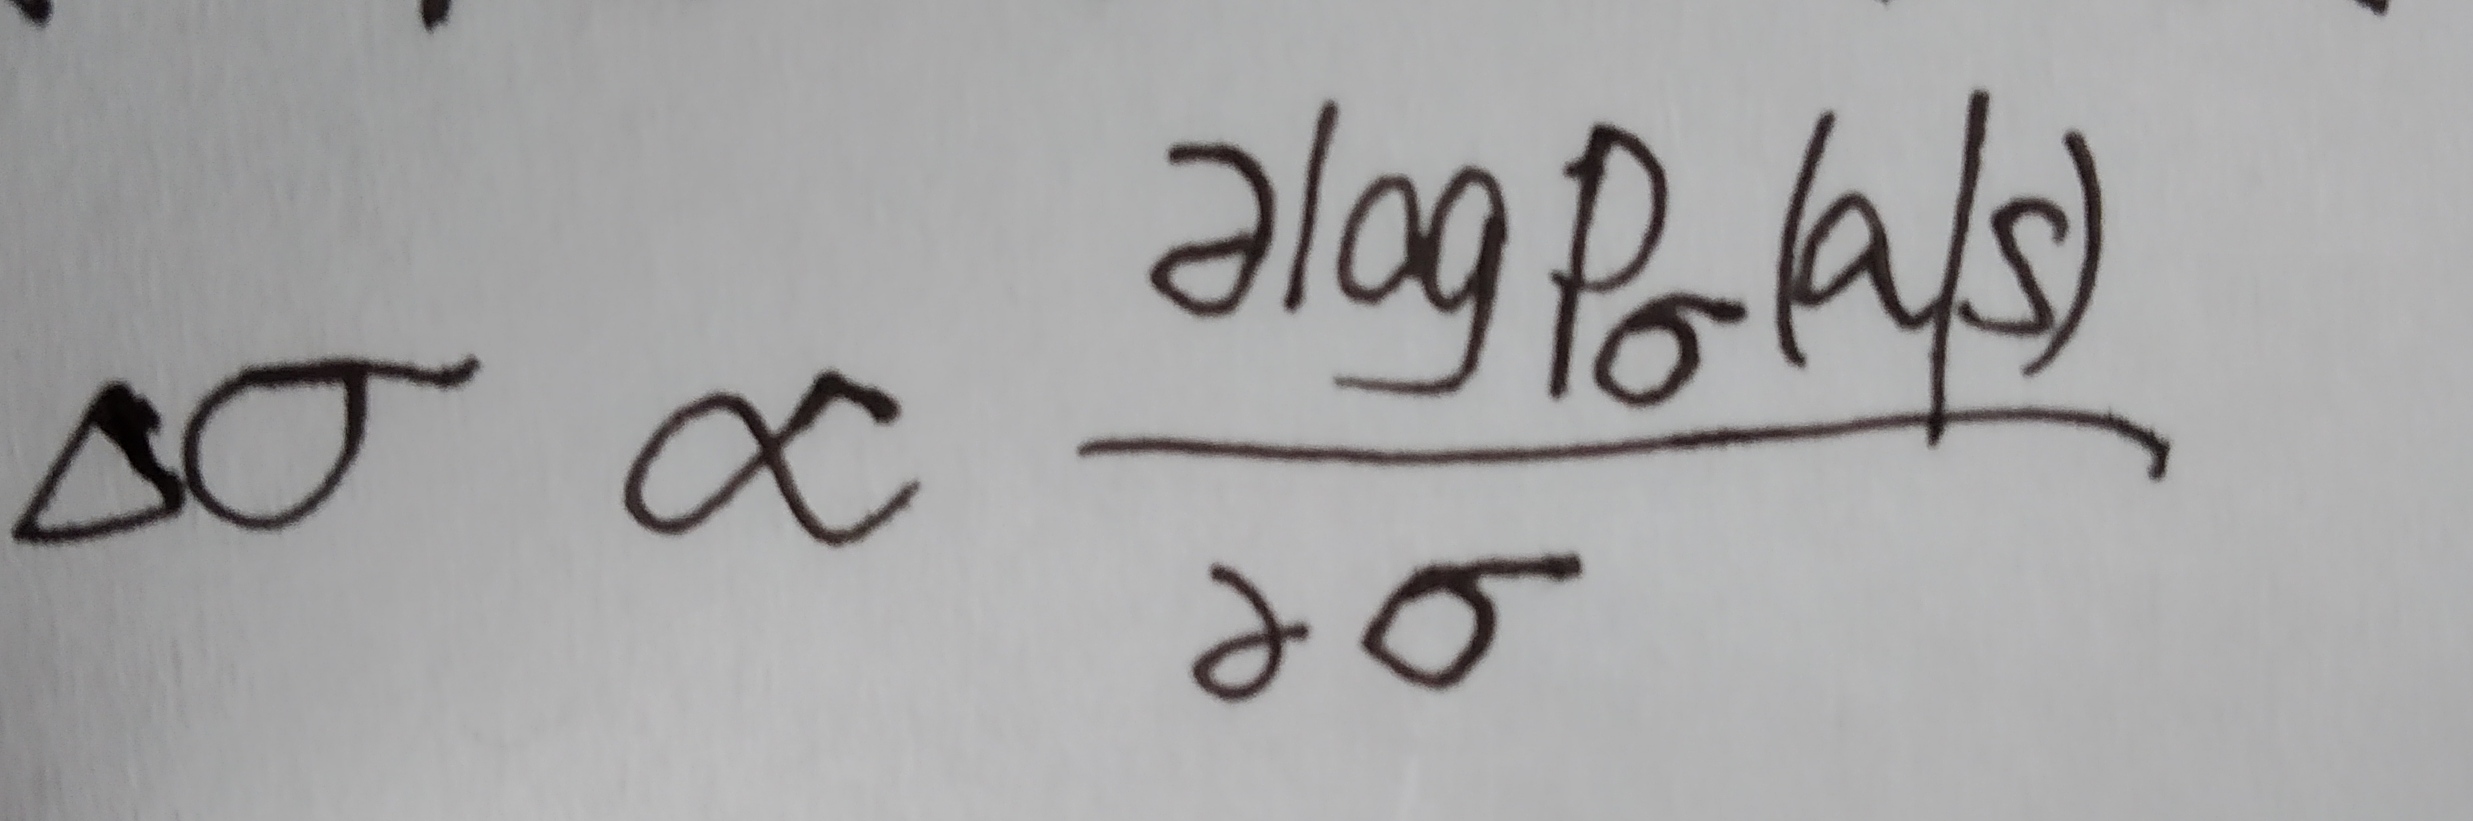 。
因为对SLpolicynetwork太笨重不满意,deepmind又训练了rollout policy,a linear softmax of small pattern features with weight pai,它极度快速,延时只有2μs,而policy network需要3ms。
有了第一阶段的尝试,我们把policy gradient拿来用,进入第二阶段。用pρ 表示我们的RL policy network,其结构与pσ 相同,参数初始化为ρ=σ,训练数据通过self play产生。wew play games between the current pρ and a random selected previous iteration of pρ ,也就是说通过当前迭代版本的pρ 和随机选择的先前迭代版本的pρ 之间对局产生训练数据,然后用SGA方法优化pρ ——————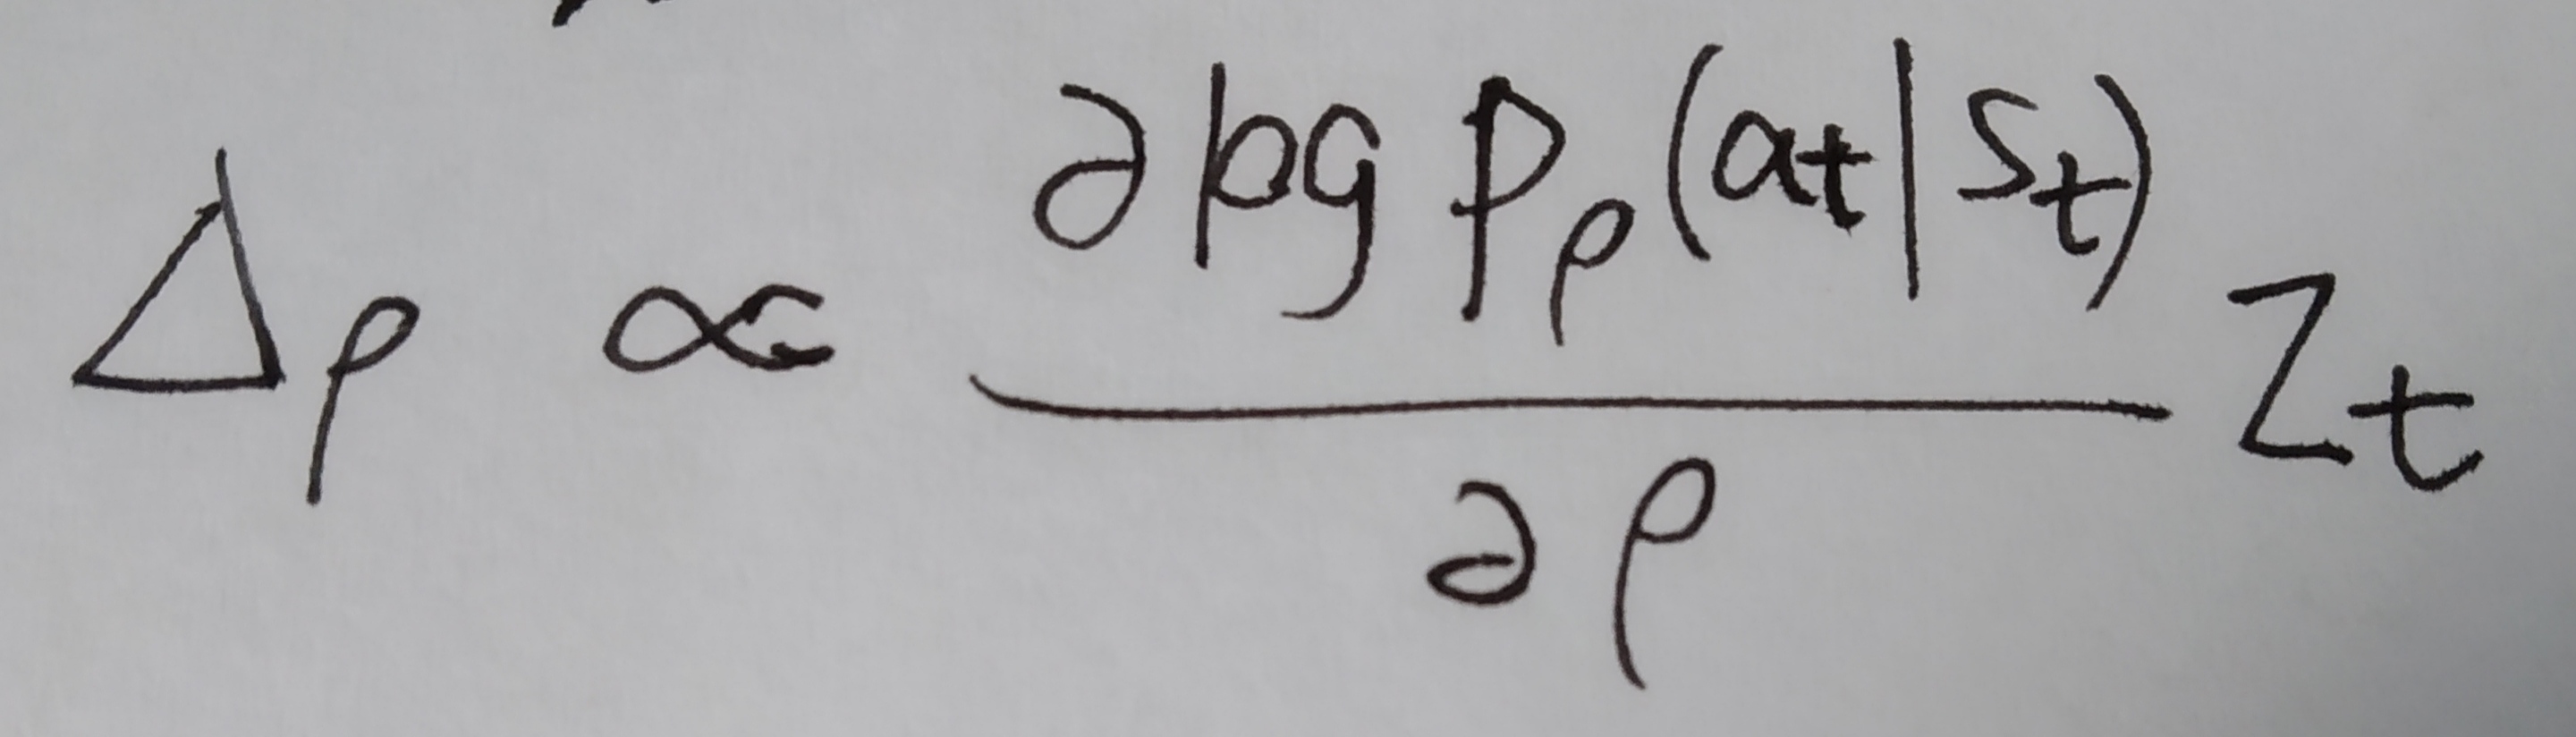 。
接下来进入training pipeline的最后阶段,以position evaluation为核心。在此之前我们已经把policy network做好了,也就是准备好了"策略",然后需要有一套对当前棋局的评估器,来评估从当前棋局出发依照策略p最后结果输还是赢。estimating a value function vp(s) that predicts the outcome from position s of game played by using policy p for both players。vp(s) = E[zt|st=s,at...T ~p] 。
We approximate the value function using a value network vθ(s) with weight θ , vθ(s) ≈ vpρ(s) ≈ v*(s) 。vθ(s) 结构和pρ (s)大致相似,只是输出为一个单纯的回归。训练时以state-outcome pairs (s,z)的regression作数据集,通过SGD最小化vθ(s)和corresponding outcome z之间的MSE来优化参数——————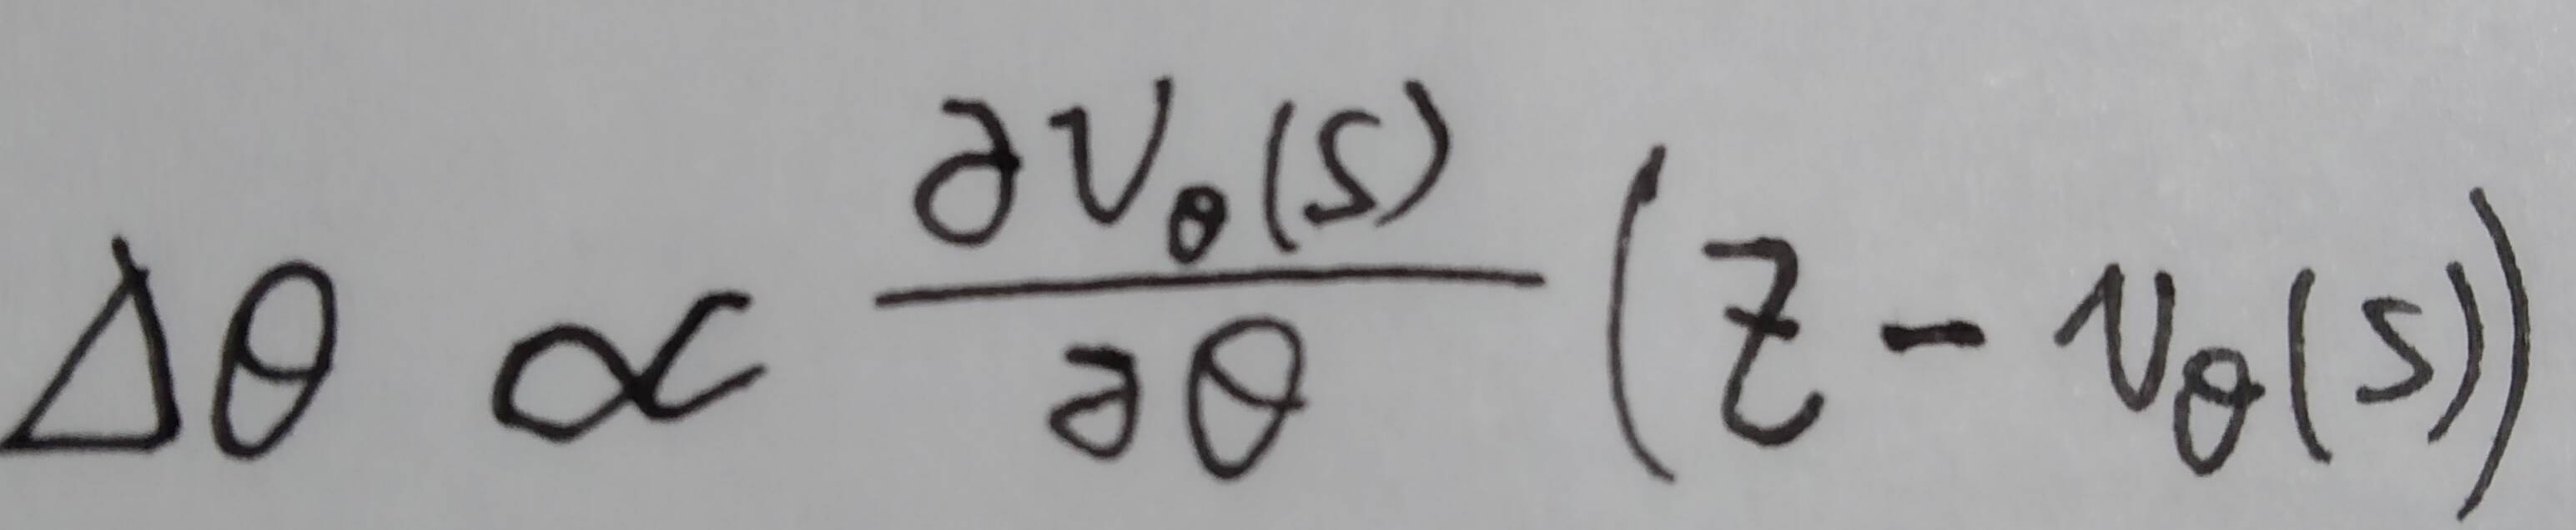 。
到现在准备好了策略policy和价值评估器value network,是时候借助蒙特卡洛树搜索(MCTS)对全局建模了。
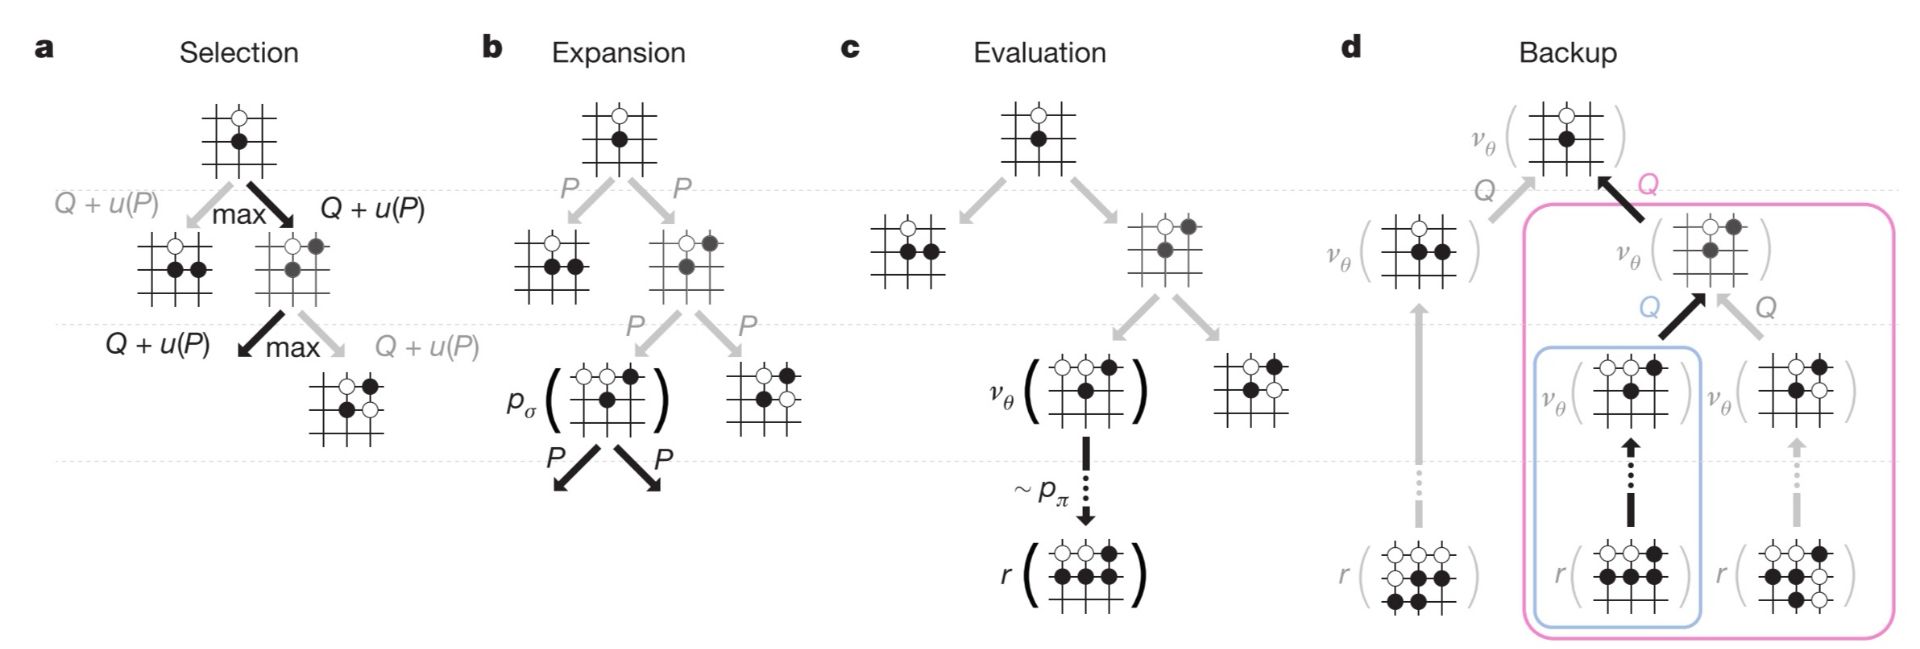
AlphaGO 用MCTS将policy network 和value network结合到一起,通过MCTS的前向搜索选择下一步的行为(就是下一步棋落到哪)。"MCTS with policy and value networks"包含四个核心操作,分别是select,expansion,evaluation,backup。
搜索树的每条边(s,a)存储着action value Q(s,a),visit count N(s,a)和prior probability P(s,a),每个节点是棋局的state。从树根state开始,通过simulation即模拟对局(没有备份操作的完整对局episode)遍历这棵树。对于任意simulation的每个时间步,基于at = argmax( Q(st,a) + u(st,a) )选择action,其中 。对于每一场simulation————遍历走到叶子节点sL时如果还没到simulation的END便进行expansion操作向下扩展。P(s,a)=pσ(a|s)。到达当前simulation的END时,通过V(sL)来评估叶子节点——V(sL) = (1- λ )vθ(sL) + λzL 。vθ(sL)用了value network,zL 是基于rollout policy pπ 一直下到结束的outcome。回看,backup,更新这一场simulation所走过的所有边。每条边的visit count和mean evaluation对从它这儿走过的所有simulations进行累加,si L 表示第i次simulation(总共做了n次simulations)的叶子节点,1(s,a,i)表示第i次simulation的时候(s,a)这条边是否被走过。
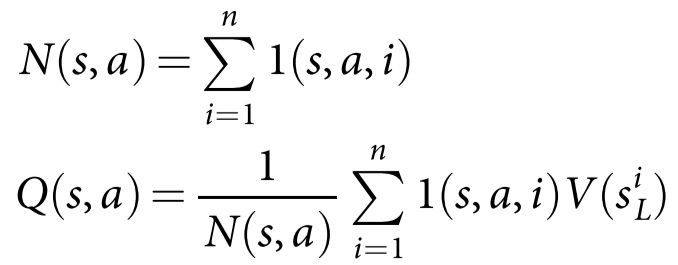
search做完之后,从根结点位置选择访问次数最多的move。至此我们的AlphaGO就正式出道了,这时我仿佛听到上天对它说了句——开始你牛逼闪闪发光的一年吧!
另外deepmind还提到了他们在研究中发现的一个有意思现象:SL policy network比RL policy network表现好,而RL value network 比SL policy network 表现好,作者说“persumably because humans select a diverse beam of promising moves,whereas RL optimizes for the single best move”哈哈哈。
为了培(xun)养(lian)AlphaGO,他的父亲(deepmind)不惜砸重金,采用异步MCTS,40个搜索线程在48个CPU上做simulations,用8个并行计算GPU训练神经网络。另外deepmind也尝试了分布式MCTS,使用了40个搜索线程,1202个CPU,176个GPU。
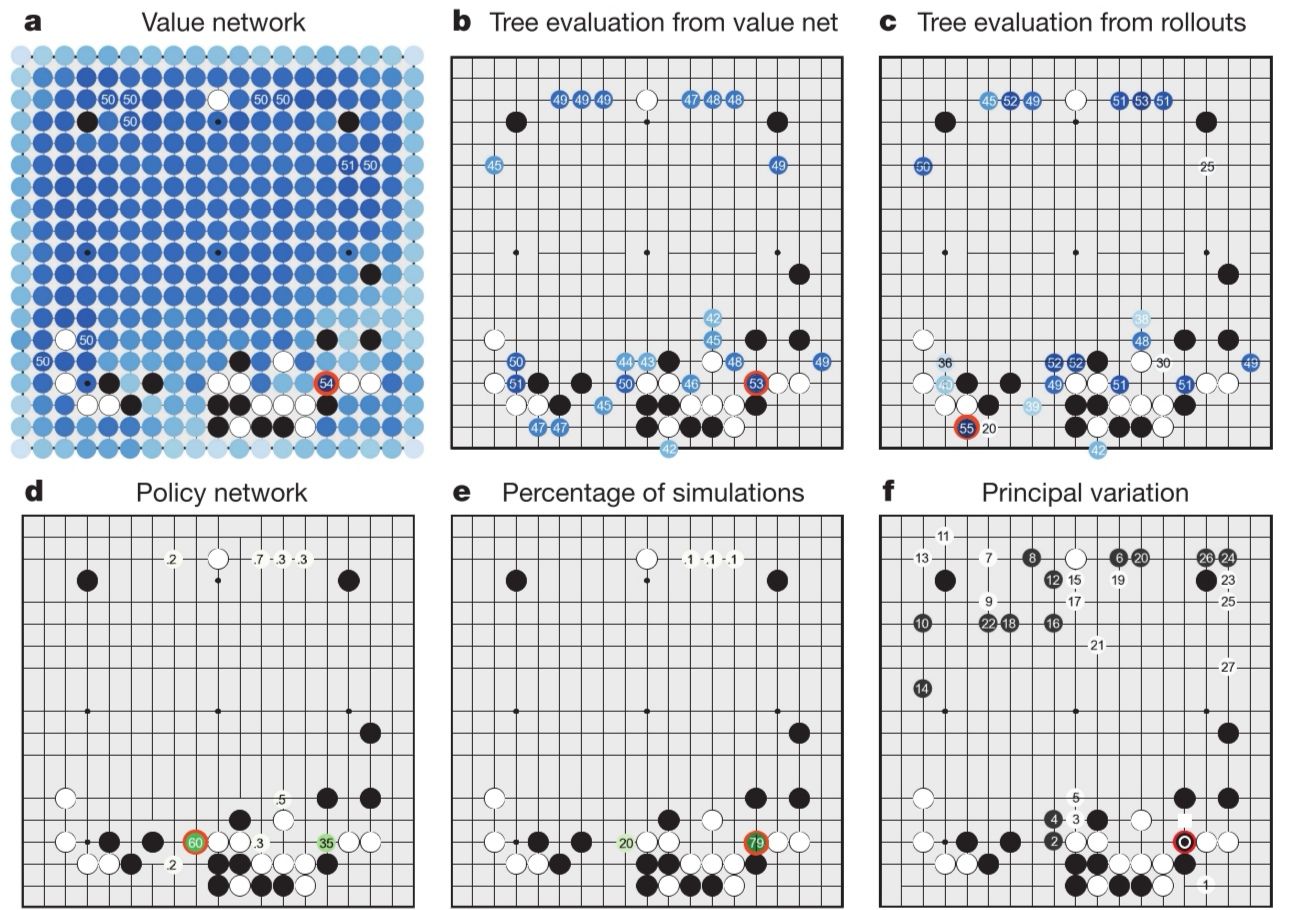
“evaluating the playing strength of AlphaGO”这一小段我不想说了,王婆卖瓜自卖自夸,谁爱看自己去看吧。
注:对于具体method我没做太多分享,但以后想写了可能还会补充一些,我觉得alphaGO的突破之处在于成功用MCTS把policy network和value network结合到了一起。再厉害它也是在前人的基础上做的,并不是自己另辟新路,技术的发展一贯如此。至于本文为啥中英文混体,是因为我思前想后拿不定主意一些地方该怎么用纯中文来表达,这些地方英文来表达是最能传达本意的,所以直接从论文上撸下来了,莫怪莫怪。最后建议自己读一下《master the game of go with deep neaural network and tree search》的原文。链接:https://www.nature.com/articles/nature16961.pdf
《master the game of GO wtth deep neural networks and tree search》研究解读的更多相关文章
- 论文笔记:Mastering the game of Go with deep neural networks and tree search
Mastering the game of Go with deep neural networks and tree search Nature 2015 这是本人论文笔记系列第二篇 Nature ...
- Mastering the game of Go with deep neural networks and tree search浅析
Silver, David, et al. "Mastering the game of Go with deep neural networks and tree search." ...
- AlphaGo论文的译文,用深度神经网络和树搜索征服围棋:Mastering the game of Go with deep neural networks and tree search
转载请声明 http://blog.csdn.net/u013390476/article/details/50925347 前言: 围棋的英文是 the game of Go,标题翻译为:<用 ...
- 论文翻译:2018_Source localization using deep neural networks in a shallow water environment
论文地址:https://asa.scitation.org/doi/abs/10.1121/1.5036725 深度神经网络在浅水环境中的源定位 摘要: 深度神经网络(DNNs)在表征复杂的非线性关 ...
- Classifying plankton with deep neural networks
Classifying plankton with deep neural networks The National Data Science Bowl, a data science compet ...
- Training (deep) Neural Networks Part: 1
Training (deep) Neural Networks Part: 1 Nowadays training deep learning models have become extremely ...
- [C4] Andrew Ng - Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization
About this Course This course will teach you the "magic" of getting deep learning to work ...
- Training Deep Neural Networks
http://handong1587.github.io/deep_learning/2015/10/09/training-dnn.html //转载于 Training Deep Neural ...
- On Explainability of Deep Neural Networks
On Explainability of Deep Neural Networks « Learning F# Functional Data Structures and Algorithms is ...
随机推荐
- 使用 pdf.js 跨域问题的处理方法1
在<使用 pdf.js 在网页中加载 pdf 文件>中详细介绍了 pdf.js 的使用与集成网页开发的基本方法.展示效果如下图: 站点的目录为 http://localhost:8033/ ...
- 通过FeignClient接收shaded的javabean的JSON序列化
问题说明 最近做了关于flink的需求. 现在需要通过HTTP访问FLINK的 RESTAPI, rest 接口的JSON 非常庞大而复杂. 那么怎么去完整的接收数据呢? 方法一就是手写部分需要的Ja ...
- ArcGIS制作地形图【详细步骤】
结果图: 详细步骤: 一.在ArcSence中加载带有投影坐标系的dem数据 Dem的属性设置为下图可有上面的效果. 二.提取栅格范围 找到工具[3D Analyst][转换][栅格范围]双击打开设置 ...
- django-个人网站之环境配置(一)
1.建立django项目 django-admin startproject myblog 2.进入myblog目录 建立app存储自己的基本信息 python manage.py startapp ...
- Pandas | 17 缺失数据处理
数据丢失(缺失)在现实生活中总是一个问题. 机器学习和数据挖掘等领域由于数据缺失导致的数据质量差,在模型预测的准确性上面临着严重的问题. 在这些领域,缺失值处理是使模型更加准确和有效的重点. 使用重构 ...
- UNIX环境高级编程 使用方法
1.解压文件到apue.2e目录2.修改相应平台的文件,我使用的是linux,所以修改Make.defines.linux你修改的只需要这一行WKDIR=/home/your_dir/apue2e_s ...
- Pyhton网络爬虫之CrawlSpider
一.什么是CrawlSpider? 在学习CrawlSpider之前如果我们想爬取某网站前100页的内容的话,我们可以使用的方法是通过Request模块手动发起请求,递归调用parse方法,写起来非常 ...
- 学习笔记16_页面缓存/进程外Session
*页面缓存:适用于访问量较高的网站 <%@OutputCache Duration="15"//缓存15秒 VaryByParam='*' //请求的任何一处发生改变,缓存 ...
- 原生JS封装_new函数,实现new关键字的功能
1.前言 众所周知:没有对象怎么办?那就new一个! 那么在JS中,当我们new一个对象的时候,这个new关键字内部都干了什么呢? 现在我们就来剖析一下原生JS中new关键字内部的工作原理. 2.原生 ...
- Python基本数据结构之文件操作
用word操作一个文件的流程如下: 1.找到文件,双击打开 2.读或修改 3.保存&关闭 用python操作文件也差不多: f=open(filename) # 打开文件 f.write(&q ...