
Presto: SQL on Everything
Presto是FB开源出来的实时分析引擎,可以federated的从多种数据源去读取数据,做联合查询,支持实时Interactive BI或bath ETL的需求
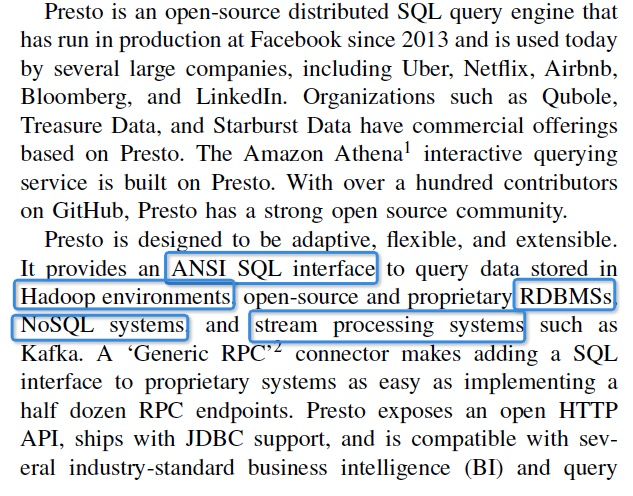

从其问题域来看,基本是和spark是重合的,那么两者区别是什么?
https://stackoverflow.com/questions/50014017/why-presto-is-faster-than-spark-sql

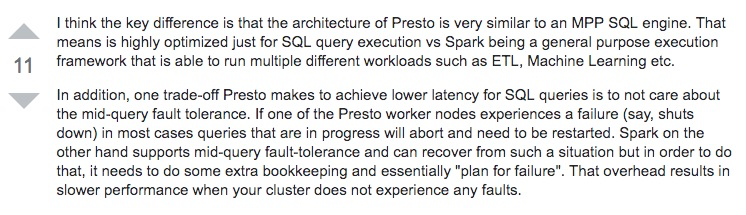
这两个答案说的比较清楚,
所以可以看出,Presto并没有什么创新的东西,对于Spark而言,主要是做减法,降低overhead,提升性能
所以Presto更偏实时一些,更适用于MPP的场景,较为简单的SQL
Presto的架构和查询流程,都是典型的MPP方式
特点是,执行都是pipeline的方式,所有中间数据和状态都放在内存中,这样比spark那样落盘,再读出的方式要快
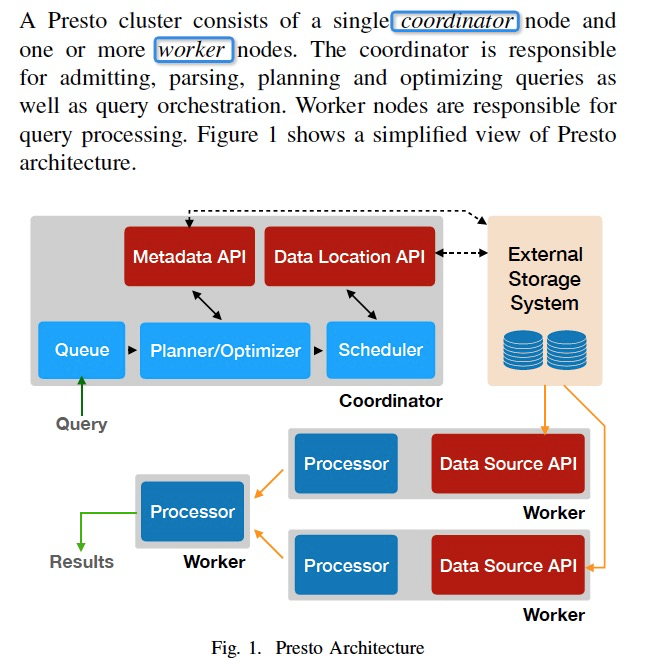

查询过程,
首先是parsing,并形成逻辑计划,
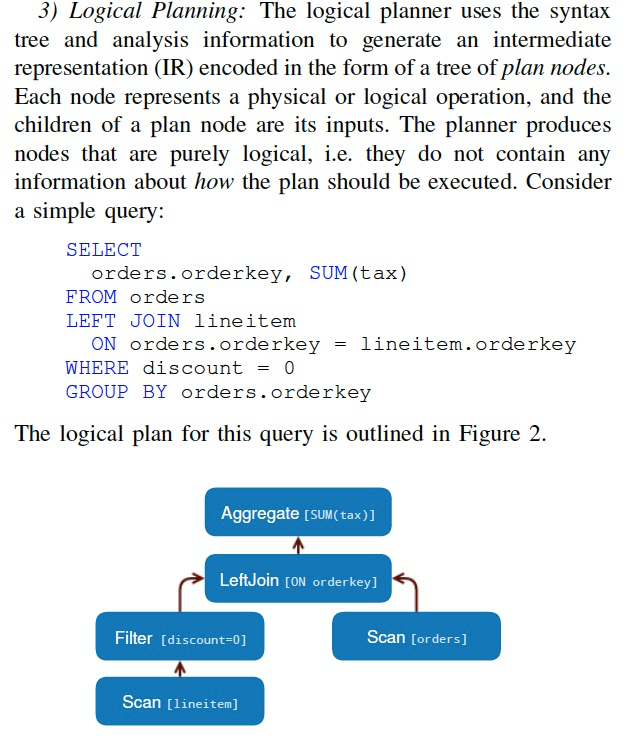
接着是查询优化,和生成物理执行计划
Presto的查询优化没啥创新的
需要注意的是,
首先他也有stage的概念,和spark一样,stage里面可以直接local完成的,所以上面的逻辑计划,
被分成5个stage,stage之间需要shuffle,做过流系统的都知道,一旦shuffle,性能就不行了,对cpu,网络,buffer的消耗都很大
Inter-node,节点间的并行,通过在不同的worker上并行相同的task,处理不同的数据split
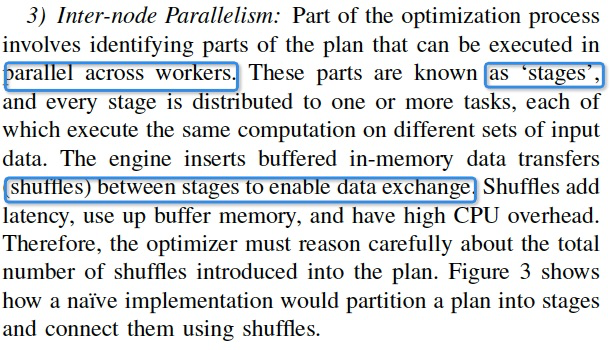
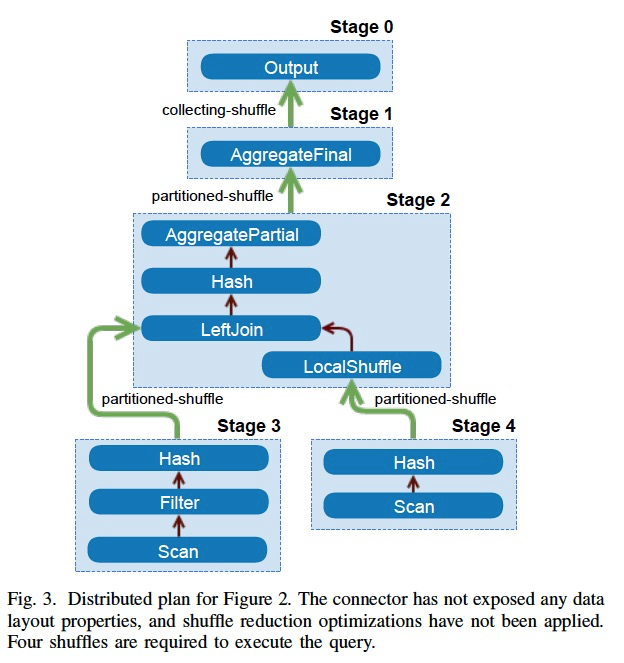
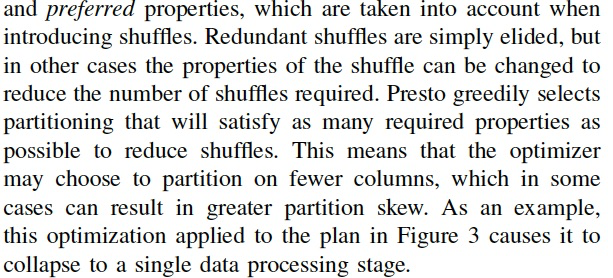
所以思路一定是要尽量减少shuffle,思路也比较直观,比如做join,如果相同join id的数据都在一个节点,就不用shuffle
这个就叫,Data Layout Properties,数据分布

还有,Node Properties,根据node的属性来,减少不必要的shuffle,合并stage
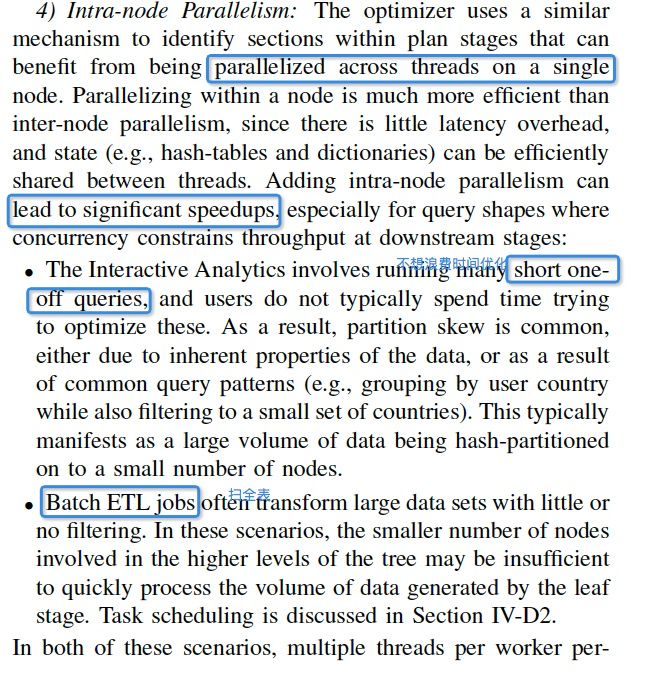
再者,看看Intra-node,节点内的并行,通过thread,这个应该是Presto的特点,可以大大提升查询性能
右图可以看出,在pipeline1,pipeline2中加了很多并发的thread来并行的做
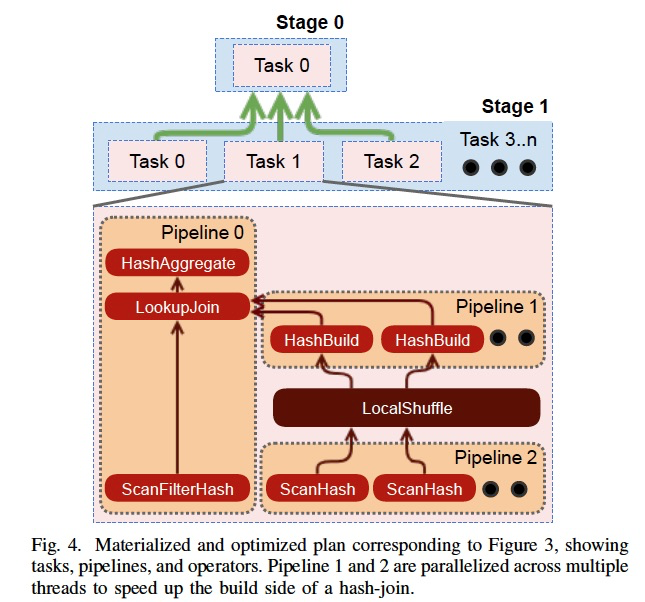
计划生成完后,就是调度,
Coordinator将plan stages以可执行tasks,分发到各个workers上去,task一个执行单元
Task中又包含很多pipelines,pipeline由operators组成
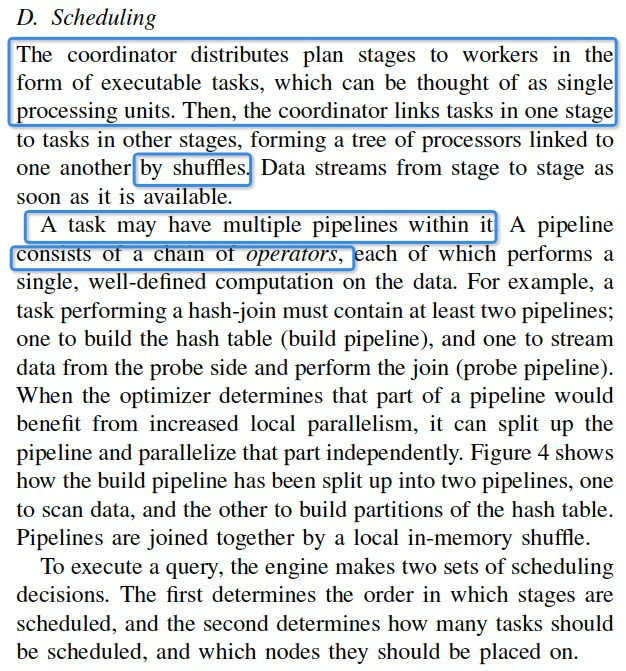
调度分为3种,
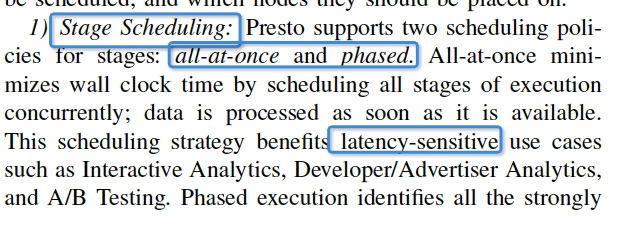
Stage调度,可以all in,或分阶段
all in,延迟会小,但会耗费更多的资源
Task Scheduling,

Split Scheduling
最终还要给各个leaf stage分配splits,因为leaf stage必须要被分配splits后才能启动
presto这里的优化,先只会enumerate一小批的splits,分配给各个task,不会一下把所有的splits都捞出来分配,优点下面也说了


调度完,最后就是执行
Query Execution
开始执行,driver loop开始pass split
这里产生page的概念,source从split读出的结构就是pages,Operator的输入输出也是pages,类似spark中的RDD
从右图可以看出,page是一种以column方式组织的结构,便于AP


第二步是shuffle,
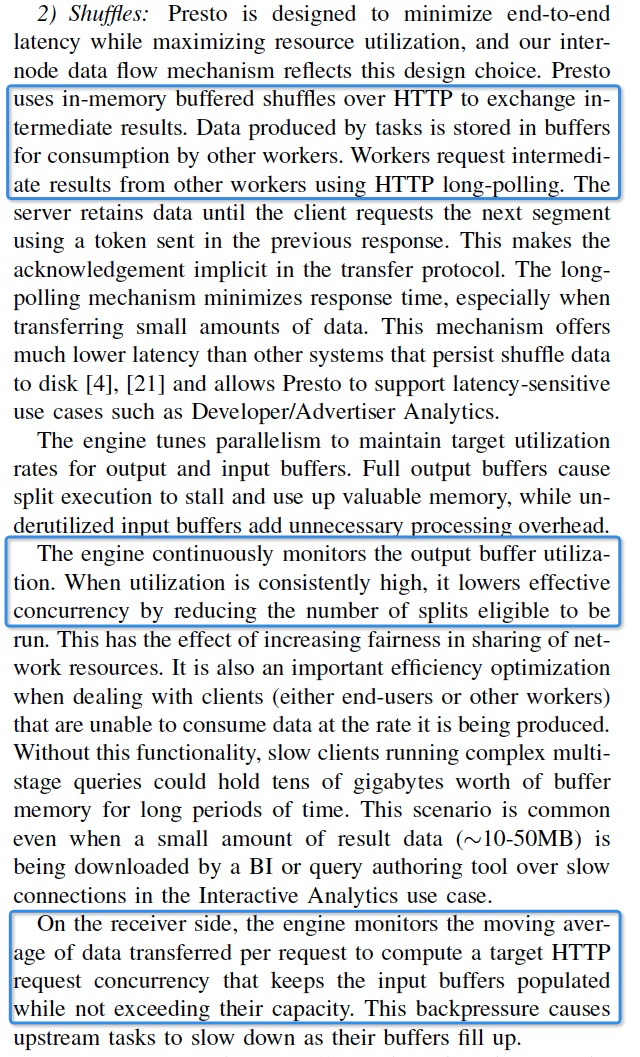
presto是延迟优先的,所以shuffle的中间结果不能落盘,放在memory buffer里面
其他worker通过Http Long-Polling的方式来拉数据
同时要监控,output和input的buffer的使用情况,来调整并发,避免内存占用过高
output buffer太大了,让写并发降一些,如果input buffer太大,让读并发降些,这样也会触发前面的写并发的反压
最后是把结果写出,
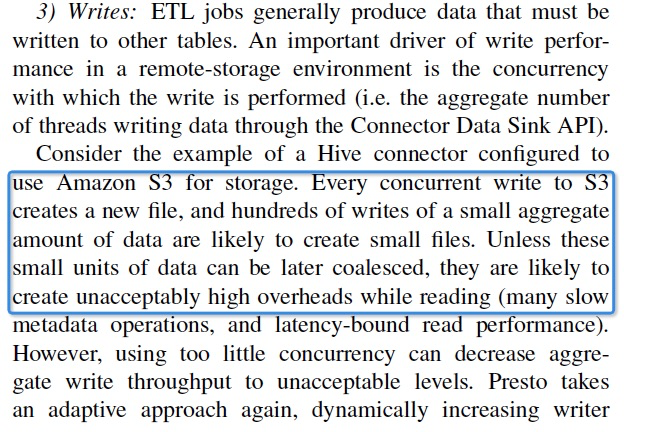
写吞吐如果要高,多开写并发,但是写并发高,对存储的要求就比较高,
比如对于S3,每个并发都需要写一个文件,会导致很多小文件,查询起来就很麻烦
Presto采用的是adaptive来决定写并发
Presto: SQL on Everything的更多相关文章
- Hive sql和Presto sql的一些对比
最近由于工作上和生活上的一些事儿好久没来博客园了,但是写博客的习惯还是得坚持,新的一年需要更加努力,困知勉行,终身学习,每天都保持空杯心态.废话不说,写一些最近使用到的Presto SQL和Hive ...
- facebook Presto SQL分析引擎——本质上和spark无异,分解stage,task,MR计算
Presto 是由 Facebook 开源的大数据分布式 SQL 查询引擎,适用于交互式分析查询,可支持众多的数据源,包括 HDFS,RDBMS,KAFKA 等,而且提供了非常友好的接口开发数据源连接 ...
- 探究Presto SQL引擎(3)-代码生成
vivo 互联网服务器团队- Shuai Guangying 探究Presto SQL引擎 系列:第1篇<探究Presto SQL引擎(1)-巧用Antlr>介绍了Antlr的基本用法 ...
- 探究Presto SQL引擎(4)-统计计数
作者:vivo互联网用户运营开发团队 - Shuai Guangying 本篇文章介绍了统计计数的基本原理以及Presto的实现思路,精确统计和近似统计的细节及各种优缺点,并给出了统计计数在具体业务 ...
- 探究Presto SQL引擎(1)-巧用Antlr
一.背景 自2014年大数据首次写入政府工作报告,大数据已经发展7年.大数据的类型也从交易数据延伸到交互数据与传感数据.数据规模也到达了PB级别. 大数据的规模大到对数据的获取.存储.管理.分析超出了 ...
- presto的动态化应用(一):presto节点的横向扩展与伸缩
一.presto动态化概述 近年来,基于hadoop的sql框架层出不穷,presto也是其中的一员.从2012年发展至今,依然保持年轻的活力(版本迭代依然很快),presto的相关介绍,我们就不赘述 ...
- Presto 学习
Presto 基础知识与概念学习可以参考这些博客: presto 0.166概述 https://www.cnblogs.com/sorco/p/7060166.html Presto学习-prest ...
- presto调研和json解析函数的使用
presto简单介绍 presto是一个分布式的sql交互式查询引擎.可以达到hive查询效率的5到10倍.支持多种数据源的秒级查询. presto是基于内存查询的,这也是它为什么查询快的原因.除了基 ...
- sqlalchemy presto 时间比较
大数据统计时,需要计算开仓订单减掉经纪商时间差,等于n 小时 或 星期几的订单. presto sql语句如下: select sum(profit) from t_table where open_ ...
随机推荐
- Apache加固之目录、文件限制
如果你用类似phpstudy集成平台的话,所有你想要修改的配置基本上在phpstudy上就可以直接设置操作.但如果你的服务器是通过一步步安装的(Apache+PHP+Mysql)的话,那么就要对各功能 ...
- 英语muttonfatjade羊脂玉muttonfatjade单词
羊脂玉英文(mutton fat jade) 中文名羊脂玉 外文名muttonfatjade 羊脂玉又称白玉,为软玉中之上品,极为珍贵.主要含有透闪石(95%).阳起石和绿帘石.非常洁白,质地细腻,光 ...
- android中如何实现UI的实时更新---需要考虑电量和流量
1.如果不考虑电量和流量的话,只需要在对应的activity里面继承Runnable,在run方法里面写一个while死循环,调用接口返回数据,如果数据发生了变化,就立即更新UI 2.需要考虑电量的话 ...
- Shell 编程 case语句
本篇主要写一些shell脚本case语句的使用. 字符判断 #!/bin/bash read -p "请输入一个字符:" char case $char in [a-z]|[A-Z ...
- Django 之 restframework 版本控制的使用以及源码分析
Django rest_framework 之 版本控制 一.何为版本控制: 用于版本的控制 二.内置的版本控制类: from rest_framework.versioning import Q ...
- h5 js复制 功能
感谢 http://www.jq22.com/webqd6003 var copy1 = document.getElementById('copy1'); var copy2 = document. ...
- uboot是什么
u-boot是一种普遍用于嵌入式系统中的Bootloader,Bootloader是在操作系统运行之前执行的一小段程序,通过它,我们可以初始化硬件设备.建立内存空间的映射表,从而建立适当的软硬件环境, ...
- 第十一周LINUX 学习笔记
keepalived keepalived: 基于vrrp(虚拟冗余路由协议)的实现 virtual server: 对于IPVS vrrp_script: 调用外部脚本 ngin ...
- Python调用百度接口(情感倾向分析)和讯飞接口(语音识别、关键词提取)处理音频文件
本示例的过程是: 1. 音频转文本 2. 利用文本获取情感倾向分析结果 3. 利用文本获取关键词提取 首先是讯飞的语音识别模块.在这里可以找到非实时语音转写的相关文档以及 Python 示例.我略作了 ...
- 使用 application.properties 中配置的属性,举例:@Value("${server.port}")
使用 application.properties 中配置的属性:@Value 注解. @RestController public class HelloWorldController { @Val ...