
爬虫之scrapy框架应用selenium
一、利用selenium 爬取 网易军事新闻
使用流程:
'''

在scrapy中使用selenium的编码流程:

    1.在spider的构造方法中创建一个浏览器对象(作为当前spider的一个属性)

    2.重写spider的一个方法closed(self,spider),在该方法中执行浏览器关闭的操作

    3.在下载中间件的process_response方法中,通过spider参数获取浏览器对象

    4.在中间件的process_response中定制基于浏览器自动化的操作代码(获取动态加载出来的页面源码数据)

    5.实例化一个响应对象,且将page_source返回的页面源码封装到该对象中

    6.返回该新的响应对象

'''
首先需要在中间件导入
from scrapy.html import HtmlResponse
DownloadMiddleware函数
    def process_response(self, request, response, spider):

        # Called with the response returned from the downloader.

        # Must either;

        # - return a Response object

        # - return a Request object

        # - or raise IgnoreRequest

        # 获取动态加载出来的数据

        print("即将返回一个新的响应对象")

        bw = spider.bw

        bw.get(url = request.url)

        import time

        # 防止数据加载过慢

        time.sleep(3)

        # 包含了动态加载的数据

        page_text = bw.page_source

        time.sleep(3)

        return HtmlResponse(url=spider.bw.current_url,body=page_text,
encoding="utf8",request=request)
spider.py
# -*- coding: utf-8 -*-

import scrapy

from selenium import webdriver

class ScrapySeleniumSpider(scrapy.Spider):

    name = 'scrapy_selenium'

    # allowed_domains = ['www.xxx.com']

    start_urls = ['http://war.163.com/']

    def __init__(self):

        self.bw = webdriver.Chrome(executable_path="F:\爬虫+数据\chromedriver.exe")

    def parse(self, response):

        div_list = response.xpath('//div[@class="data_row news_article clearfix "]')

        for div in div_list:

            title = div.xpath('.//div[@class="news_title"]/h3/a/text()').extract_first()

            print(title)

    def closed(self, spider):

        print('关闭浏览器对象!')

        self.bw.quit()
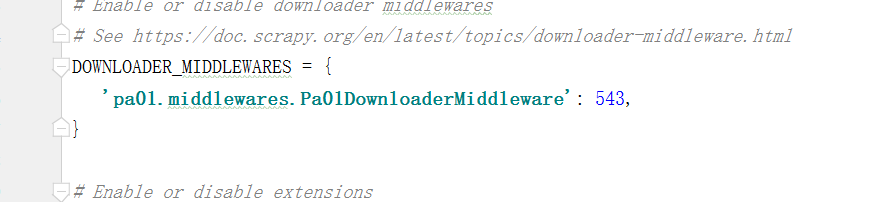
还需要注意的是使用中间件的同时需要在settings中解释一下Downloadmiddleware
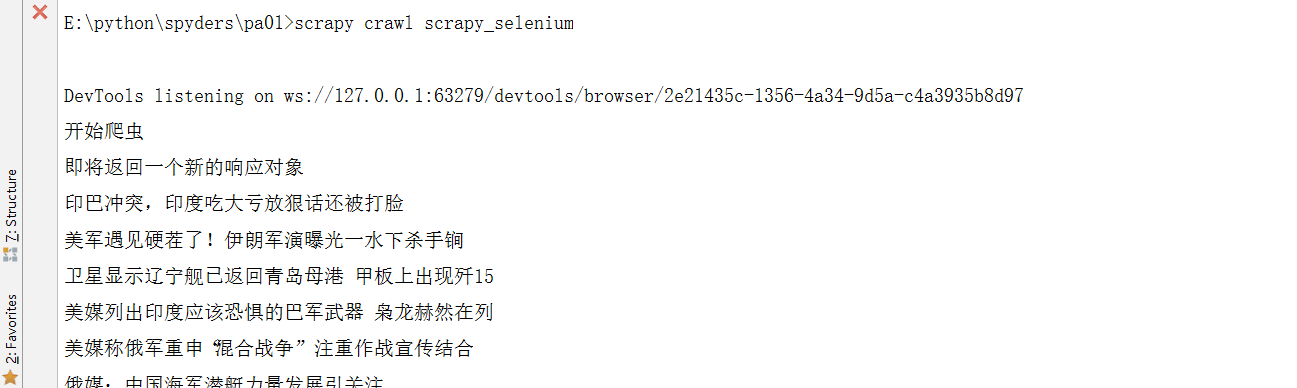
结果是这样就成功喽
爬虫之scrapy框架应用selenium的更多相关文章
- Python网络爬虫之Scrapy框架(CrawlSpider)
目录 Python网络爬虫之Scrapy框架(CrawlSpider) CrawlSpider使用 爬取糗事百科糗图板块的所有页码数据 Python网络爬虫之Scrapy框架(CrawlSpider) ...
- 爬虫06 /scrapy框架
爬虫06 /scrapy框架 目录 爬虫06 /scrapy框架 1. scrapy概述/安装 2. 基本使用 1. 创建工程 2. 数据分析 3. 持久化存储 3. 全栈数据的爬取 4. 五大核心组 ...
- Python逆向爬虫之scrapy框架,非常详细
爬虫系列目录 目录 Python逆向爬虫之scrapy框架,非常详细 一.爬虫入门 1.1 定义需求 1.2 需求分析 1.2.1 下载某个页面上所有的图片 1.2.2 分页 1.2.3 进行下载图片 ...
- 爬虫之scrapy框架
解析 Scrapy解释 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓 ...
- Python爬虫进阶(Scrapy框架爬虫)
准备工作: 配置环境问题什么的我昨天已经写了,那么今天直接安装三个库 首先第一步: ...
- 爬虫之Scrapy框架介绍
Scrapy介绍 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页内 ...
- 16.Python网络爬虫之Scrapy框架(CrawlSpider)
引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法 ...
- python爬虫随笔-scrapy框架(1)——scrapy框架的安装和结构介绍
scrapy框架简介 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
- 5、爬虫之scrapy框架
一 scrapy框架简介 1 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前Sc ...
随机推荐
- linux 结束某个进程,并且结束子进程
pid=49184 childid=`ps -ef|grep $pid|grep -v grep|awk '{printf " %s",$2 }'` kill -9 $childi ...
- ThinkPHP5中模型关联关系一对一,一对多
TP5 返回json反斜杠前面转义了class XinDai extends Controller{ public function index(){ $res = [ ['logo'=>'/i ...
- [ ceph ] 基本介绍及硬件配置
1. Ceph简介 所有的 Ceph 存储集群的部署都始于一个个 Ceph节点.网络和 Ceph存储集群.Ceph 存储集群至少需要一个 Ceph Monitor.一个 Manager和一个Ceph ...
- mysql 更新与查询(排序 分组 链接查询)
UPDATE更新 #每一次数据的更新都需要update UPDATE 命令修改 MySQL 数据表数据的通用 SQL 语法: UPDATE table_name SET field1=new-valu ...
- C# 拷贝文件夹到指定文件夹并更改文件夹名称
using System; using System.Collections.Generic; using System.Text; namespace ClientPrintServer.Tools ...
- my97整合fineui例子,开始和结束时间
<f: Toolbar runat ="server"> <Items> ...
- spring框架是怎么样通过properties来获得对象的?
首先我们要知道java获得对象的方式有四种: 1.通过new语句实例化一个对象. 2.通过反射机制创建对象. 3.通过clone()方法创建对象 3.通过反序列化的方式创建对象 在spring框架中, ...
- Symfony框架笔记
控制器获取前端传入的参数 $parameters = $request->request; $data = $parameters->all(); 引用静态资源(js.css.img) 使 ...
- C语言 小球撞击反弹
计算法(略) #include <stdio.h> #include <stdlib.h> int main() { int x, y, a, resu; scanf(&quo ...
- RabbitMq 概述
RabbitMQ是实现了高级消息队列协议(Advanced Message Queueing Protocol , AMQP)的开源消息代理软件(亦称面向消息的中间件). 1.AMQP协议 Rocke ...