
第三百五十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)介绍以及安装
第三百五十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)介绍以及安装
elasticsearch(搜索引擎)介绍
ElasticSearch是一个基于Lucene的搜索服务器。它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口。Elasticsearch是用Java开发的,并作为Apache许可条款下的开放源码发布,是第二最流行的企业搜索引擎。设计用于云计算中,能够达到实时搜索,稳定,可靠,快速,安装使用方便。
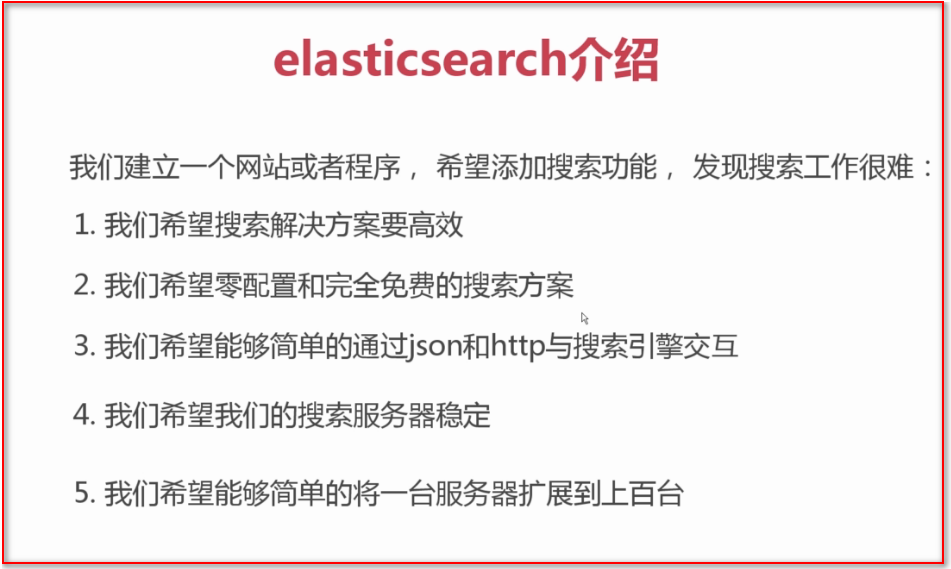
我们建立一个网站或应用程序,并要添加搜索功能,令我们受打击的是:搜索工作是很难的。我们希望我们的搜索解决方案要快,我们希望有一个零配置和一个完全免费的搜索模式,我们希望能够简单地使用JSON通过HTTP的索引数据,我们希望我们的搜索服务器始终可用,我们希望能够一台开始并扩展到数百,我们要实时搜索,我们要简单的多租户,我们希望建立一个云的解决方案。Elasticsearch旨在解决所有这些问题和更多的问题。
全文搜索引擎种类
1、elasticsearch
2、solr
3、sphinx
关系数据搜素缺点,也就是直接通过数据库搜索

elasticsearch(搜索引擎)都能弥补以上缺点
elasticsearch安装
1、elasticsearch是由Java开发的,所以首先要安装Java环境
注意:elasticsearch所需要的Java环境必须大于或者等于1.8版本
下载地址:http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html
我们下载Windows x64版本,jdk-8u144-windows-x64.exe文件,直接安装
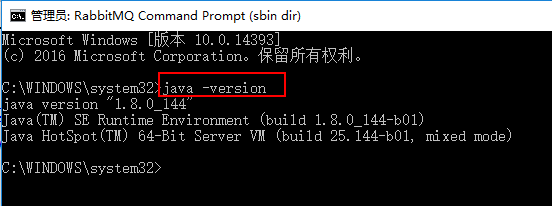
安装好后,我们cmd命令输入:java -version 查看java版本
2、elasticsearch-rtf安装
下载地址:https://github.com/medcl/elasticsearch-rtf 集成了我们很多插件
运行系统可用内存>2G
以下是集成安装的官方插件,个别插件需要配置才能使用,可根据需要删除 plugins 目录无关的插件,重启 elasticsearch 生效。
bin/elasticsearch-plugin install discovery-multicast

bin/elasticsearch-plugin install analysis-icu

bin/elasticsearch-plugin install analysis-kuromoji

bin/elasticsearch-plugin install analysis-phonetic

bin/elasticsearch-plugin install analysis-smartcn

bin/elasticsearch-plugin install analysis-stempel

bin/elasticsearch-plugin install analysis-ukrainian

bin/elasticsearch-plugin install discovery-file

bin/elasticsearch-plugin install ingest-attachment

bin/elasticsearch-plugin install ingest-geoip

bin/elasticsearch-plugin install ingest-user-agent

bin/elasticsearch-plugin install mapper-attachments

bin/elasticsearch-plugin install mapper-size

bin/elasticsearch-plugin install mapper-murmur3

bin/elasticsearch-plugin install lang-javascript

bin/elasticsearch-plugin install lang-python

bin/elasticsearch-plugin install repository-hdfs

bin/elasticsearch-plugin install repository-s3

bin/elasticsearch-plugin install repository-azure

bin/elasticsearch-plugin install repository-gcs

bin/elasticsearch-plugin install store-smb

bin/elasticsearch-plugin install discovery-ec2

bin/elasticsearch-plugin install discovery-azure-classic

bin/elasticsearch-plugin install discovery-gce
elasticsearch-rtf下载好解压后将文件夹复制到一个目录会得到以下文件

双击进入bin文件夹里,按shlft+鼠标右键,在此处打开命令窗口,输入 elasticsearch.bat 回车运行
然后在浏览器输入http://127.0.0.1:9200/ 返回数据说明成功

3、安装elasticsearch-rtf(搜索引擎)的可视化管理工具elasticsearch-head
注意:(搜索引擎)的可视化管理工具elasticsearch-head,的安装要用到node.js的npm 插件管理器
所以要先安装node.js的npm 插件管理器
下载地址:https://nodejs.org/en/download/
我们下载windows版本即可,下载后安装即可
安装后cdm命令:npm 如下显示表示安装成功

npm命令是node.js的npm 插件管理器,也就是下载插件安装插件的管理器,因为下载都是国外服务器很慢会掉线,我们需要使用淘宝的npm镜像cnpm
执行命令:npm install -g cnpm --registry=https://registry.npm.taobao.org 启用淘宝的npm镜像cnpm,注意:启用后当我们要输入npm命令时,就需要输入cnpm
(搜索引擎)的可视化管理工具elasticsearch-head的安装
下载地址:https://github.com/mobz/elasticsearch-head
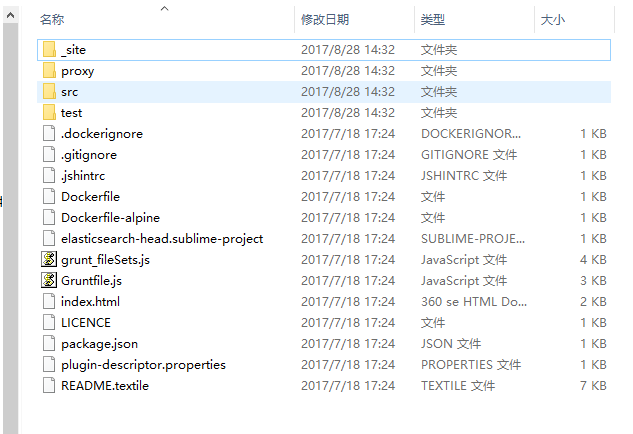
下载后解压到指定目录,会得到以下文件
cd进入到解压的elasticsearch-head目录
执行命令:cnpm install 安装elasticsearch-head的依赖包
在执行命令:cnpm run start 启动elasticsearch-head(搜索引擎)的可视化管理工具
访问后可以看到(搜索引擎)的可视化管理工具

我们看到显示未连接,我们需要配置elasticsearch-rtf(搜索引擎)连接,在elasticsearch-rtf/config/elasticsearch.yml 这个文件里配置
在文件的最后面写入
http.cors.enabled: true

http.cors.allow-origin: "*"

http.cors.allow-methods: OPTIONS, HEAD, GET, POST, PUT, DELETE
重启elasticsearch-rtf(搜索引擎)后就可以连接了

安装Kibana 5.1.2版本
注意:Kibana的版本要对应elasticsearch-head里信息里的版本
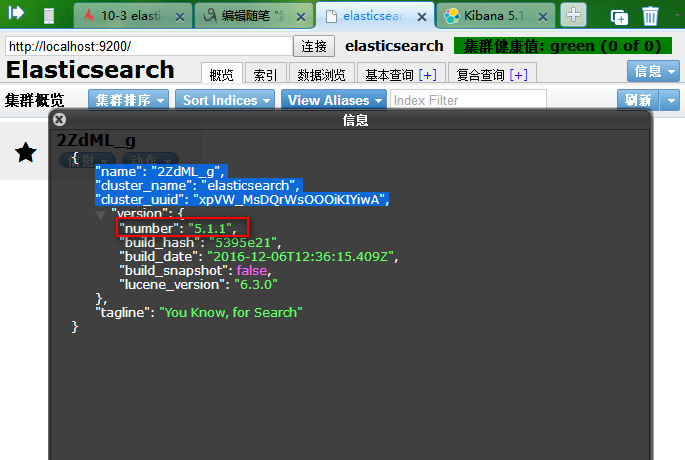
下载地址:https://www.elastic.co/downloads/past-releases/kibana-5-1-2
我们下载windows版即可
将下载文件解压到指定目录,进入kibana-5.1.2/bin文件夹
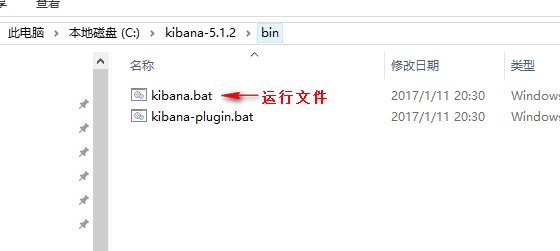
cd 进入kibana-5.1.2/bin文件夹
执行命令:kibana.bat 运行kibana-5.1.2

浏览器访问:http://localhost:5601 如下显示说明成功

第三百五十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)介绍以及安装的更多相关文章
- 第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中
第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中,判断URL是否重复 布隆过滤器(Bloom Filter)详 ...
- 第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启 scrapy的每一个爬虫,暂停时可以记录暂停状态以及爬取了哪些url,重启时可以从暂停状态开始爬取过的UR ...
- 第三百七十九节,Django+Xadmin打造上线标准的在线教育平台—xadmin的安装
第三百七十九节,Django+Xadmin打造上线标准的在线教育平台—xadmin的安装 xadmin介绍 xadmin是基于Django的admin开发的更完善的后台管理系统,页面基于Bootstr ...
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
- 第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作 注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想 ...
- 第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能
第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能 Django实现搜索功能 1.在Django配置搜索结果页的路由映 ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 第三百二十九节,web爬虫讲解2—urllib库爬虫—ip代理—用户代理和ip代理结合应用
第三百二十九节,web爬虫讲解2—urllib库爬虫—ip代理 使用IP代理 ProxyHandler()格式化IP,第一个参数,请求目标可能是http或者https,对应设置build_opener ...
- 第三百八十九节,Django+Xadmin打造上线标准的在线教育平台—列表筛选结合分页
第三百八十九节,Django+Xadmin打造上线标准的在线教育平台—列表筛选结合分页 根据用户的筛选条件来结合分页 实现原理就是,当用户点击一个筛选条件时,通过get请求方式传参将筛选的id或者值, ...
随机推荐
- 中秋节福利---HTML5-玉兔吃月饼游戏
中秋节快来了.送大家点福利: HTML5-玉兔吃月饼游戏 效果图: 代码下载:点击这里!!
- SVN文件加锁
原文:SVN与TortoiseSVN实战:文件加锁详解 加锁与解锁的操作对于项目中的二进制文件,如图片.声音.动态库等不可合并文件是非常有用的,可以让这些文件防止产生恼人的冲突,但TortoiseSV ...
- 【驱动】linux设备驱动·扫盲
linux设备驱动 Linux系统把设备驱动分成字符设备.块设备和网络设备三种类型. 内核为设备驱动提供了注册和管理的接口,设备驱动还可以使用内核提供的其他功能以及访问内核资源. PCI局部总线 早期 ...
- hive的UDF读取配置文件
hive的UDF读取配置文件 实现步骤 在读取配置文件的写为./file_name,然后在添加UDF的时候把配置文件也加入资源就好了: add jar xxx.jar; add file file_n ...
- AIX查看CPU、内存等信息
AIX下查看CPUAIX操作系统AIX的硬件信息可以通过prtconf命令看到.1. 查看逻辑CPU个数#pmcycles -mCPU 0 runs at 4204 MHzCPU 1 runs at ...
- logrotate 日志轮询(转存)
1.建立/etc/logrotate.d/nginx文件[1] vim /etc/logrotate.d/nginx 2.写入如下内容: /var/log/nginx/*log { daily rot ...
- python 6种数据类型几及用法
#!/usr/bin/python3 #python的基本语法和数据类型 #python3中 一行有多个语句,用分号分割(;) print("aaa") ;print(" ...
- The type name 'IComponentConnector' could not be found in the namespace 'System.Windows.Markup'
场景:Visual Studio写WPF项目时,想要生成XML文件,默认的WPF项目没有引入System.XML这个dll.在[解决方案资源管理器——引用]右键添加了System.XML引用后,运行项 ...
- 【Java/Spring】Spring的配置问题,IDEA报错“No mapping found for HTTP request with URI […] in DispatcherServlet”
从SVN上拷贝下JavaWeb项目,Spring框架的配置文件需要修改.部署好Tomcat后,启动服务,可以进入Web项目主页,但是访问其他URL时直接跳转到404,IDEA报错“No mapping ...
- 批量修改mysql数据库引擎
数据库表中部分是MyISAM引擎,部分是InnoDB.由于MyISAM不支持事务,所以需要全部修改为InnoDB引擎. (下面例子SQL语句中 ecsoft 为数据库名) 通过以下查询可以看到数据库中 ...