
scrapy框架解读--深入理解爬虫原理
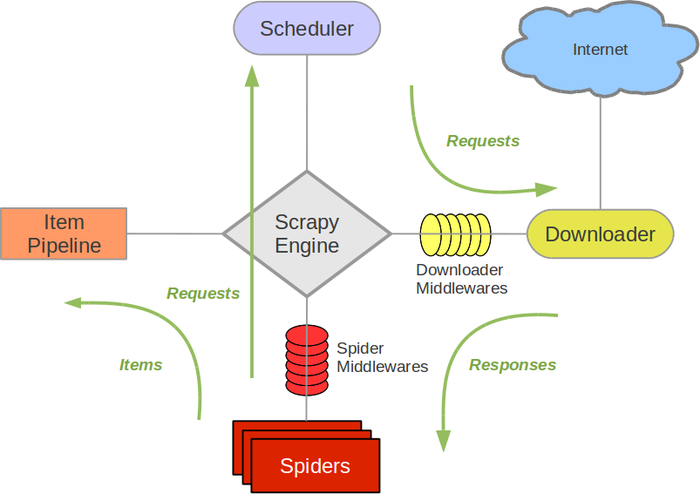
scrapy框架结构图:
组成部分介绍:
Scrapy Engine:
负责组件之间数据的流转,当某个动作发生时触发事件Scheduler:
接收requests,并把他们入队,以便后续的调度Downloader:
负责抓取网页,并传送给引擎,之后抓取结果将传给spiderSpiders:
用户编写的可定制化的部分,负责解析response,产生items和URLItem Pipeline:
负责处理item,典型的用途:清洗、验证、持久化Downloader middlewares:
位于引擎和下载器之间的一个钩子,处理传送到下载器的requests和传送到引擎的response(若需要在Requests到达Downloader之前或者是responses到达spiders之前做一些预处理,可以使用该中间件来完成)Spider middlewares:
位于引擎和抓取器之间的一个钩子,处理抓取器的输入和输出
(在spiders产生的Items到达Item Pipeline之前做一些预处理或response到达spider之前做一些处理)
Scrapy中的数据流:
- Scrapy中的数据流由执行引擎控制,其过程如下:
- 引擎打开一个网站(open a domain),找到处理该网站的spider,并向该spider请求第一个要爬取的url(s);
- 引擎从spider中获取到第一个要爬取的url并在调度器(scheduler)以requests调度;
- 引擎向调度器请求下一个要爬取的url;
- 调度器返回下一个要爬取的url给引擎,引擎将url通过下载器中间件(请求requests方向)转发给下载器(Downloader);
- 一旦页面下载完毕,下载器生成一个该页面的responses,并将其通过下载器中间件(返回responses方向)发送给引擎;
- 引擎从下载器中接收到responses并通过spider中间件(输入方向)发送给spider处理;
- spider处理responses并返回爬取到的Item及(跟进的)新的resquests给引擎
- 引擎将(spider返回的)爬取到的Item给Item Pipeline,将(spider返回的)requests给调度器;
- (从第二部)重复直到(调度器中没有更多的request)引擎关闭该网站
中间件的编写:
down loader middle ware – 查看文档151页
spider middle wares – 查看文档162页
scrapy框架解读--深入理解爬虫原理的更多相关文章
- 基于Scrapy框架的Python新闻爬虫
概述 该项目是基于Scrapy框架的Python新闻爬虫,能够爬取网易,搜狐,凤凰和澎湃网站上的新闻,将标题,内容,评论,时间等内容整理并保存到本地 详细 代码下载:http://www.demoda ...
- 使用scrapy框架做赶集网爬虫
使用scrapy框架做赶集网爬虫 一.安装 首先scrapy的安装之前需要安装这个模块:wheel.lxml.Twisted.pywin32,最后在安装scrapy pip install wheel ...
- Scrapy框架实战-妹子图爬虫
Scrapy这个成熟的爬虫框架,用起来之后发现并没有想象中的那么难.即便是在一些小型的项目上,用scrapy甚至比用requests.urllib.urllib2更方便,简单,效率也更高.废话不多说, ...
- Scrapy框架解读
1. Scrapy组件a. 主体部分i. 引擎(Scrapy):处理整个系统的数据流处理,触发事务(框架核心)ii. 调度器(Scheduler):1) 用来接受引擎发过来的请求, 压入队列中, 并在 ...
- 基于Scrapy框架的增量式爬虫
概述 概念:监测 核心技术:去重 基于 redis 的一个去重 适合使用增量式的网站: 基于深度爬取的 对爬取过的页面url进行一个记录(记录表) 基于非深度爬取的 记录表:爬取过的数据对应的数据指纹 ...
- 网络爬虫第五章之Scrapy框架
第一节:Scrapy框架架构 Scrapy框架介绍 写一个爬虫,需要做很多的事情.比如:发送网络请求.数据解析.数据存储.反反爬虫机制(更换ip代理.设置请求头等).异步请求等.这些工作如果每次都要自 ...
- Scrapy框架学习笔记
1.Scrapy简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网 ...
- python高级之scrapy框架
目录: 爬虫性能原理 scrapy框架解析 一.爬虫性能原理 在编写爬虫时,性能的消耗主要在IO请求中,当单进程单线程模式下请求URL时必然会引起等待,从而使得请求整体变慢. 1.同步执行 impor ...
- 都是干货---真正的了解scrapy框架
去重规则 在爬虫应用中,我们可以在request对象中设置参数dont_filter = True 来阻止去重.而scrapy框架中是默认去重的,那内部是如何去重的. from scrapy.dupe ...
随机推荐
- 2015-04-14——css3 @media
//判断横竖屏 @media screen and (min-aspect-ratio: 13/13) { body {background-color:red;}} //屏幕宽高比,必须是除数形式 ...
- xshell上传下载文件
上传文件到服务器rz 从服务器下载文件sz
- Vue中动态添加多个class
vue中可以通过 :class=""这样来根据一定的条件来动态添加class,但是有时候需要判断的条件比较多,需要动态添加的class也比较多,这个时候其实也很简单 先看一下示例: ...
- jQuery实现图片预览
摘自:http://www.cnblogs.com/leejersey/p/3660202.html JS代码: /* *名称:图片上传本地预览插件 v1.1 *作者:周祥 *时间:2013年11月2 ...
- rest_framework之url控制器详解
一 自定义路由(原始方式) from django.conf.urls import url from app01 import views urlpatterns = [ url(r'^books/ ...
- MySQL数据库(2)- 库的操作、表的操作、数据的操作、存储引擎的介绍
一.库的操作 1.系统数据库 执行如下命令,查看系统数据库: mysql> show databases; 参数解释: information_schema: 虚拟库,不占用磁盘空间,存储的是数 ...
- shell脚本调用传参【转载】
转自:https://www.cnblogs.com/cisum/p/8010658.html 1.直接使用$0,$1,$2,$3 $0是脚本的名字,就是按顺序来 #!/bin/bash # auth ...
- Spark 1.5新特性介绍
一.DataFrame执行后端优化(Tungsten第一阶段) DataFrame可以说是整个Spark项目最核心的部分,在1.5这个开发周期内最大的变化就是Tungsten项目的第一阶段已经完成.主 ...
- Java NIO2 File API介绍
Introduction to the Java NIO2 File API GitHub NIO2中的文件API是Java 7附带的Java平台的主要新功能之一,特别是新的文件系统API的一个子集以 ...
- 2016年国内开源maven镜像站点汇总
本文系转载,原文链接:https://www.cnblogs.com/xunianchong/p/5684042.html 一.站点版 (一).企业站 1.网易:http://mirrors.163. ...