
lightgbm原理以及Python代码
原论文:
http://papers.nips.cc/paper/6907-lightgbm-a-highly-efficient-gradient-boosting-decision-tree.pdf
lightgbm原理:
gbdt困点:
gbdt是受欢迎的机器学习算法,当特征维度很高或数据量很大时,有效性和可拓展性没法满足。lightgbm提出GOSS(Gradient-based One-Side Sampling)和EFB(Exclusive Feature Bundling)进行改进。lightgbm与传统的gbdt在达到相同的精确度时,快20倍。
Gradient-based One-Side Sampling (Goss):在GBDT中,数据集没有权重,注意到让不同梯度的数据集在计算信息增益时产生不同的作用。根据信息增益的定义,对于有更大梯度(即训练不足的数据集)将产生更多信息增益。于是,当降低数据集的数据量时,通过保持大梯度的数据集,随机丢掉小梯度的数据集,保持信息增益的准确性。
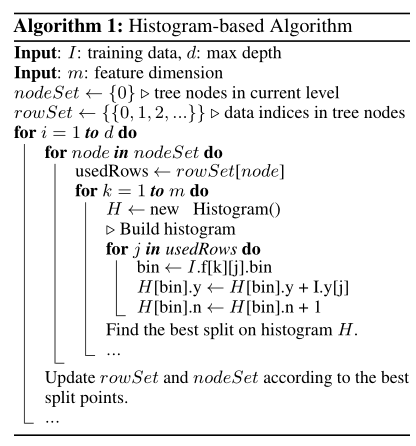
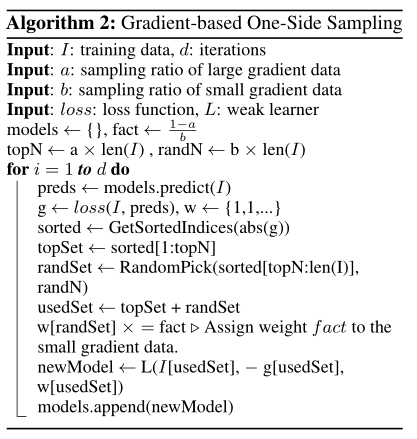
GOSS保持所有具有大梯度的数据集,在小梯度数据集上随机采样。为了抵消对数据分布的影响,GOSS小梯度的样本数据在计算信息增益时引入系数(1-a)/b。具体来说,
- GOSS首先按照数据集的梯度绝对值进行排序,选取最大的a*100%数据集保留;
- 然后从剩余数据集中随机选取b*100%;
- 最后,GOSS对于小梯度乘以常数(1-a)/b放大了样本数据。这样做,我们能不改变原始数据的分布,集中注意力在训练不足的数据上。
收敛分析表明,GOSS算法不会太多降低训练复杂度,并且超越随机选样本。
Exclusive Feature Bundling(EFB). 高维数据通常非常稀疏。特征空间的稀疏性为我们提供了一个设计一种几乎无损的方法来减少特征数量的可能性。具体地说,在一个稀疏的特征空间,许多特征是互斥的,即,它们从不同时取非零值。我们可以安全地将互斥特征捆绑到一个单一的特征中(称之为互斥特征束)。通过精心设计的特征扫描算法,我们可以构建与个体特征类似的基于特征束的特征直方图。这样,直方图构建的复杂性从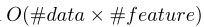 到
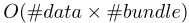 ,其中
 。这样我们可以在不影响准确性情况下大大加快对GBDT的训练。
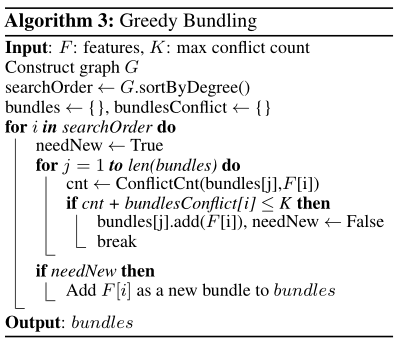
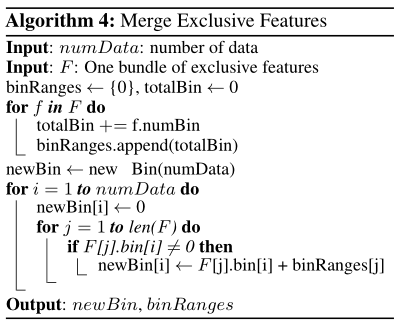
我们的问题对应于图着色问题,反之亦然,因此可以使用贪婪算法来解决。
EFB算法可以将许多互斥性特征捆绑到更少的密集特征上,这可以有效避免了零特征值的不必要计算。事实上,我们也可以通过忽略零特征值,使用表格记录特征非零值的直方图算法。通过扫描表中的数据,直方图构建成本将从 变为
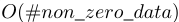 。然而,该方法在树生长过程中需要额外的内存和计算成本来维护这些特征表。我们可以以LightGBM为基本函数按此进行优化。注:这种优化不与EFB冲突,因为我们在捆束稀疏时,依然可以使用它。
EFB合并了许多稀疏特征(包括编码特性和隐式互斥性特征),成为少得多的特征。在捆绑过程中包含了基本稀疏特征优化。然而,EFB在树学习过程中为每个特征维护非零数据表,没有额外的成本。更重要的是,因为许多先前孤立的特征被捆绑在一起,它可以增加空间局部性和显著改进缓存命中率。因此,整体效率的提高是引人注目的。以上分析表明,EFB是一种非常有效的在直方图中利用稀疏属性的算法,可以为GBDT训练过程带来显著的加速。
python代码:
import lightgbm
clf=lightgbm
train_matrix = clf.Dataset(tr_x, label=tr_y)
test_matrix = clf.Dataset(te_x, label=te_y)
#z = clf.Dataset(test_x, label=te_y)
#z=test_x
params = {
# 'boosting_type': 'gbdt',
# 'learning_rate': 0.01,
# 'objective': 'binary',
# 'metric': 'auc',
# 'min_child_weight': 1.5,
# 'num_leaves': 2 ** 5,
# 'lambda_l2': 10,
# 'subsample': 0.9,
# 'colsample_bytree': 0.7,
# 'colsample_bylevel': 0.7,
# 'learning_rate': 0.01,
# 'seed': 2017,
# 'nthread': 12,
# 'silent': True,
'task': 'train',
'learning_rate': 0.005,
# 'max_depth': 8,
# 'num_leaves':2**6-1,
'boosting_type': 'gbdt',
'objective': 'binary',
# 'is_unbalance':True,
'feature_fraction': 0.8,
'metric':'auc',
'bagging_fraction': 0.86,
# 'lambda_l1': 0.0001,
'lambda_l2': 49,
'bagging_freq':3,
# 'min_data_in_leaf':5,
'verbose': 1,
'random_state': 2267,
}
num_round = 10000
early_stopping_rounds = 300
if test_matrix:
model = clf.train(params, train_matrix,num_round,valid_sets=test_matrix,
early_stopping_rounds=early_stopping_rounds,verbose_eval=300
)
pre= model.predict(te_x,num_iteration=model.best_iteration).reshape((te_x.shape[0],1))
train[test_index]=pre
test_pre[i, :]= model.predict(test_x, num_iteration=model.best_iteration).reshape((test_x.shape[0],1))
cv_scores.append(roc_auc_score(te_y, pre))
lightgbm原理以及Python代码的更多相关文章
- catboost原理以及Python代码
原论文: http://learningsys.org/nips17/assets/papers/paper_11.pdf catboost原理: One-hot编码可以在预处理阶段或在训练期间 ...
- MD5( 信息摘要算法)的概念原理及python代码的实现
简述: message-digest algorithm 5(信息-摘要算法).经常说的“MD5加密”,就是它→信息-摘要算法. md5,其实就是一种算法.可以将一个字符串,或文件,或压缩包,执行md ...
- KNN算法原理(python代码实现)
kNN(k-nearest neighbor algorithm)算法的核心思想是如果一个样本在特征空间中的k个最相邻的样本中的大多数属于某一个类别,则该样本也属于这个类别,并具有这个类别上样本的特性 ...
- 【集成学习】:Stacking原理以及Python代码实现
Stacking集成学习在各类机器学习竞赛当中得到了广泛的应用,尤其是在结构化的机器学习竞赛当中表现非常好.今天我们就来介绍下stacking这个在机器学习模型融合当中的大杀器的原理.并在博文的后面附 ...
- 逻辑回归原理(python代码实现)
Logistic Regression Classifier逻辑回归主要思想就是用最大似然概率方法构建出方程,为最大化方程,利用牛顿梯度上升求解方程参数. 优点:计算代价不高,易于理解和实现. 缺点: ...
- 【机器学习】:Kmeans均值聚类算法原理(附带Python代码实现)
这个算法中文名为k均值聚类算法,首先我们在二维的特殊条件下讨论其实现的过程,方便大家理解. 第一步.随机生成质心 由于这是一个无监督学习的算法,因此我们首先在一个二维的坐标轴下随机给定一堆点,并随即给 ...
- paip.输入法编程--英文ati化By音标原理与中文atiEn处理流程 python 代码为例
paip.输入法编程--英文ati化By音标原理与中文atiEn处理流程 python 代码为例 #---目标 1. en vs enPHati 2.en vs enPhAtiSmp 3.cn vs ...
- 决策树ID3原理及R语言python代码实现(西瓜书)
决策树ID3原理及R语言python代码实现(西瓜书) 摘要: 决策树是机器学习中一种非常常见的分类与回归方法,可以认为是if-else结构的规则.分类决策树是由节点和有向边组成的树形结构,节点表示特 ...
- 模拟退火算法SA原理及python、java、php、c++语言代码实现TSP旅行商问题,智能优化算法,随机寻优算法,全局最短路径
模拟退火算法SA原理及python.java.php.c++语言代码实现TSP旅行商问题,智能优化算法,随机寻优算法,全局最短路径 模拟退火算法(Simulated Annealing,SA)最早的思 ...
随机推荐
- 多Tomcat多JDK版本的Window服务添加配置方式
本文所讲的配置方式只适合Windows系统,所牵扯的软件2个解压的jdk,2个解压的tomcat. 1.环境初始化 将两个jdk和tomcat解压到我们指定的目录下.修改两个tomcat的端口:必须修 ...
- hadoop集群部署配置补充
/etc/hosts192.168.153.147 Hadoop-host192.168.153.146 Hadoopnode1 192.168.153.145 Hadoopnode2::1 loca ...
- day59
轮播图作业 <!DOCTYPE html> <html lang="zh"> <head> <meta charset="UTF ...
- jqgrid 自定义添加行数据
一般在设置了自定义按钮后,比如‘添加’按钮,点击添加需要添加一条数据在表格中. 通过jqgrid的方法 addRowData 插入一行数据. //添加一行数据 function addRow() { ...
- 20155237 《JAVA程序设计》实验二(JAVA面向对象程序设计)实验报告
20155237 <JAVA程序设计>实验二(JAVA面向对象程序设计)实验报告 实验内容 初步掌握单元测试和TDD 理解并掌握面向对象三要素:封装.继承.多态 初步掌握UML建模 熟悉S ...
- 20155316 Exp1 PC平台逆向破解(5)M
前绪 实验收获与感想 初步从三个途径了解了什么是缓冲区溢出以及如何简单实现它,对汇编与反汇编有更直观的了解. 什么是漏洞?漏洞有什么危害? 漏洞是指机器体制设计时所没有顾及到的.可以被利用的bug,放 ...
- 20155321 《网络攻防》 Exp8 Web基础
20155321 <网络攻防> Exp8 Web基础 基础问题回答 什么是表单? 表单是主要负责数据采集功能.主要是以下三个部分构成: 表单标签:包含处理表单数据所用的程序的URL以及数据 ...
- 汇编 循环位移指令 ROL, 循环位移指令 ROR
知识点: 循环位移指令 ROL 循环位移指令 ROR 一.循环位移指令 ROL ROR int i=0x77886611;//01110111100010000110011000010001 ...
- [图片生成]使用VAEs生成新图片
变分自动编码器生成图片 从隐图像空间进行采样以创建全新的图像或编辑现有图像是目前创作AI最受欢迎和最成功的应用方式. 图像隐空间取样 图像生成的关键思想是开发表示的低维潜在空间(自然是矢量空间),其中 ...
- Linux 平台和 Windows平台下 Unicode与UTF-8互转
Windows: unsigned char * make_utf8_string(const wchar_t *unicode) { , index = , out_index = ; unsign ...