
Scrapy框架--代理和cookie
如何发起post请求?
代理和cookie:

cookie:豆瓣网个人登录,获取该用户个人主页这个二级页面的页面数据。

如何发起post请求?

    一定要对start_requests方法进行重写。

1.    Request()方法中给method属性赋值成post

2.    FormRequest()进行post请求的发送
简单测试:
在爬虫文件中
import scrapy

class PostdemoSpider(scrapy.Spider):

    name = 'postDemo'

    #allowed_domains = ['www.baidu.com']

    start_urls = ['https://fanyi.baidu.com/sug']

    def start_requests(self):

        print('start_request')

        data ={'kw':'dog'}

        for url in self.start_urls:

            yield scrapy.FormRequest(url=url,formdata=data,callback=self.parse)

    def parse(self, response):

        print(response.text)
在settings配置
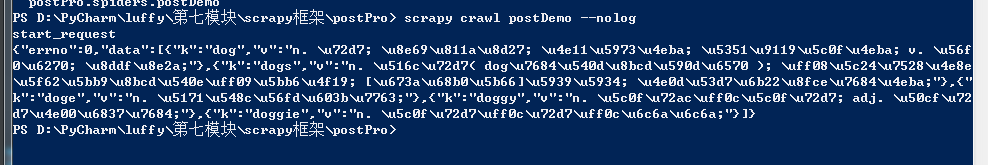
然后执行:
cookie:豆瓣网个人登录,获取该用户个人主页这个二级页面的页面数据。
先创建一个工程doubanPro

cd 到创建的目录下

----------
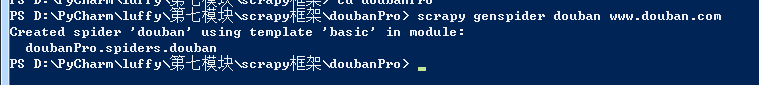
创建爬虫文件
1. 在命令行下 cd 进入工程所在文件夹
2.scrapy genspider 爬虫文件的名称 起始url
爬虫文件 douban.py
import scrapy

class DoubanSpider(scrapy.Spider):

    name = 'douban'

    # allowed_domains = ['www.douban.com']

    start_urls = ['https://accounts.douban.com/login']

    # 重写start_requests方法

    def start_requests(self):

        for url in self.start_urls:

            # 排除验证码的情况 将请求参数封装到字典

            data = {

                'source': 'movie',

                'redir': 'https://movie.douban.com /',

                'form_email': '836342406@qq.com',

                'form_password': 'douban836342406,.',

                'login': '登录'

            }

            yield scrapy.FormRequest(url=url,formdata=data,callback=self.parse)

    # 针对个人主页数据进行解析操作

    def parseBySecondPage(self,response):

        fp = open('second.html','w',encoding='utf-8')

        fp.write(response.text)

    def parse(self, response):

        # 登录成功后的页面进行存储

        fp = open('main.html','w',encoding='utf-8')

        fp.write(response.text)

        # 获取当前用户的个人主页

        url = 'https://www.douban.com/people/188197188/'

        yield scrapy.Request(url=url,callback=self.parseBySecondPage)
执行

代理操作-代理ip的更换
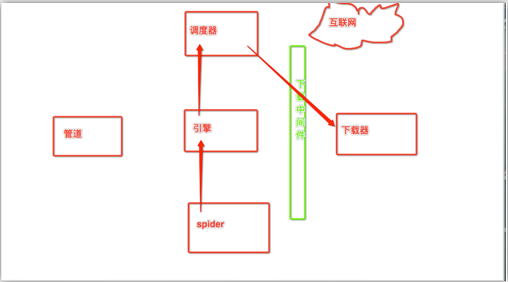
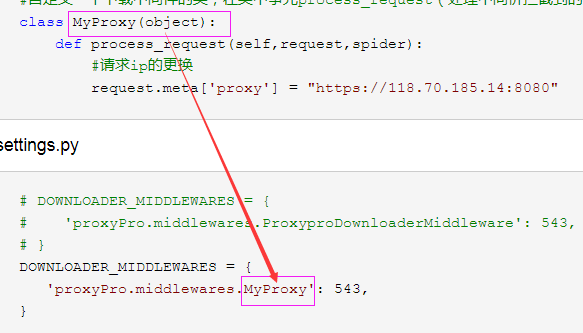
下载中间件作用:拦截请求,可以将请求的ip进行更换。

流程:

1.    下载中间件类的自制定

a)    object

b)    重写process_request(self,request,spider)的方法

2.    配置文件中进行下载中间价的开启
新建一个proxyPro的工程
建立proxyDemo.py爬虫文件
1、下载中间件类的自定义
proxyDemo.py
import scrapy

class ProxydemoSpider(scrapy.Spider):

    name = 'proxyDemo'

    #allowed_domains = ['www.baidu.com']

    start_urls = ['https://www.baidu.com/s?wd=ip']

    def parse(self, response):

        fp = open('proxy.html','w',encoding='utf-8')

        fp.write(response.text)
middlewares.py
from scrapy import signals

#自定义一个下载中间件的类,在类中事先process_request(处理中间价拦截到的请求)方法

class MyProxy(object):

    def process_request(self,request,spider):

        #请求ip的更换

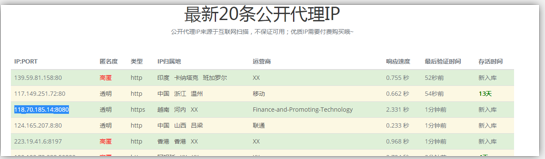
        request.meta['proxy'] = "https://118.70.185.14:8080"

代理ip------------>"https://118.70.185.14:8080"
settings.py
# DOWNLOADER_MIDDLEWARES = {

#    'proxyPro.middlewares.ProxyproDownloaderMiddleware': 543,

# }

DOWNLOADER_MIDDLEWARES = {

   'proxyPro.middlewares.MyProxy': 543,

}
Scrapy框架--代理和cookie的更多相关文章
- 爬虫--requests模块高级(代理和cookie操作)
代理和cookie操作 一.基于requests模块的cookie操作 引言:有些时候,我们在使用爬虫程序去爬取一些用户相关信息的数据(爬取张三“人人网”个人主页数据)时,如果使用之前requests ...
- Scrapy框架之代理和cookie
Cookie 是在 HTTP 协议下,服务器或脚本可以维护客户工作站上信息的一种方式.Cookie 是由 Web 服务器保存在用户浏览器(客户端)上的小文本文件,它可以包含有关用户的信息.无论何时用户 ...
- scrapy 伪装代理和fake_userAgent的使用
伪装浏览器代理 在爬取网页是有些服务器对请求过滤的不是很高可以不用ip来伪装请求直接将自己的浏览器信息给伪装也是可以的. 第一中方法: 1.在setting.py文件中加入以下内容,这是一些浏览器的头 ...
- 爬虫之代理和cookie的处理
代理操作 代理的目的 为解决ip被封的情况 什么是代理 代理服务器:fiddler 为什么使用代理可以改变请求的ip 本机的请求会先发送给代理服务器,代理服务器会接受本机发送过来的请求(当前请求对应的 ...
- Jmeter的代理和cookie/session/Token令牌认证
Jmeter的代理服务器 1.启动Jmeter: 2.“测试计划”中添加“线程组”: 3.“工作台”中添加“HTTP代理服务器”: 4.配置代理服务器:Global Settings下面的端口配置:9 ...
- 爬虫--Scrapy框架课程介绍
Scrapy框架课程介绍: 框架的简介和基础使用 持久化存储 代理和cookie 日志等级和请求传参 CrawlSpider 基于redis的分布式爬虫 一scrapy框架的简介和基础使用 a) ...
- 第三百三十三节,web爬虫讲解2—Scrapy框架爬虫—Scrapy模拟浏览器登录—获取Scrapy框架Cookies
第三百三十三节,web爬虫讲解2—Scrapy框架爬虫—Scrapy模拟浏览器登录 模拟浏览器登录 start_requests()方法,可以返回一个请求给爬虫的起始网站,这个返回的请求相当于star ...
- 十二 web爬虫讲解2—Scrapy框架爬虫—Scrapy模拟浏览器登录—获取Scrapy框架Cookies
模拟浏览器登录 start_requests()方法,可以返回一个请求给爬虫的起始网站,这个返回的请求相当于start_urls,start_requests()返回的请求会替代start_urls里 ...
- scrapy框架使用笔记
目前网上有很多关于scrapy的文章,这里我主要介绍一下我在开发中遇到问题及一些技巧: 1,以登录状态去爬取(带cookie) -安装内容: brew install phantomjs (MAC上) ...
随机推荐
- springboot(整合事务和分布式事务)
springboot +mybatis 单数据源,事务 事务:简单理解指的是一组操作,里面包含许多个单一的逻辑,只要有一个逻辑没有执行成功 ,那么都算失败.所有的数据都回归到最初的状态(回滚) 代码实 ...
- Java学习——使用final修饰符
package Pack1; import java.awt.*; import java.applet.*; class ca { static int n = 20; final int nn; ...
- Java-Runoob-高级教程-实例-方法:06. Java 实例 – 方法覆盖
ylbtech-Java-Runoob-高级教程-实例-方法:06. Java 实例 – 方法覆盖 1.返回顶部 1. Java 实例 - 方法覆盖 Java 实例 前面章节中我们已经学习了 Jav ...
- 网站首页多URL可访问,如何集中首页网站权重?
原文地址:http://ask.seowhy.com/question/8573 百度站长平台Lee在文章<建立符合搜索引擎抓取习惯>一文中提出:唯一性网站中同一内容页只与唯一一个url相 ...
- hashMap为啥初始化容量为2的次幂
原文 https://blog.csdn.net/sd_csdn_scy/article/details/57083619hashMap源码获取元素的位置: static int indexFor(i ...
- centos6.9安装oracle11g
感谢强哥的文档 源文档链接 https://www.qstack.com.cn/archives/68.html #------------------------------------------ ...
- datetime模块常用功能小结
- [UE4]正交
一.如果两条直线是垂直的,那么就可以说这2条直线是正交的.既然有垂直,为什么还要有正交概念呢? 因为正交可以描述两个或者多个变量之间互不影响.互不干涉,而垂直是完全属于几何的术语. 二.具有正交关系的 ...
- [UE4]使用DataTable
- npm rebuild node-sass
在使用npm安装node-sass的时候,可能会出现如下的报错: Error: ENOENT: no such file or directory, scandir 'D:\IdeaWork\code ...