
爬虫再探之mysql简单使用
在爬取数据量比较大时,用EXCEL存取就不太方便了,这里简单介绍一下python操作mysql数据库的一些操作。本人也是借助别人的博客学习的这些,但是找不到原来博客链接了,就把自己的笔记写在这里,这里感谢博文原创者。
import MySQLdb

# 打开数据库连接

mypwd = input("请输入数据库密码:")
# 这里只是避免代码中直接出现自己的密码
# 下面中 “db” 是指定要使用的数据库,“charset” 是指定编码

db = MySQLdb.Connect(host="localhost", user="root", passwd=mypwd, db="test", use_unicode=True, charset="utf8")

# 获取操作游标

cursor = db.cursor()

# 使用execute方法执行SQL语句

cursor.execute("SELECT VERSION()")

# 使用fetchone 方法获取一条数据库

data = cursor.fetchone()

print("Database's version is %s"%data)
#关闭数据库连接
db.close()
输出结果如下图。

上面算是一个基本流程吧。下面介绍一些具体的用法。
关于数据表的创建:
import MySQLdb

#打开数据库链接

mypwd = input("请输入数据库密码:")

db = MySQLdb.Connect(host="localhost",user="root",passwd=mypwd,db="blog_test",use_unicode=True, charset="utf8")

cursor = db.cursor()

#如果数据已经存在,使用excute()方法删除表

cursor.execute("DROP TABLE IF EXISTS employee")

#创建数据表SQL语句,这里和mysql数据库的语法是一样的。

sql = """CREATE TABLE employee(

		first_name CHAR(20) NOT NULL,

		last_name CHAR(20),

		age INT,

		sex CHAR(1),

		income FLOAT )"""

cursor.execute(sql)

#关闭数据库连接

db.close()
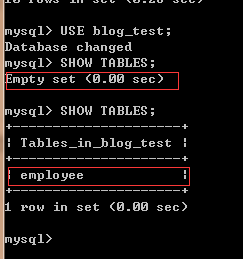
可以看到blog_test数据库中已经创建了表employee.
关于数据的插入
import MySQLdb

mypwd = input("请输入数据库密码:")

db = MySQLdb.Connect(host="localhost", user="root", passwd=mypwd,db="blog_test",use_unicode=True,charset="utf8")

cursor = db.cursor()

sql = """INSERT INTO employee(first_name,last_name,age,sex,income)\

		VALUES('Mac','Mohan',20,"M",2000)"""

try:

	cursor.execute(sql)

	#提交到数据库执行,这里切记要commit提交事务,否则无法完成保存。

	db.commit()

except:

	#Rollback in case there is any error

	db.rollback()

db.close()
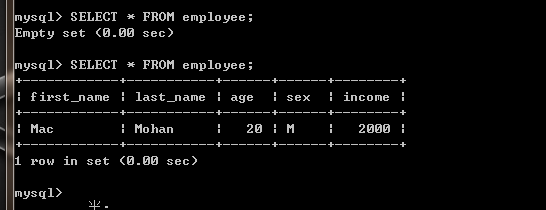
数据库输出如下。
关于数据库的查询
import MySQLdb

mypwd = input("请输入数据库密码:")

db = MySQLdb.Connect(host="localhost", user="root", passwd=mypwd, db="blog_test", use_unicode=True, charset="utf8")

cursor = db.cursor()

sql = "SELECT * FROM employee"

try:

    cursor.execute(sql)

    results = cursor.fetchall()

    print(results)

    for row in results:

        fname = row[0]

        lname = row[1]

        age = row[2]

        sex = row[3]

        income = row[4]

        print("fname=%s,lname=%s,age=%d,sex=%s,income=%d"\

            %(fname,lname,age, sex,income))

except:

    print("Error, unable to fetch data")

db.close()
代码输出结果。

至此python操作数据库的一些基本操作算是说完了。。。
爬虫再探之mysql简单使用的更多相关文章
- 爬虫再探实战(三)———爬取动态加载页面——selenium
自学python爬虫也快半年了,在目前看来,我面临着三个待解决的爬虫技术方面的问题:动态加载,多线程并发抓取,模拟登陆.目前正在不断学习相关知识.下面简单写一下用selenium处理动态加载页面相关的 ...
- 爬虫再探实战(五)———爬取APP数据——超级课程表【四】——情感分析
仔细看的话,会发现之前的词频分析并没有什么卵用...文本分析真正的大哥是NLP,不过,这个坑太大,小白不大敢跳...不过还是忍不住在坑边上往下瞅瞅2333. 言归正传,今天刚了解到boson公司有py ...
- python3爬虫再探之豆瓣影评数据抓取
一个关于豆瓣影评的爬虫,涉及:模拟登陆,翻页抓取.直接上代码: import re import time import requests import xlsxwriter from bs4 imp ...
- 爬虫再探实战(四)———爬取动态加载页面——请求json
还是上次的那个网站,就是它.现在尝试用另一种办法——直接请求json文件,来获取要抓取的信息. 第一步,检查元素,看图如下: 过滤出JS文件,并找出包含要抓取信息的js文件,之后就是构造request ...
- python3爬虫再探之EXCEL
在爬取数据之后,数据的保存就成为一个新的问题,一般不太大的的数据存储到EXCEL就可以了.这里介绍一个python的第三方库——xlsxwriter. 这个库的安装就不介绍了,pip就可以,不用FQ. ...
- python3爬虫再探之EXCEL(续)
上篇介绍了xlsxwriter的用法,本来想写一下xlrd和xlwt的用法,看到这篇文章——http://blog.csdn.net/wangkai_123456/article/details/50 ...
- Node.js 网页爬虫再进阶,cheerio助力
任务还是读取博文标题. 读取app2.js // 内置http模块,提供了http服务器和客户端功能 var http=require("http"); // cheerio模块, ...
- 【再探backbone 02】集合-Collection
前言 昨天我们一起学习了backbone的model,我个人对backbone的熟悉程度提高了,但是也发现一个严重的问题!!! 我平时压根没有用到model这块的东西,事实上我只用到了view,所以昨 ...
- 再探jQuery
再探jQuery 前言:在使用jQuery的时候发现一些知识点记得并不牢固,因此希望通过总结知识点加深对jQuery的应用,也希望和各位博友共同分享. jQuery是一个JavaScript库,它极大 ...
随机推荐
- MySQL学习笔记_1_MySQL数据库管理系统概述
1. MySQL架构 C/S: client / server架构 MySQL DBMS(Data Bank Management System): 数据库管理系统 客户端 <---> 服 ...
- (31)odoo中的时间
* 在model中 from datetime import datetime, timedelta import time from openerp.tools impor ...
- 补交git、ssh
本来应该早就应该交的,自己给忘记了,非常抱歉,现在补交上来 词频统计: 代码地址:https://coding.net/u/liuff/p/cipin/git ssh:git@git.coding.n ...
- 初学java之StringBuffer类的常用方法
import java.text.*; public class Gxjun { public static void main(String atgs[]) { StringBuffer str= ...
- 手动实现KVO
前言 KVO(Key-Value Observing, 键值观察), KVO的实现也依赖于runtime. 当你对一个对象进行观察时, 系统会动态创建一个类继承自原类, 然后重写被观察属性的sette ...
- IntelliJ IDEA 12 与 Tomcat 集成并运行Web项目
配置Tomcat Server 1.Ctrl+Alt+s或者File——>Setting...;选中“Application Servers”点击"+" 创建运行配置 上面的 ...
- hadoop学习笔记:hadoop文件系统浅析
1.什么是分布式文件系统? 管理网络中跨多台计算机存储的文件系统称为分布式文件系统. 2.为什么需要分布式文件系统了? 原因很简单,当数据集的大小超过一台独立物理计算机的存储能力时候,就有必要对它进行 ...
- 前端面试题之nina分享
HTML相关 1.<!DOCTYPE>标签的定义与用法. <!DOCTYPE>的定义: <!DOCTYPE>声明位于文档中的最前面的位置,处于<html> ...
- BZOJ1595 [Usaco2008 Jan]人工湖
直接模拟...从最低的开始向两边拓展= = /************************************************************** Problem: 1595 ...
- Spring学习(一)——Spring中的依赖注入简介【转】
[前面的话] Spring对我太重要了,做个关于web相关的项目都要使用Spring,每次去看Spring相关的知识,总是感觉一知半解,没有很好的系统去学习一下,现在抽点时间学习一下Spring. ...