
python爬虫+正则表达式实例爬取豆瓣Top250的图片
- 直接上全部代码
新手上路代码风格可能不太好
import requests

import re

from fake_useragent import UserAgent  #### 用来伪造爬头部信息

ua = UserAgent()

kv = {'user-agent': ua.random}

url = 'https://movie.douban.com/top250?start=0&filter='

index = 0  ####标记爬取图片的数量与命名

for i in range(0, 10):

    sum_page = i*25

    new_url = re.sub('start=\d+', 'start=%d'%sum_page, url, re.S)

    r = requests.get(new_url, headers=kv)

    r.encoding = 'utf-8'

    text = r.text

    #### 以上是一个分页爬取的操作 ####

    pictures_part = re.findall('<div class="pic">(.*?)</div>', text, re.S)

    for picture in pictures_part:

        img = re.findall('src="(.*?)" class', picture, re.S)

        pic = requests.get(img[0], headers=kv)

        fp = open('imgs\\' + str(index) + '.jpg', 'wb')  ####这里选用wb以二进制形式写入文件

        fp.write(pic.content)

        fp.close()

        print('picture' + str(index) + ' has been dawnload')

        index += 1
代码部分的解释
- 需要对爬虫的请求头部加以修改,引入fake_useragent库来进行轻微的伪造
- 利用了index在标记爬取图片数量的同时方便为爬取的图片命名
- 关于re库中的sub翻页,利用sub方法进行分页爬取
- 图片保存要以二进制形式写入
- 需要提前在和代码同目录下创建imgs文件夹
- 爬取时不无聊加了这个东西
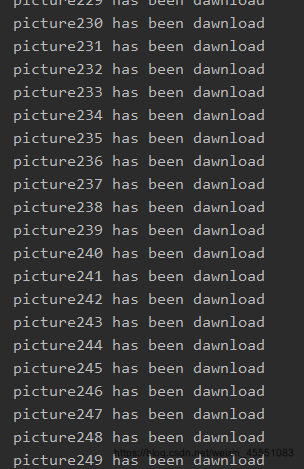
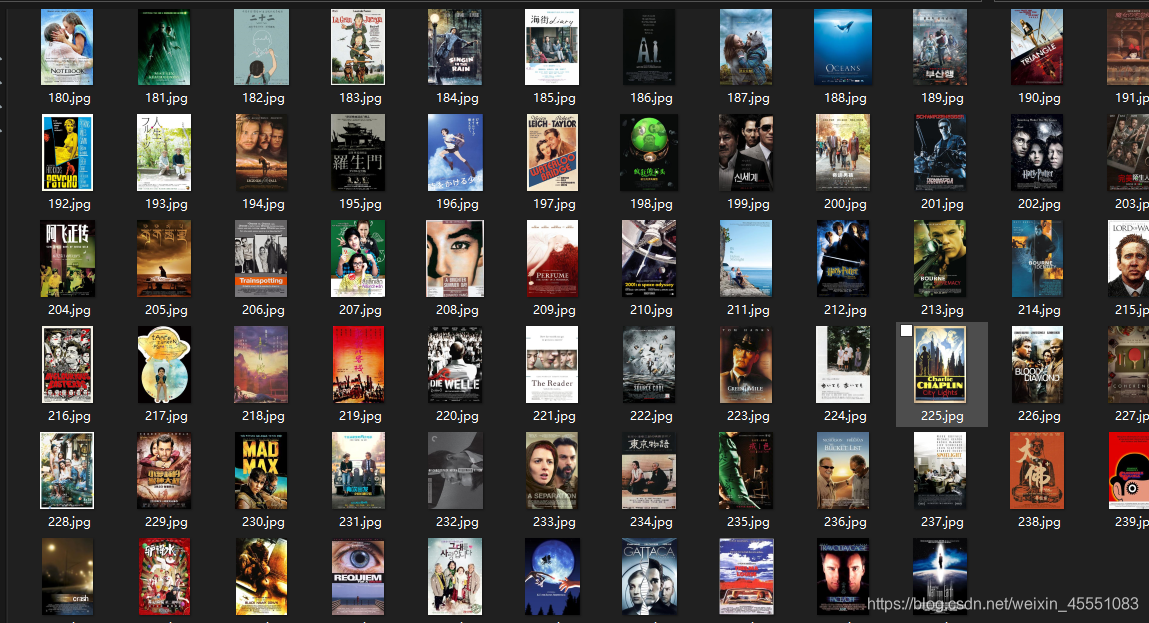
- 爬取的图片
python爬虫+正则表达式实例爬取豆瓣Top250的图片的更多相关文章
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- 爬虫学习--MOOC爬取豆瓣top250
scrapy框架 scrapy是一套基于Twisted的异步处理框架,是纯python实现的爬虫框架,用户只需要定制开发几个模块就可以轻松实现一个爬虫,用来抓取网页内容或者各种图片. scrapy E ...
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Python爬虫实战之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 对百度贴吧的任意帖子进行抓取 指定是否只抓取楼主发帖 ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
随机推荐
- Android进阶之AIDL的使用详解
原文首发于微信公众号:jzman-blog,欢迎关注交流! AIDL(Android 接口定义语言),可以使用它定义客户端与服务端进程间通信(IPC)的编程接口,在 Android 中,进程之间无法共 ...
- 操作系统-IO与显示器
1. 让外设工作起来 只要给相应的控制器中的寄存器发一个指令 向设备控制器的寄存器写不就可以了吗? 需要查寄存器地址.内容的格式和语义.操作系统需要给用户提供一个简单视图---文件视图,这样方便 总的 ...
- Spring Boot 整合视图层技术,application全局配置文件
目录 Spring Boot 整合视图层技术 Spring Boot 整合jsp Spring Boot 整合freemarker Spring Boot 整合视图层技术 Spring Boot 整合 ...
- 如何使用Rancher在OpenStack上创建K8S集群
不可否认的是,OpenStack仍然是可行的云操作系统,并且被全世界许多互联服务提供商使用.而Rancher是业界最为广泛使用的Kubernetes管理平台,通过简洁直观的GUI集中管理企业IT中的多 ...
- Redis新手的坑,无法连接、缺少类、没有密码
阿西吧,自己太菜了,用SpringBoot调用Redis缓存的时候,出了各种问题,记录一下,大家别学我 本文有自己的经验,也有从其他博客整理来的零零散散的经验. 1.安装Redis 安装redis,一 ...
- 搭建脚手架cli2.x环境
Vue脚手2.x架环境搭建 一.环境搭建 1.安装node 去官网下载node安装包 傻瓜式安装 万一安装后终端没有node环境,要进行node环境变量的配置 可以通过node提供的npm包管理器安装 ...
- JDK常用命令行工具使用
- Vulnhub DC-6靶机渗透
信息搜集 nmap -sP 192.168.146.0/24 #找靶机ip nmap -sS -Pn -A 192.168.146.143 #扫描靶机信息 22和80端口,老朋友了. 先直接访问htt ...
- protobuf总结
1.protobuf是什么? protobuf(protocol buffers)是一种语言中立,平台无关,可扩展的序列化数据的格式,可以用于通信协议,数据存储等. protobuf 相比于xml,j ...
- Flutter 实现网易云音乐字幕
老孟导读:没有接触过音乐字幕方面知识的话,会对字幕的实现比较迷茫,什么时候转到下一句?看了这篇文章,你就会明白字幕so easy. 先来一张效果图: 字幕格式 目前市面上有很多种字幕格式,比如srt, ...