
Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影)
ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互
对于ajax:
- 1.一定会有 url,请求方法(get, post),可能有数据
- 2.一般使用 json 格式
爬取豆瓣电影
- 网站分析:
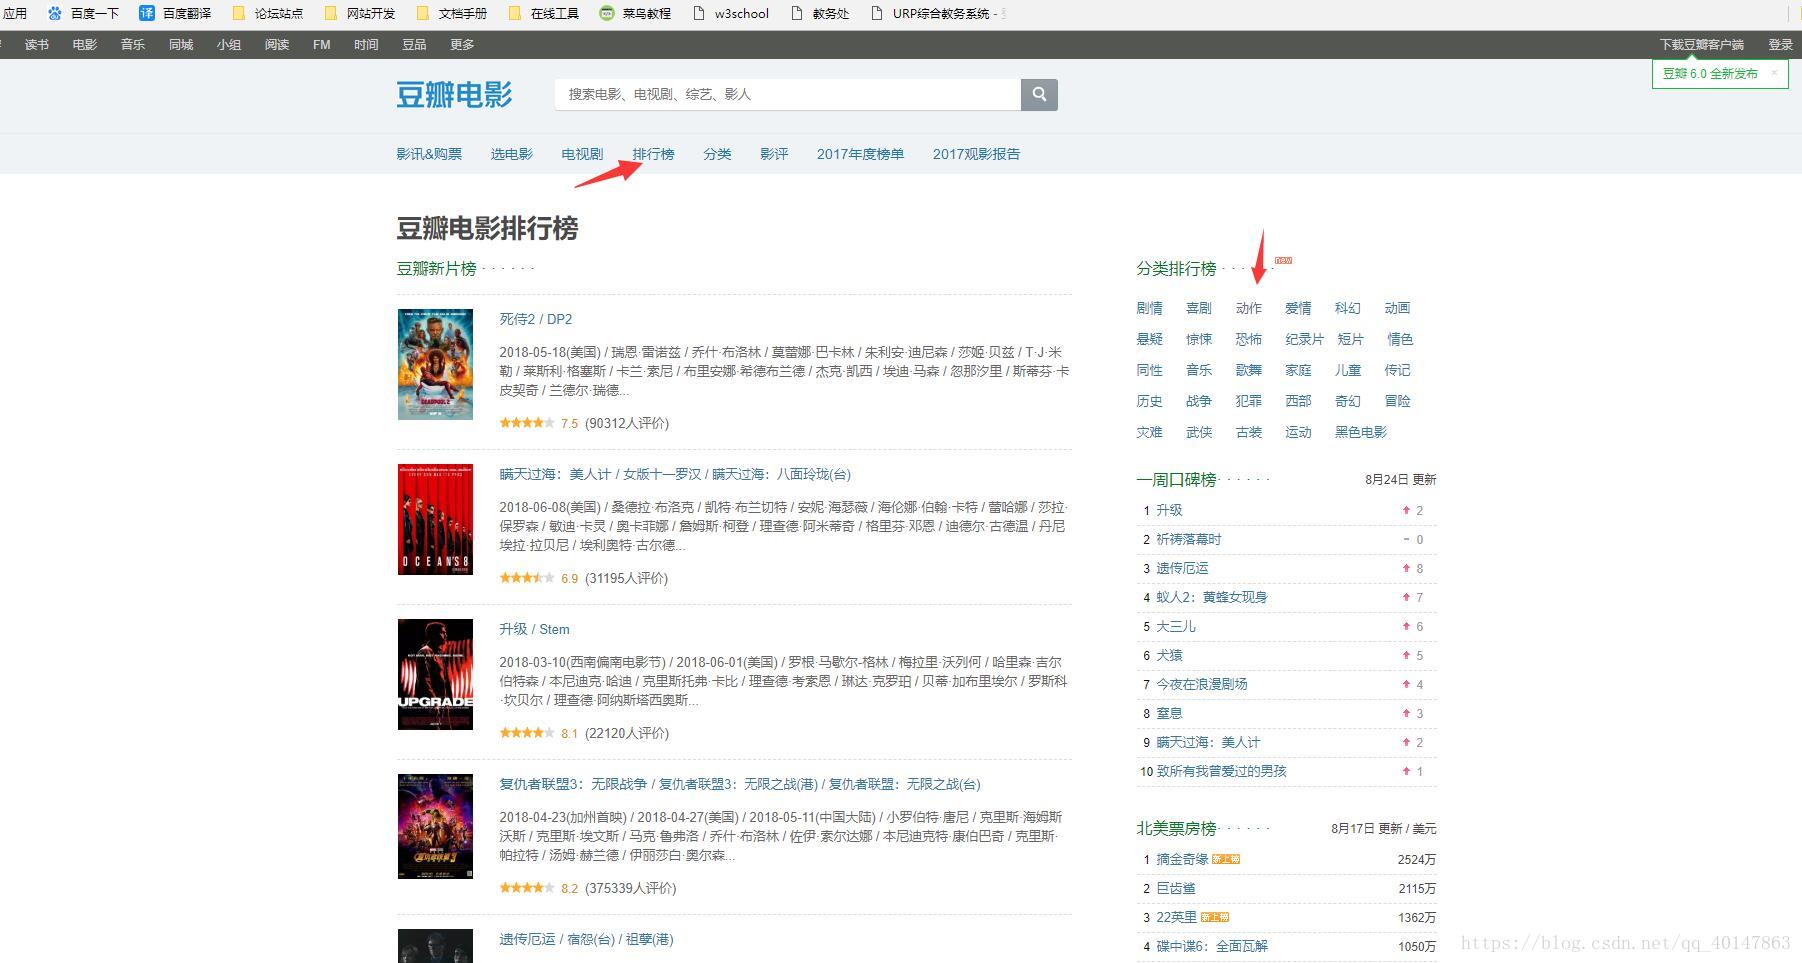
- 打开豆瓣电影网站:https://movie.douban.com/,选择【排行榜】,点击【动作】分类
- 一直往下滑,可以看到这样的效果:快到低的时候又有了新的内容,也就是往下没完
- 基本可以判定使用了 ajax 请求,进行异步的加载
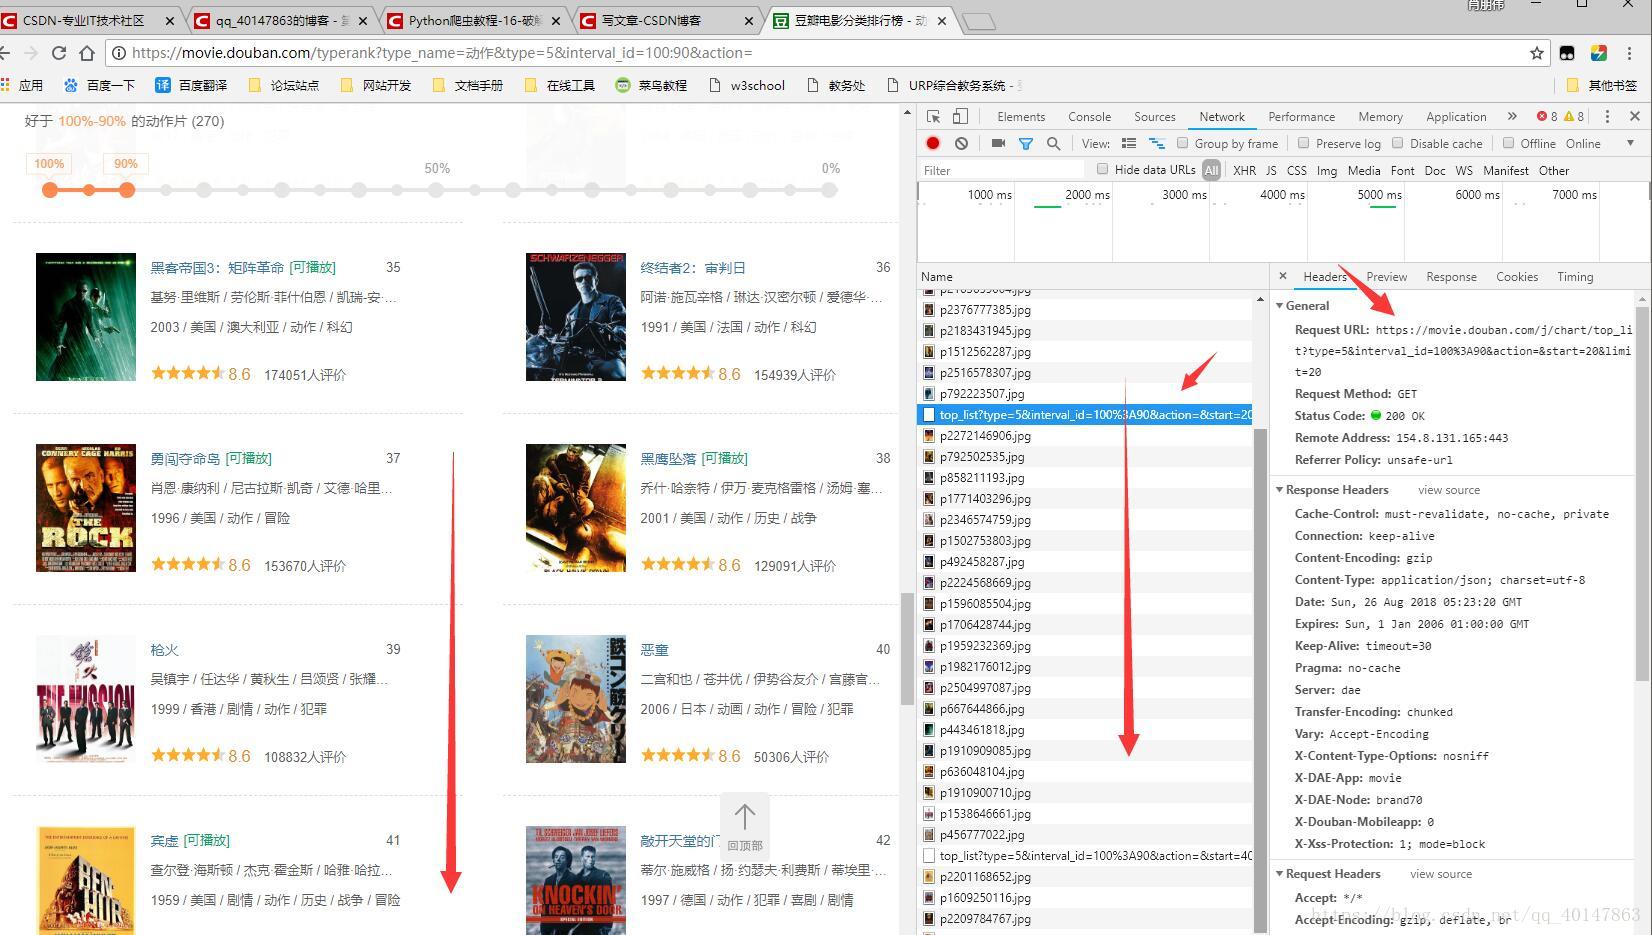
- 然后进去检查请求的信息:
- 1.右键【检查】>【Network】
- 2.向下滚动页面
- 3.可以看到请求在不断不更新,点击一个请求,就可以看到请求的信息
- 代码文件:https://xpwi.github.io/py/py爬虫/py19db.py
# 爬取豆瓣电影数据

# 了解ajax的爬取方式

# https://movie.douban.com/

from urllib import request

import json

# url信息:interval_id表示排名段(可自行修改),limit限制20个

url = "https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&start=20&limit=20"

rsp = request.urlopen(url)

data = rsp.read().decode()

data = json.loads(data)

print(data)
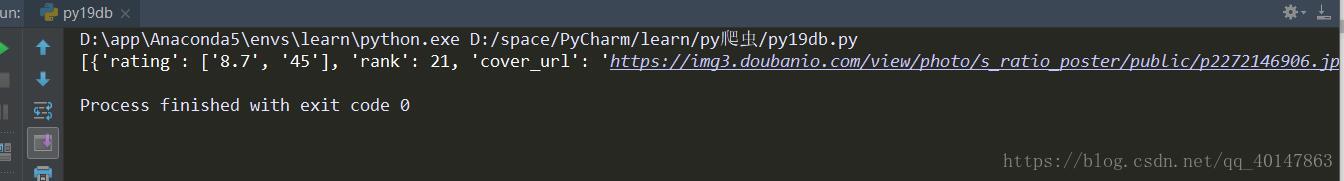
运行结果
可以看到结果在一行显示
修改输出格式
- 对于返回的json数据,我们选择想要的内容,想要的格式输出
- 代码文件:https://xpwi.github.io/py/py爬虫/py19db2.py
# 爬取豆瓣电影数据

# 了解ajax的爬取方式

# https://movie.douban.com/

from urllib import request

import json

# url信息:interval_id表示排名段(可自行修改),limit限制20个

url = "https://movie.douban.com/j/chart/top_list?type=5&interval_id=100%3A90&action=&start=20&limit=20"

rsp = request.urlopen(url)

data = rsp.read().decode()

data = json.loads(data)

# 遍历输出每个'k'和'v'的值

for item in data:

      print("排名:", item['rank'], "\n",

            "名称:", item['title'], "\n",

            "类型:", item['types'], "\n",

            "主演:", item['actors'], "\n",

            "分数:", item['score'],"\n-------------",)
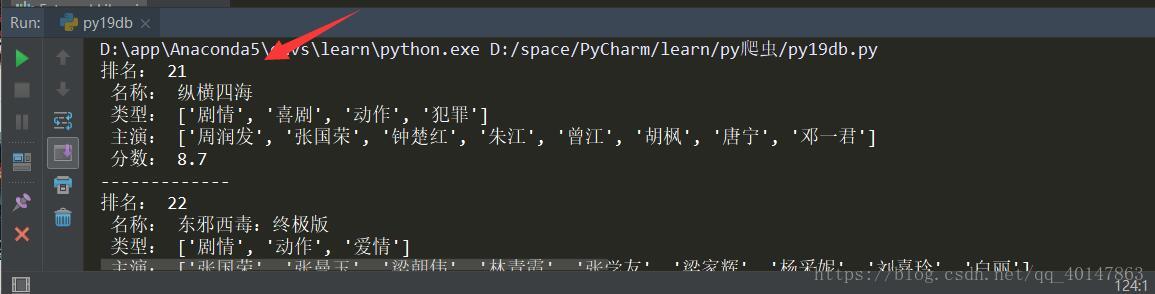
运行结果
这里结果就比较顺眼了,如果需要更改排名段,因为是get请求,修改需要在url参数即可
更多文章链接:Python 爬虫随笔
- 本笔记不允许任何个人和组织转载
Python爬虫教程-17-ajax爬取实例(豆瓣电影)的更多相关文章
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- Python爬虫教程-16-破解js加密实例(有道在线翻译)
python爬虫教程-16-破解js加密实例(有道在线翻译) 在爬虫爬取网站的时候,经常遇到一些反爬虫技术,比如: 加cookie,身份验证UserAgent 图形验证,还有很难破解的滑动验证 js签 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
- 简单的python爬虫教程:批量爬取图片
python编程语言,可以说是新型语言,也是这两年来发展比较快的一种语言,而且不管是少儿还是成年人都可以学习这个新型编程语言,今天南京小码王python培训机构变为大家分享了一个python爬虫教程. ...
- Python爬虫使用lxml模块爬取豆瓣读书排行榜并分析
上次使用了BeautifulSoup库爬取电影排行榜,爬取相对来说有点麻烦,爬取的速度也较慢.本次使用的lxml库,我个人是最喜欢的,爬取的语法很简单,爬取速度也快. 本次爬取的豆瓣书籍排行榜的首页地 ...
随机推荐
- 基础篇:6.3)形位公差-标注 Mark
本章目的:了解形位公差是如何标注的,及其意义: 1.形位公差框格 Feature Control Frames 2.被测要素的标注(两国标准不同) 2.1 中国GB标准 — 形位公差框格通过用带箭头的 ...
- archlinux安装串口终端ckermit
1. 将usb转串口连接到PC上.通过dmesg命令可以查看USB转串口是否被PC识别. 显示 ……attachec to ttyUSB0即被识别. linux系统一般有USB转串口驱动(PL ...
- sqlserver 并发机制
一.事务四大属性 分别是原子性.一致性.隔离性.持久性. 1.原子性(Atomicity) 原子性是指事务包含的所有操作要么全部成功,要么全部失败回滚,因此事务的操作如果成功就必须要完全应用到数据库, ...
- jacvascript 保留小数点
//四舍五入保留2位小数(若第二位小数为0,则保留一位小数) function keepTwoDecimal(num) { var result = parseFloat(num); if (is ...
- Python"由于目标计算机积极拒绝,无法连接。"错误解决
出现这种情况的原因是电脑使用了代理服务器,在设置中,将代理服务关闭就行 这时候通过GET访问界面就能成功了.测试代码: import requests r=requests.get('https:// ...
- selenium+Python(Js处理click失效)
有时候元素明明已经找到了,运行也没报错,点击后页面没任何反应.这种问题遇到了,是比较头疼的,因为没任何报错,只是 click 事件失效了. 问题: 1.在练习百度的搜索设置按钮时,点保存设置按钮,al ...
- 【CSS】 布局之多列等高
这两天看了不少文章,对于css布局多了一些理解,现在来总结下. 我们来写一个最普遍的Top.Left.Content.Right.Foot布局. 第一步:自然是写一个坯子 <!DOCTYPE H ...
- 万物智联,腾讯云 IoT 边缘计算揭秘——云+未来峰会开发者专场回顾
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 背景:现在是万物互联的时代,智能穿戴设备,智能家居,无人商业,改变了我们的生活方式.预计到2021年,全球物联网设数将达到150亿,超过手机 ...
- 【c++】输出文件的每个单词、行
假设文件内容为 1. hello1 hello2 hello3 hello4 2. dsfjdosi 3. skfskj ksdfls 输出每个单词 代码 #include <iostream& ...
- .NET环境下的DPAPI加密编程
Windows的本地加密保护机制提供了简单的调用接口,密钥的生成.保护等事项一概由系统来处理,其编程接口称为DPAPI.这一加密保护机制的边界是用户登录帐户或者本地计算机系统,使用操作系统设定的加密处 ...