
machine learning for hacker记录(2) 数据分析
本章主要讲了对数据的一些基本探索,常见的six numbers,方差,均值等
 > data.file <- file.path('data', '01_heights_weights_genders.csv')

 > heights.weights <- read.csv(data.file, header = TRUE, sep = ',')

 > heights <- with(heights.weights, Height)

 > summary(heights)

    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.

   54.26   63.51   66.32   66.37   69.17   79.00
上面是six numbers:最小值,第一个四分位数,中位数(注意跟均值的区别),均值,第三个四分位数,最大值
中位数跟均值的区别:中位数 就是指数据排序后处于中间的那个数,而均值就是算术平均值,在R中可以直接用函数mean(),median()来求出。
同时,R中的quantile函数是计算数据的分位数的,默认情况是0%,25%,50%,75%,100%,例如:
 > quantile(heights)

       0%      25%      50%      75%     100%

 54.26313 63.50562 66.31807 69.17426 78.99874

 > quantile(heights,probs=seq(0,1,by=0.2))

       0%      20%      40%      60%      80%     100%

 54.26313 62.85901 65.19422 67.43537 69.81162 78.99874

 > quantile(heights,probs=c(0,0.1,0.5,0.9,1))

       0%      10%      50%      90%     100%

 54.26313 61.41270 66.31807 71.47215 78.99874
后面两个就是自定义所需的分位数。
对于一份数据 光有six numbers 可能还不能很好的刻画数据的分布,对此统计学家引入了方差、标准差的概念,方差是明确了数据集中数据与均值的平均偏离程度,标准差是sqrt(方差)。对应R语言内置的函数var(),std()可以计算。
以上讲的是一些简单的统计学术语,接下来描述的是有关数据可视化的相关技术,并引出了一些基本的分布。
对上面heigths的数据,画出身高的频率直方图
ggplot(heights.weights, aes(x = Height)) +geom_histogram(binwidth = 1)
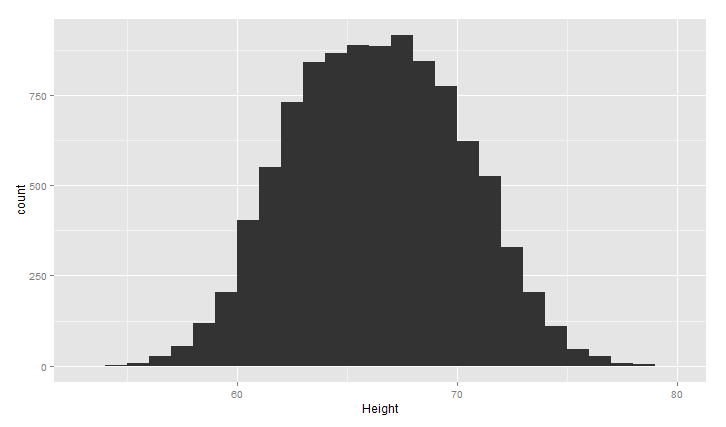
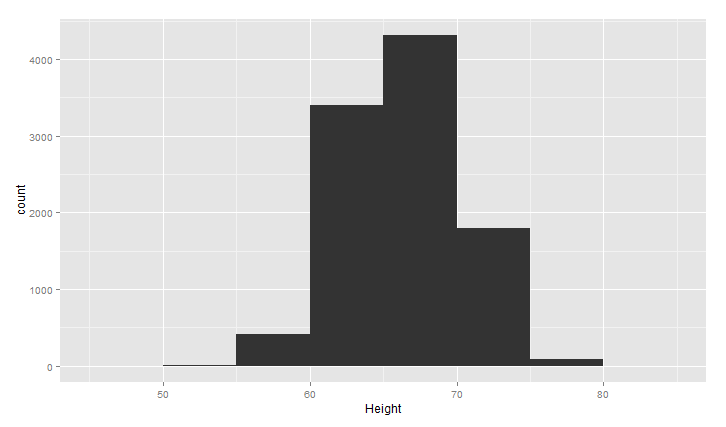
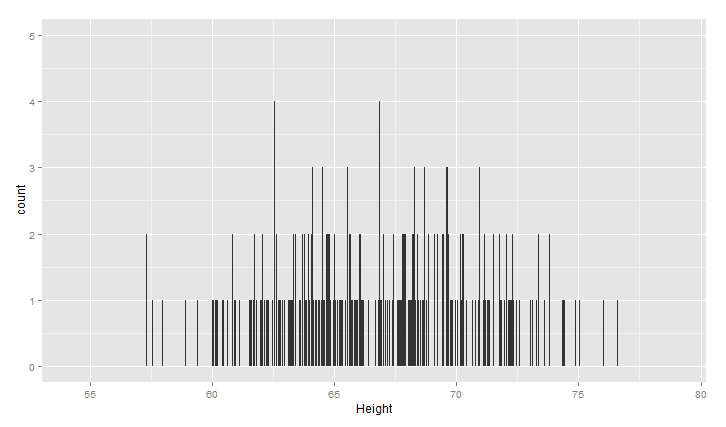
上面的图大致呈现正太分布,中间高,两边低,binwidth是直方图的宽度,设置不同,图形效果不同,下面看两种情况(过平滑和欠平滑)
ggplot(heights.weights, aes(x = Height)) +geom_histogram(binwidth = 5)
ggplot(heights.weights, aes(x = Height)) +geom_histogram(binwidth = 0.001)
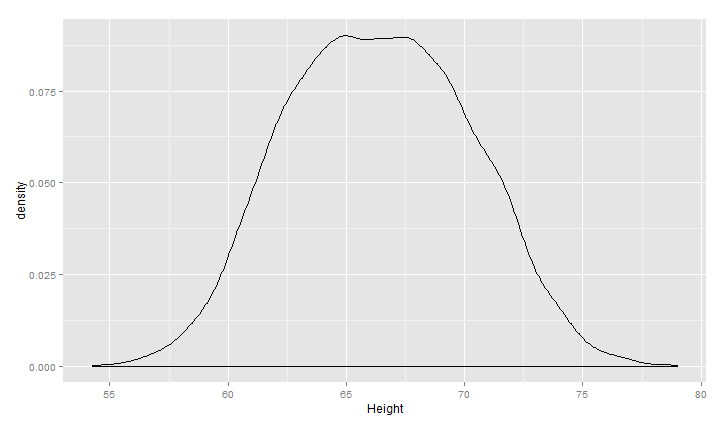
同时,可以用核密度估计KDE/密度曲线图来描述数据分布:
ggplot(heights.weights, aes(x = Height)) +geom_density()
把数据样本分性别来看
ggplot(heights.weights, aes(x = Height,fill=Gender)) +geom_density()
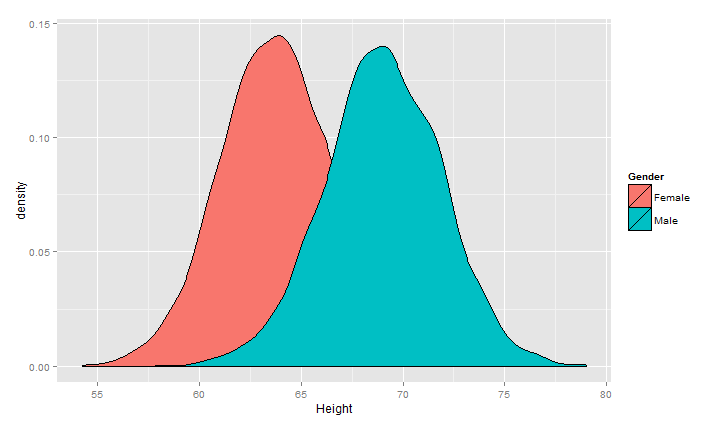
对两个曲线画成子图的模式
ggplot(heights.weights, aes(x = Height,fill=Gender)) +geom_density() +facet_grid(Gender~.)
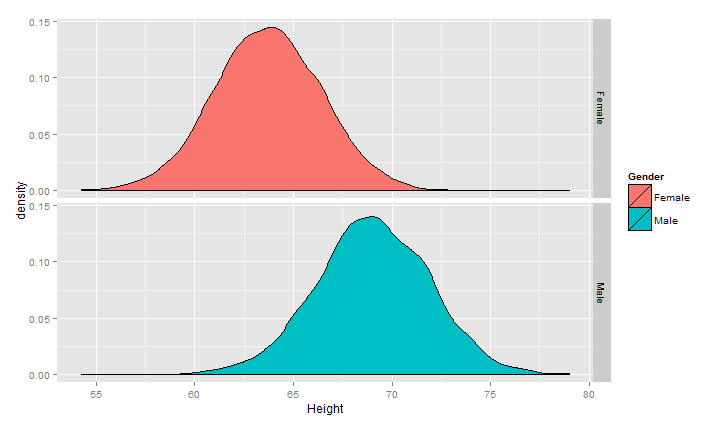
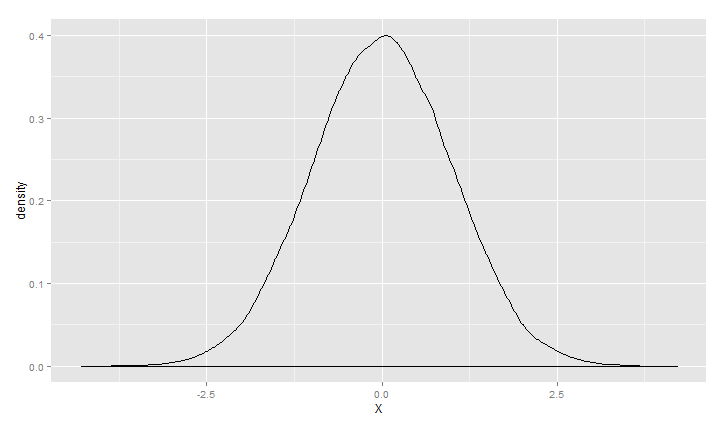
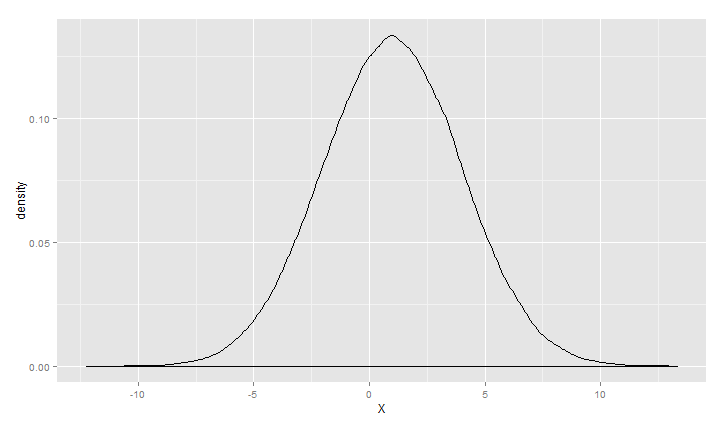
对上面的情况可以描述为高斯(正态)混合模型,正态分布应用范围非常广泛,链接http://songshuhui.net/archives/76501很清晰的讲了正态分布的“前世今生”,下面看一下高斯分布在不同均值跟方差下的 图形情况.
 > m<-0

 > s<-1

 > ggplot(data.frame(X=rnorm(100000,m,s)), aes(x = X)) +geom_density()
 > m<-1
 > s<-3
 > ggplot(data.frame(X=rnorm(100000,m,s)), aes(x = X)) +geom_density()
 > m<-0

 > s<-5
 > ggplot(data.frame(X=rnorm(100000,m,s)), aes(x = X)) +geom_density()
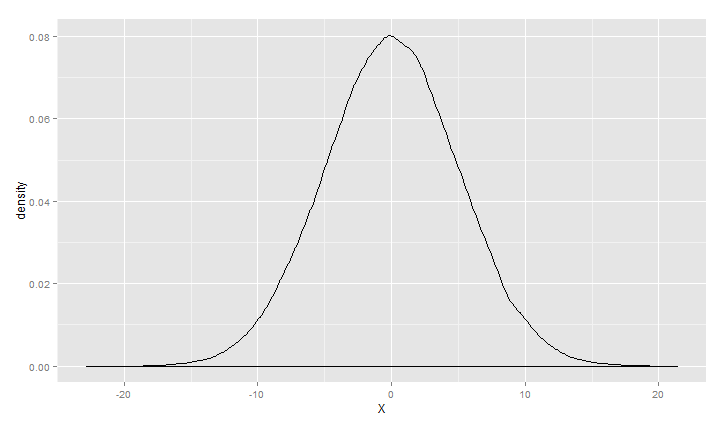
正态分布在99%的情况下所产生的的数据偏离均值不会超过3个标准差,但是对于柯西分布来说,只有90%。
> ggplot(data.frame(X=rcauchy(100000,0,1)), aes(x = X)) +geom_density()
伽玛分布
>ggplot(data.frame(X=rcauchy(100000,0,1)), aes(x = X)) +geom_density()
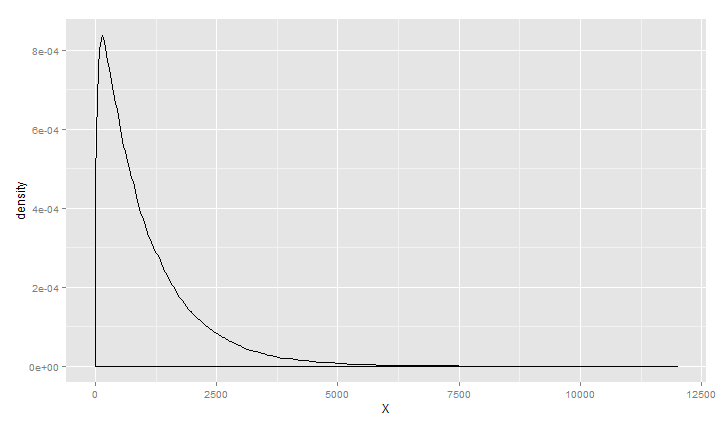
书中还统计苹果手机游戏《屋顶狂奔》的得分,KDE曲线符合伽玛分布,现实好多数据分布也是伽玛分布,如企业呼叫中心收到呼叫请求的时间间隔,还有游戏数据等等;
以上所有的绘图都是单变量的可视化,接着可以看下两个变量之间的关系
散点图
>ggplot(heights.weights, aes(x = Height,y=Weight)) +geom_point()

从图中看到,这两个变量存在某种关系,如越高的人,体重越大
>ggplot(heights.weights, aes(x = Height,y=Weight)) +geom_point() +geom_smooth()

对画图中加入性别
>ggplot(heights.weights, aes(x = Height,y=Weight,color=Gender)) +geom_point() +geom_smooth()
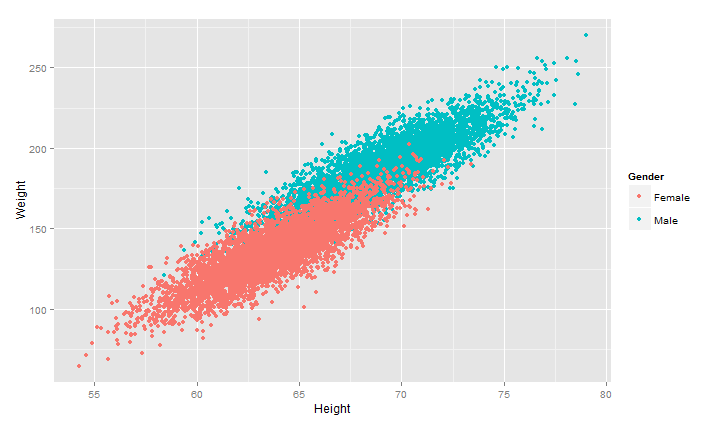
可以看出男女的分界线很鲜明,很容易用分类算法根据身高、体重来预测其性别,详细的分类算法下回分解O(∩_∩)O
machine learning for hacker记录(2) 数据分析的更多相关文章
- machine learning for hacker记录(3) 贝叶斯分类器
本章主要介绍了分类算法里面的一种最基本的分类器:朴素贝叶斯算法(NB),算法性能正如英文缩写的一样,很NB,尤其在垃圾邮件检测领域,关于贝叶斯的网上资料也很多,这里推荐那篇刘未鹏写的http://mi ...
- machine learning for hacker记录(4) 智能邮箱(排序学习&推荐系统)
本章是上一章邮件过滤技术的延伸,上一章的内容主要是过滤掉垃圾邮件,而这里要讲的是对那些正常的邮件是否可以加入个性化元素,由于每个用户关心的主题并非一样(有人喜欢技术类型的邮件或者购物促销方便的内容邮件 ...
- machine learning for hacker记录(1) R与机器学习
开篇:首先这本书的名字很霸气,全书内容讲的是R语言在机器学习上面的应用,一些基本的分类算法(tree,SVM,NB),回归算法,智能优化算法,维度约减等,机器学习领域已经有很多成熟的R工具箱,毕竟这个 ...
- Machine Learning in Action(3) 朴素贝叶斯算法
贝叶斯决策一直很有争议,今年是贝叶斯250周年,历经沉浮,今天它的应用又开始逐渐活跃,有兴趣的可以看看斯坦福Brad Efron大师对其的反思,两篇文章:“Bayes'Theorem in the 2 ...
- 【机器学习Machine Learning】资料大全
昨天总结了深度学习的资料,今天把机器学习的资料也总结一下(友情提示:有些网站需要"科学上网"^_^) 推荐几本好书: 1.Pattern Recognition and Machi ...
- 机器学习(Machine Learning)&深度学习(Deep Learning)资料【转】
转自:机器学习(Machine Learning)&深度学习(Deep Learning)资料 <Brief History of Machine Learning> 介绍:这是一 ...
- 机器学习(Machine Learning)&深度学习(Deep Learning)资料汇总 (上)
转载:http://dataunion.org/8463.html?utm_source=tuicool&utm_medium=referral <Brief History of Ma ...
- 机器学习(Machine Learning)与深度学习(Deep Learning)资料汇总
<Brief History of Machine Learning> 介绍:这是一篇介绍机器学习历史的文章,介绍很全面,从感知机.神经网络.决策树.SVM.Adaboost到随机森林.D ...
- 聊天机器人(chatbot)终极指南:自然语言处理(NLP)和深度机器学习(Deep Machine Learning)
在过去的几个月中,我一直在收集自然语言处理(NLP)以及如何将NLP和深度学习(Deep Learning)应用到聊天机器人(Chatbots)方面的最好的资料. 时不时地我会发现一个出色的资源,因此 ...
随机推荐
- ajax 将整个表单提交到后台处理
$(document).on('click', '.user-save-btn', function () { $.ajax({ url: 'index', type: 'post', dataTyp ...
- UVA - 10196:Check The Check
类型:简单模拟 大致题意:已知国际象棋行棋规则,给你一个局面,问是否将军?谁将谁的军?(保证不会同时将军) 思路:都以小写字母 测试 是否将 大写字母. 然后一个局面测两次(一次直接测,一次反转棋盘, ...
- 洛谷——P2878 [USACO07JAN]保护花朵Protecting the Flowers
P2878 [USACO07JAN]保护花朵Protecting the Flowers 题目描述 Farmer John went to cut some wood and left N (2 ≤ ...
- k8s之pod控制器
1.生产中,很少会跑一个自主式pod,一般由控制器去创建pod,其配置文件中内嵌了pod的创建方式. pod控制器:ReplicaSet.Deployment.DaemonSet.Job.Cronjo ...
- 【GitHub】删除GitHub上的文件
想要删除已经提交上GitHub上的文件, 删除之后,如果这个文件夹下没有文件了,这个文件夹也会被删除! 并且在它的上层文件夹后面 有提示删除了这个文件的信息!!
- iOS -- SKTextureAtlas类
SKTextureAtlas类 继承自 NSObject 符合 NSCodingNSObject(NSObject) 框架 /System/Library/Frameworks/SpriteKi ...
- TensorFlow 之 高层封装slim,tflearn,keras
tensorflow资源整合 使用原生态TensorFlow API来实现各种不同的神经网络结构.虽然原生态的TensorFlow API可以很灵活的支持不同的神经网络结构,但是其代码相对比较冗长,写 ...
- Hierarchical data in postgres
https://coderwall.com/p/whf3-a/hierarchical-data-in-postgres --------------------------------------- ...
- pycharm pull到github
1.setting中找到github 正确输入邮箱密码,勾上ssh 2.在本机中git bash 得到ssh代码 输入到github 个人setting中 3.在pycharm中setting项git ...
- xgboost的SparkWithDataFrame版本实现
再xgboost的源码中有xgboost的SparkWithDataFrame的实现,如下:https://github.com/dmlc/xgboost/tree/master/jvm-packag ...