
Python:爬取中国各市的疫情数据并存储到数据库
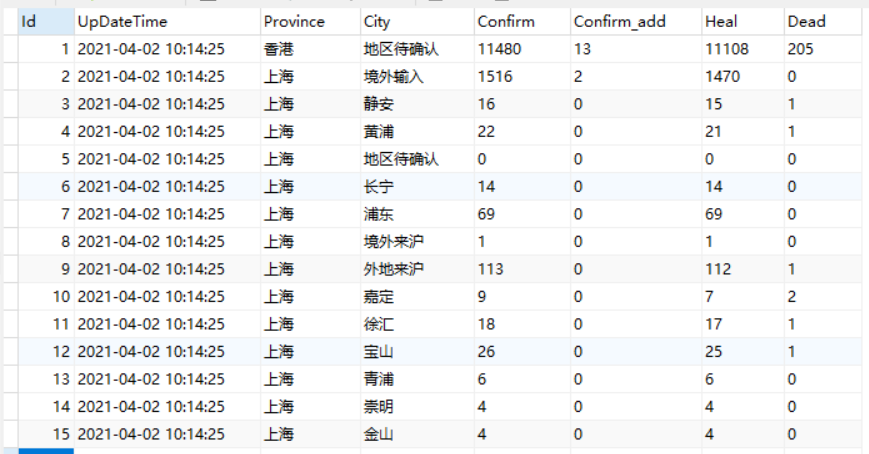
import requests

import pymysql

import json

def create():

    # 连接数据库

    db = pymysql.connect(host = 'localhost', user = 'root', password ='258000', database = 'yiqing',charset='utf8')

    # 使用 cursor() 方法创建一个游标对象 cursor

    cursor = db.cursor()

    # 使用 execute() 方法执行 SQL,如果表存在则删除

    cursor.execute("DROP TABLE IF EXISTS payiqing")

    # 使用预处理语句创建表

    sql = """CREATE TABLE payiqing (

            Id INT PRIMARY KEY AUTO_INCREMENT,

            UpDateTime varCHAR(255),

            Province varchar(255),

            City varchar(255),

            Confirm varchar(255),

            Confirm_add varchar(255),

            Heal varchar(255),

            Dead varchar(255))"""

    #upDateTime,provinse,city,confirm,confirm_add,heal,dead

    cursor.execute(sql)

    #关闭数据库连接

    db.close()

def insert(value):

    # 连接数据库

    db = pymysql.connect(host = 'localhost', user = 'root', password ='258000', database = 'yiqing',charset='utf8')

    # 使用 execute() 方法执行 SQL,如果表存在则删除

    cursor = db.cursor()

    # 使用预处理语句插入数据

    sql = "INSERT INTO payiqing(UpDateTime,Province,City,Confirm,Confirm_add,Heal,Dead) VALUES ( %s,%s,%s,%s,%s,%s,%s)"

    #updateDateTime,provinse,city,confirm,confirm_add,heal,dead

    try:

        cursor.execute(sql, value)

        db.commit()

        print('插入数据成功')

    except:

        db.rollback()

        print("插入数据失败")

    db.close()

create()  # 创建表

#目标网站

url = 'http://view.inews.qq.com/g2/getOnsInfo?name=disease_h5'

#请求资源,获取相应内容

resp = requests.post(url)

#打印网页内容 print(resp.text)

# 将响应信息进行json格式化

#一个从文件加载,一个从内存加载#json.load(filename)#json.loads(string)

jsonData = json.loads(resp.text)

data_all = json.loads(jsonData["data"])

#保存全国历史数据

history = {}

#print(data_all.keys())

i = data_all["chinaTotal"]

history = {"lastUpdateTime":data_all["lastUpdateTime"],"confirm":i["confirm"] ,"heal":i["heal"],"dead":i["dead"],"suspect":i["suspect"]}

#print(history)

#用于存储当日详细数据的集合

details = []

upDateTime = data_all["lastUpdateTime"]#储存最近更新时间

data_province = data_all["areaTree"][0]["children"] #中国各省

#遍历存储

for pro in data_province:

  provinse = pro["name"]   #省名

  for cit in pro["children"]:

    city = cit["name"]

    confirm = cit["total"]["confirm"]

    confirm_add = cit["today"]["confirm"]

    heal = cit["total"]["heal"]

    dead = cit["total"]["dead"]

    insert((upDateTime,provinse,city,confirm,confirm_add,heal,dead))#存入数据库
Python:爬取中国各市的疫情数据并存储到数据库的更多相关文章
- Python爬取中国天气网
Python爬取中国天气网 基于requests库制作的爬虫. 使用方法:打开终端输入 “python3 weather.py 北京(或你所在的城市)" 程序正常运行需要在同文件夹下加入一个 ...
- python 爬取天猫美的评论数据
笔者最近迷上了数据挖掘和机器学习,要做数据分析首先得有数据才行.对于我等平民来说,最廉价的获取数据的方法,应该是用爬虫在网络上爬取数据了.本文记录一下笔者爬取天猫某商品的全过程,淘宝上面的店铺也是类似 ...
- python爬取中国天气网站数据并对其进行数据可视化
网址:http://www.weather.com.cn/textFC/hb.shtml 解析:BeautifulSoup4 爬取所有城市的最低天气 对爬取的数据进行可视化处理 按温度对城市进行排 ...
- Python爬取6271家死亡公司数据,一眼看尽十年创业公司消亡史!
小五利用python将其中的死亡公司数据爬取下来,借此来观察最近十年创业公司消亡史. 获取数据 F12,Network查看异步请求XHR,翻页. 成功找到返回json格式数据的url, 很多人 ...
- Python 爬取大众点评 50 页数据,最好吃的成都火锅竟是它!
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 胡萝卜酱 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- Python爬取上交所一年大盘数据
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 半个码农2018 PS:如有需要Python学习资料的小伙伴可以加点 ...
- Python爬取6271家死亡公司数据,看十年创业公司消亡史
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 朱小五 凹凸玩数据 PS:如有需要Python学习资料的小伙伴可以加 ...
- python爬取中国大学排名
教程来自:[Python网络爬虫与信息提取].MOOC. 北京理工大学 目标:爬取最好大学网前50名大学 代码如下: import requests from bs4 import Beautiful ...
- Python爬取某网站文档数据完整教程(附源码)
基本开发环境 (https://jq.qq.com/?_wv=1027&k=NofUEYzs) Python 3.6 Pycharm 相关模块的使用 (https://jq.qq.com/?_ ...
随机推荐
- Visual Studio双击打开项目而不是项目属性文件
从VS2019版本就默认勾选了这个,每次打开都是到属性文件,这个根本用不到,点击小三角又比较麻烦,不知道为啥微软给了这个默认功能 VS2022 Preview也是,默认勾选 勾选如下即可:
- Spark SQL和CSl
目录 1 2 3 4 1 import org.apache.spark.sql.{DataFrame, SaveMode, SparkSession} object Demo1Sess { def ...
- python+selenium+pycharm使用
上一章节讲了安装python及selenium,该章节讲解下使用pycharm编辑器进行代码编写 下载地址:http://www.jetbrains.com/pycharm/download/#sec ...
- Spring Cloud Gateway 不小心换了个 Web 容器就不能用了,我 TM 人傻了
个人创作公约:本人声明创作的所有文章皆为自己原创,如果有参考任何文章的地方,会标注出来,如果有疏漏,欢迎大家批判.如果大家发现网上有抄袭本文章的,欢迎举报,并且积极向这个 github 仓库 提交 i ...
- linux bash shell 的配置文件
按生效范围划分两类 全局配置:针对所有用户皆有效 /etc/profile /etc/profile.d/*.sh /etc/bashrc 个人配置:只针对特定用户有效 ~/.bash_profile ...
- DataFrame计算corr()函数计算相关系数时,出现返回值为空或NaN的情况+np.log1p()
- Cobalt Strike之LINK木马
在同一目录下 新建一个exp.ps1 一个test.txt exp.ps1代码 $file = Get-Content "test.txt" $WshShell = New-Obj ...
- Redis数据结构详解(1)-redis中的字符串(SDS)
前提知识 我们先从百科上摘下Redis的解释: Redis是一个使用ANSI C编写的开源.支持网络.基于内存.分布式.可选持久性的键值对存储数据库. (不用过多在意ANSI,它只是一个标准,你可以理 ...
- Future和FutureTask的区别
java中有Future和FutureTask这两个类 Future是一个接口,代表可以取消的任务,并可以获得任务的执行结果 FutureTask 是基本的实现了Future和runnable接口 ...
- Linux 性能调优都有哪几种方法?
1.Disabling daemons (关闭 daemons). 2.Shutting down the GUI (关闭 GUI). 3.Changing kernel paramete ...