
10倍!BoostKit鲲鹏全局缓存3大创新技术助力Ceph性能提升
摘要:本文从四个方面阐述了BoostKit鲲鹏全局缓存技术,该技术针对Ceph开源存储方案存在的痛点,采用三大创新技术,有效的提高了Ceph的性能,最高可以将Ceph性能提升10倍。
本文分享自华为云社区《【云驻共创】BoostKit鲲鹏全局缓存技术助力Ceph性能提升10倍,真香》,作者:码农飞哥。
1. 存储行业特点及挑战
有统计数据显示,企业应用每增加100ms存储时延会造成1%的销售损失。如下图所示:
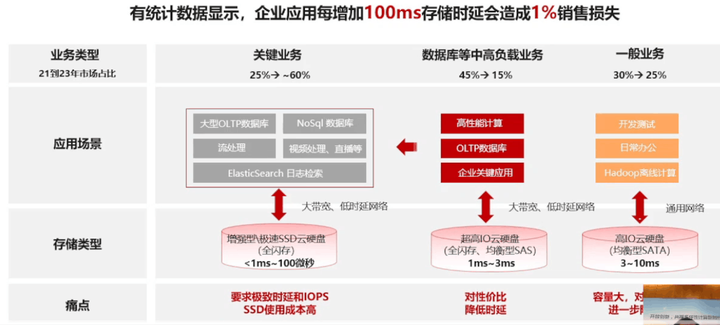
从21年到23年,关键业务的占比从25%增加到60%,数据库等中高负载业务从45%减少到15%,一般业务从 30%减少到25%。
对于关键业务一般使用的存储类型是 增强型\极速SSD云硬盘(全闪存),这种方式主要的痛点是 要求极致时延和IOPS SSD使用成本高。
对于数据库等中高负载业务使用的存储类型是超高IO云硬盘(全闪存、均衡型SAS),这种方式的主要痛点是对性价比降低时延。
对于一般业务使用的是高IO云硬盘(均衡型SATA)
1.1.Ceph开源存储方案面临的性能挑战
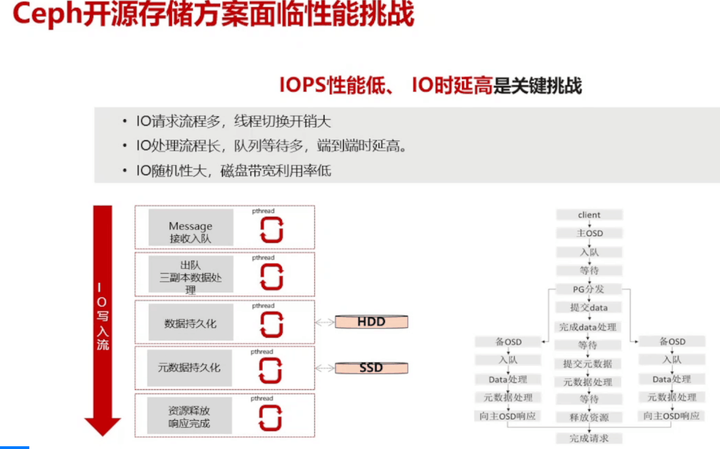
Ceph开源存储方案面临的性能挑战主要是: IOPS性能低,IO时延高。 而造成这种情况的原因主要有如下三个方面:
- IO请求流程多,线程切换开销大
- IO处理流程长,队列等待多,端到端时延高。
- IO随机性大,磁盘带宽利用率低。
IO的写入流程是:
- Message 接受入队
- 三副本数据处理
- 数据持久化
- 元数据持久化
- 资源释放,响应完成。
我们可以看到一个完整的IO写入流程包括了5大流程,流程真的很长。
那么BoostKit鲲鹏全局缓存技术又是如何应对这些挑战的呢?
2. 全局缓存创新与价值
BoostKit鲲鹏全局缓存技术主要有三大创新技术,通过三大创新技术可以实现存储性能飞跃式提升。
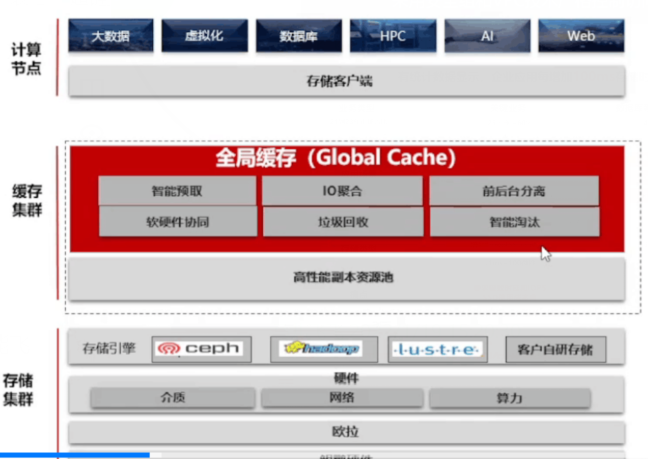
- 缓存前后台分离,缩短IO路径
- IO聚合,实现磁盘带宽性能
- 智能预取,提高读缓存命中率。
下面我分别就这三大创新技术进行一个简要的说明。
2.1. 缓存前后台分离,缩短IO路径
- 在计算侧(前台)重定向到全局缓存,读写IO请求直接在缓存中命中并实时反馈给上层应用。
- 全局缓存的IO数据异步下刷到后端存储侧(后台)或提前预取数据到全局缓存
其实现流程如下图所示:
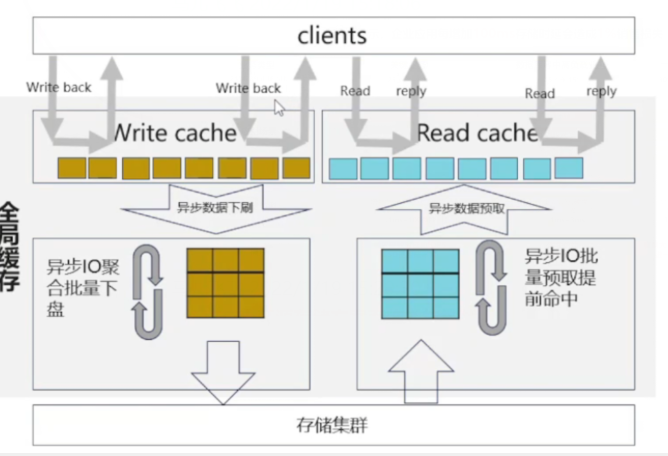
从图中可以看出读IO和写IO都是在全局缓存中实现的。
写IO首先将数据写入缓存中,然后异步下刷到磁盘中。
异步IO批量预取提前命中,异步数据预取,读IO直接从缓存中取数据。
这样做的好处就是 提高了异步刷盘速率,保证写缓存100%命中,降低写时延。
提高预取准确率,加大缓存容量,保证读缓存80%命中,降低读时延。
如下图所示:展示了缓存前后台的具体实现。
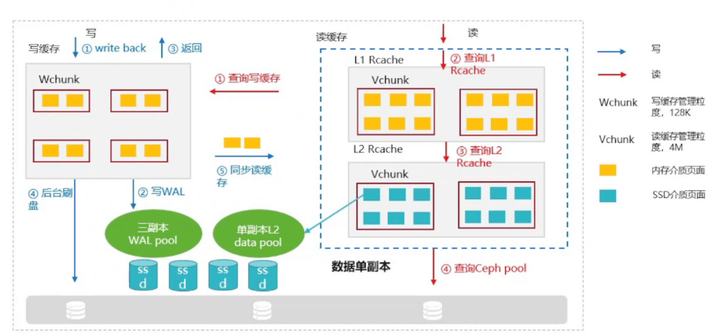
- 流程解耦:写缓存刷盘,读缓存淘汰无需互斥,可灵活控制各自水位。
- 资源解耦:读写缓存并发,Quota资源等解耦,避免相互影响。
- 介质类型解耦:读写缓存可分为管理异构缓存介质(RAM,NVMeSSD),实现介质分离。
- 冗余策略优化:读cache使用单副本,提高cache空间利用率,写cache使用三副本,保证数据可靠性。
2.2. IO聚合,实现磁盘带宽性能
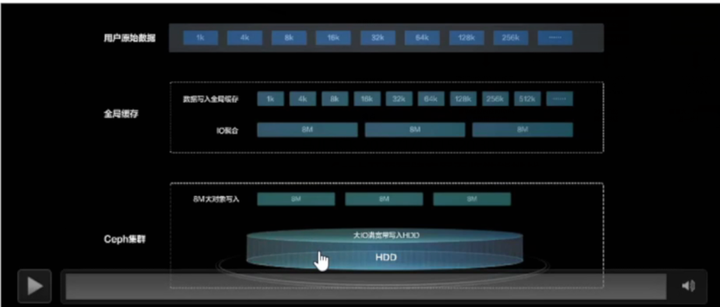
- IO聚合:通过聚合算法,回写策略和垃圾回收等能力,实现随机写小IO聚合成顺序写大IO,实现磁盘带宽的利用率,使性能得到大幅提升。
- 按需读取:从元数据中获取小IO映射关系,下盘读取小IO数据,无读放大。
- 通过高效的索引算法和数据排列,仅提高有效数据块,并和新写入的数据进行IO聚合,减少IO开销和降低垃圾对业务的影响。
具体实现如下图所示:
2.3. 智能预取,提高读缓存命中率
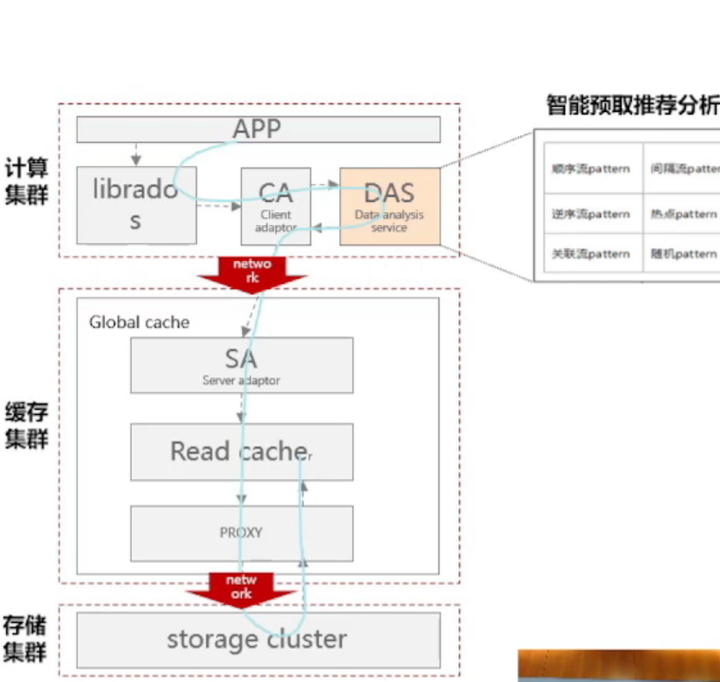
基于创新的负载识别算法,识别不同应用访问Pattern(如流式、关联、热点等),并通过归一化特征模型制定最优参数(预取门限,长度等),实现80%以上缓存命中率和2倍+读性能提升。
如下图所示:展示了智能预取分离技术架构:
这里主要有两个技术
- 双引擎分离:创新性的Client端推荐引擎+Server端执行引擎分离的智能预取架构。
- 全局精准推荐:推荐引擎拥有全局数据访问视图,从而进行全局精准推荐。
3. 全局缓存功能介绍
3.1. 全局缓存技术的整体架构
说完了全局缓存的创新点之后,接下来让我们来看看全局缓存的各个核心功能。
全局缓存技术的整体架构如下图所示:
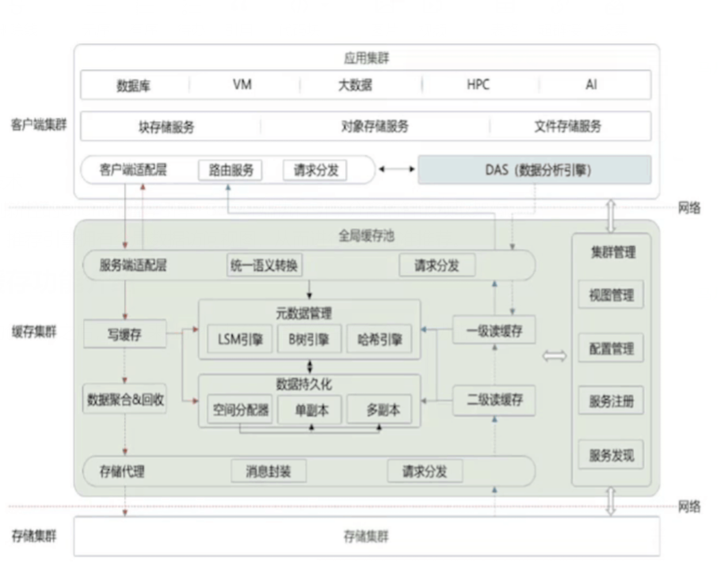
可以用三横+两纵来总结全局缓存技术框架。
三横:客户端集群、缓存集群、存储集群
两纵:读写路径分离双驱加速的逻辑布局。
- 写缓存:数据写入、删除功能、保证Cache前后台写低时延、
- 读缓存:数据读取功能,数据预取和淘汰、保证高Cache命中。
- 元数据管理:高性能元数据管理引擎、小IO聚合、垃圾回收
- 集群管理:集群管理、运行状态管理,故障处理框架。
- 持久化:数据持久化存储,三副本资源池,介质管理。
- 适配层:对接开源Ceph存储,终结Ceph语义。
- 基础设施:系统启动、内存管理、日志、命令行、系统调度。
3.2. 全局缓存功能规格一览
1. 高性能
支持单节点 14W IOPS,1ms时延。
2. 集群兼容性
- 提供无侵入式接口API支持主流ceph集群接入
- 支持块存储服务,对象存储服务
- 支持快照及克隆功能
- 支持鲲鹏平台硬件,openEuler,RedHat系统
3. 可靠性
- 数据持久化存储防掉电丢失。
- 数据三副本以节点域存储,防止单点故障。
- 支持集群故障自动检测,自动故障切换和恢复。
4. 安全性
- 数据通道和管理通道默认支持TLS1.3 安全传输
5. 扩展性
- 支持按需增加缓存节点扩展缓存规模
- 支持在线升级
- 数据持久化存储防掉电丢失
- 数据三副本以节点域存储,防止单点故障
- 支持集群故障自动检测,自动故障切换和恢复。
4. 全局缓存使用介绍
说完了那么多BoostKit鲲鹏全局缓存技术的功能和好处,那么如何使用BoostKit鲲鹏全局缓存呢?
首先找到用户指南,指南地址是:https://support.huawei.com/enterprise/zh/doc/EDOC1100228002?idPath=23710424%7C251364417%7C9856629%7C253662285
按照用户指南一步步去操作使用吧!!!!
总结
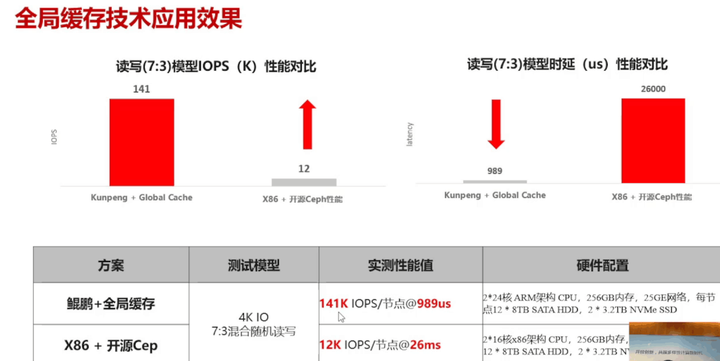
本文从四个方面阐述了BoostKit鲲鹏全局缓存技术,该技术针对Ceph开源存储方案存在的痛点,采用三大创新技术,有效的提高了Ceph的性能,最高可以将Ceph性能提升10倍。如下图所示:
10倍!BoostKit鲲鹏全局缓存3大创新技术助力Ceph性能提升的更多相关文章
- 如何利用缓存机制实现JAVA类反射性能提升30倍
一次性能提高30倍的JAVA类反射性能优化实践 文章来源:宜信技术学院 & 宜信支付结算团队技术分享第4期-支付结算部支付研发团队高级工程师陶红<JAVA类反射技术&优化> ...
- Databricks缓存提升Spark性能--为什么NVMe固态硬盘能够提升10倍缓存性能(原创)
我们兴奋的宣布Databricks缓存的通用可用性,作为统一分析平台一部分的 Databricks 运行时特性,它可以将Spark工作负载的扫描速度提升10倍,并且这种改变无需任何代码修改. 1.在本 ...
- nginx缓存静态资源,只需几个配置提升10倍页面加载速度
nginx缓存静态资源,只需几个配置提升10倍页面加载速度 首先我们看图说话 这是在没有缓存的情况下,这个页面发送了很多静态资源的请求: 1.png 可以看到,静态资源占用了整个页面加载用时的90 ...
- Web 应用性能提升 10 倍的 10 个建议
转载自http://blog.jobbole.com/94962/ 提升 Web 应用的性能变得越来越重要.线上经济活动的份额持续增长,当前发达世界中 5 % 的经济发生在互联网上(查看下面资源的统计 ...
- 使用Apache Spark 对 mysql 调优 查询速度提升10倍以上
在这篇文章中我们将讨论如何利用 Apache Spark 来提升 MySQL 的查询性能. 介绍 在我的前一篇文章Apache Spark with MySQL 中介绍了如何利用 Apache Spa ...
- 一次 Spark SQL 性能提升10倍的经历(转载)
1. 遇到了啥问题 是酱紫的,简单来说:并发执行 spark job 的时候,并发的提速很不明显. 嗯,且听我慢慢道来,啰嗦点说,类似于我们内部有一个系统给分析师用,他们写一些 sql,在我们的 sp ...
- 搜索 比MySQL快10倍?这可能是目前AWS Aurora最详解读!
作者介绍 朱阅岸,中国人民大学博士,现供职于腾讯云数据库团队.研究方向主要为数据库系统理论与实现.新硬件平台下的数据库系统以及TP+AP型混合系统. 编者按 Aurora作为AWS云上的关系数据库 ...
- openresty开发系列30--openresty中使用全局缓存
openresty开发系列30--openresty中使用全局缓存 Nginx全局内存---本地缓存 使用过如Java的朋友可能知道如Ehcache等这种进程内本地缓存.Nginx是一个Master进 ...
- [转帖]直击案发现场!TCP 10倍延迟的真相是?
直击案发现场!TCP 10倍延迟的真相是? http://zhuanlan.51cto.com/art/201911/605268.htm 内核参数调优 非常重要啊. 什么是经验?就是遇到问题,解决问 ...
- 如何把 MySQL 备份验证性能提升 10 倍
JuiceFS 非常适合用来做 MySQL 物理备份,具体使用参考我们的官方文档.最近有个客户在测试时反馈,备份验证的数据准备(xtrabackup --prepare)过程非常慢.我们借助 Juic ...
随机推荐
- 【NOI 2023 春测】 游寄
3.2 发出发通知单:9:40 3.3 旷操,把背包扔到 \(\texttt{JF}\) 底下,和 Kaguya 一起去吃早饭. 在桥下面被老班抓到了() 我用椅子给 apj 搭了一张床. Apj 给 ...
- python实现汉诺塔的图解递归算法
写在前面 工作闲来无事,看了python,写了一个汉诺塔. 还是蛮喜欢python这门语言的,很简洁. 正文 一.起源: 汉诺塔(又称河内塔)问题是源于印度一个古老传说的益智玩具.大梵天创造世界的时候 ...
- offscreenCanvas+worker+IndexedDB实现无感大量图片缓存
一个有必要实现的需求 因为项目中需要使用canvasTexture(一个threejs3d引擎中的材质类型),绘制大量的图片,每次使用都会请求大量的oss图片资源,虽然重复请求会有磁盘缓存但毕竟这个磁 ...
- 【算法】状态之美,TCP/IP状态转换探索
最近城市里甲流肆虐,口罩已经成为了出门必备的物品.小悦也不得不开始采取防护措施,上下班过程中,将口罩戴起来以保护自己不受病毒的侵害. 每天下班后,小悦总是喜欢投入到自己的兴趣爱好中,她热衷于翻阅与IT ...
- 【译】Visual Studio 2022 - 17.8 的性能改进
Visual Studio 2022 17.8版本欢迎一系列令人振奋的性能增强,包括响应式文件打开体验,改进 Razor/Blazor 的响应性,加速 F5,优化的 C++ 虚幻引擎智能感知和非 SD ...
- 聊聊分布式 SQL 数据库Doris(八)
稀疏索引 密集索引:文件中的每个搜索码值都对应一个索引值,就是叶子节点保存了整行. 稀疏索引:文件只为索引码的某些值建立索引项. 稀疏索引的创建过程包括将集合中的元素分段,并给每个分段中的最小元素创建 ...
- AntDesignBlazor示例——新建项目
本示例是AntDesign Blazor的入门示例,在学习的同时分享出来,以供新手参考. 1. 开发环境 VS2022 17.8.2 .NET8 AntDesign 0.16.2 2. 学习目标 创建 ...
- 运行tomcat之后报一个:"Address localhost:1099 is already in use"错误
一.解决方案 1.错误原因 "地址 localhost:1099 已在使用中",是1099程序被占用,把1099程序后台停止掉即可. 2.解决方案 1.快捷键win+R打开CMD运 ...
- PyTorch 实战(模型训练、模型加载、模型测试)
本次将一个使用Pytorch的一个实战项目,记录流程:自定义数据集->数据加载->搭建神经网络->迁移学习->保存模型->加载模型->测试模型 自定义数据集 参考我 ...
- Selenium浏览器属性、提取数据
浏览器属性 在使用selenium过程中,实例化driver对象后,driver对象有一些常用的属性和方法 driver.page_source 当前标签页浏览器渲染之后的网页源代码. driver. ...