
python scrapy 登录知乎过程
前面了解了scrapy框架的大概各个组件的作用,
现在要爬取知乎数据,那么第一步就是要登录!
看下知乎的登录页面发现登录主要是两大接口
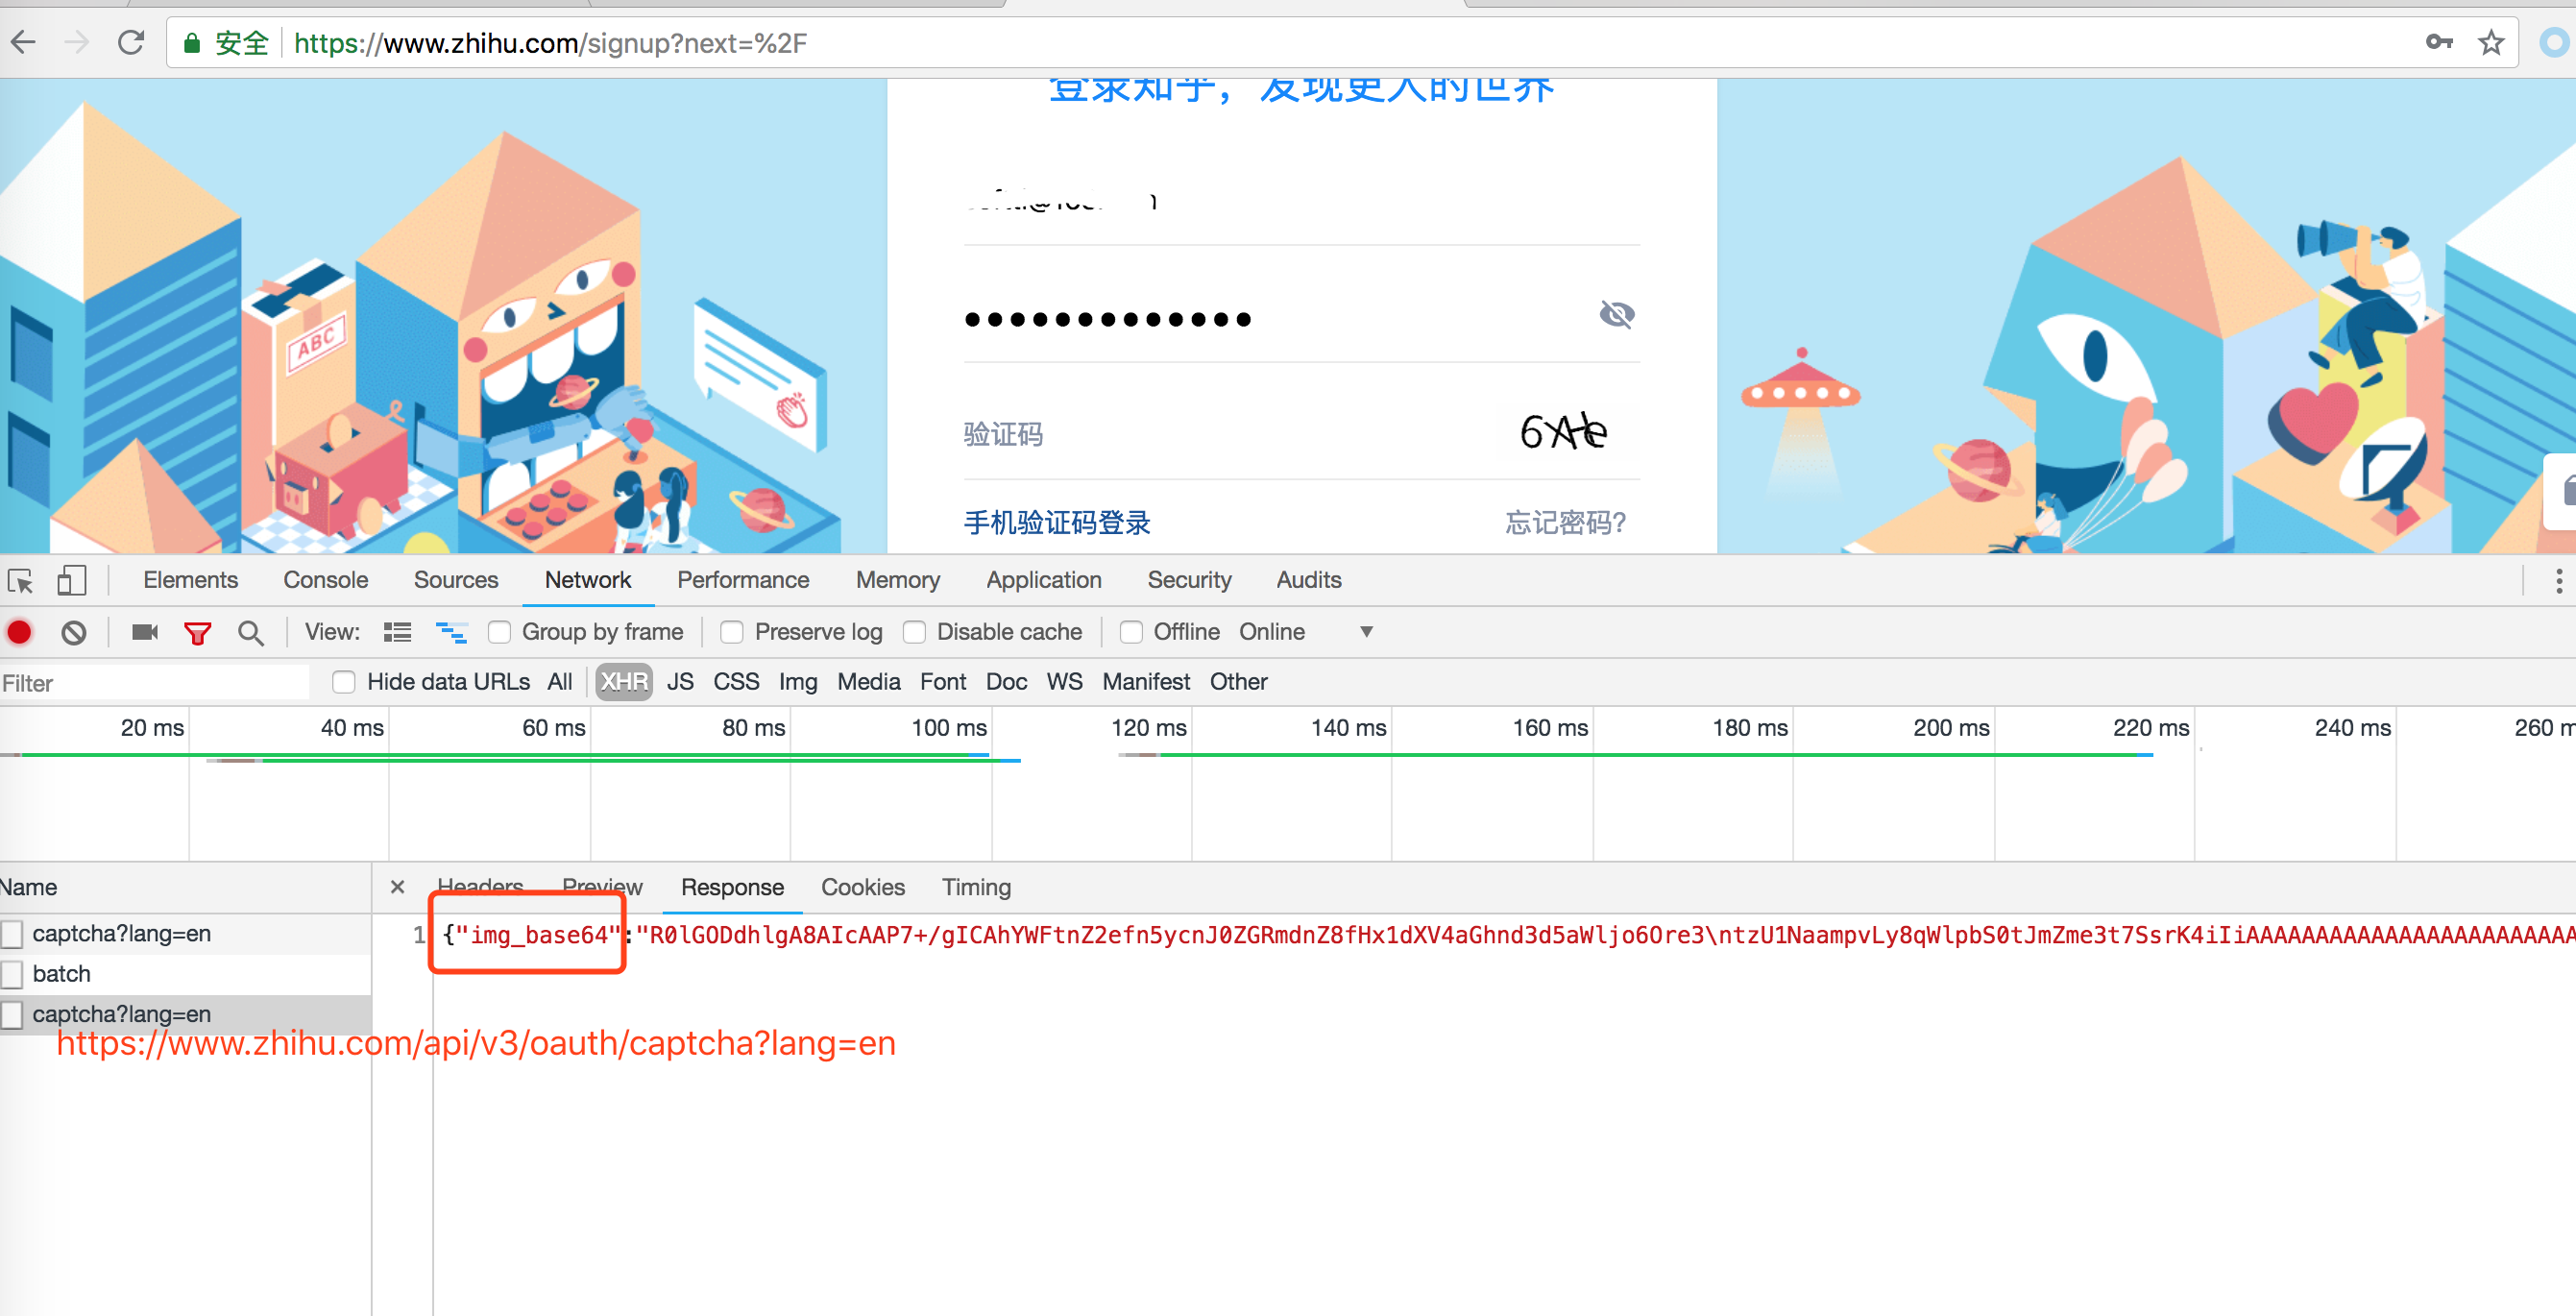
一: 登录页面地址,获取登录需要的验证码,如下图
打开知乎登录页面,需要输入用户名和密码, 还有一个验证码,
看chrome 调试工具发现验证码是这个地址返回的: https://www.zhihu.com/api/v3/oauth/captcha?lang=en
返回的结果中用base64加密了, 我们需要手动解密
二: 知乎登录接口
登录接口就是点击登录按钮访问的接口,
接口地址: https://www.zhihu.com/api/v3/oauth/sign_in
我们要做的就是封装参数,调用登录接口.

代码如下:
# -*- coding: utf-8 -*-

import hmac

import json

import scrapy

import time

import base64

from hashlib import sha1

class ZhihuLoginSpider(scrapy.Spider):

    name = 'zhihu_login'

    allowed_domains = ['www.zhihu.com']

    start_urls = ['http://www.zhihu.com/']

    agent = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36'

    # agent = 'Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/27.0.1453.94 Safari/537.36'

    headers = {

        'Connection': 'keep-alive',

        'Host': 'www.zhihu.com',

        'Referer': 'https://www.zhihu.com/signup?next=%2F',

        'User-Agent': agent,

        'authorization': 'oauth c3cef7c66a1843f8b3a9e6a1e3160e20'

    }

    grant_type = 'password'

    client_id = 'c3cef7c66a1843f8b3a9e6a1e3160e20'

    source = 'com.zhihu.web'

    timestamp = str(int(time.time() * 1000))

    timestamp2 = str(time.time() * 1000)

    print(timestamp)

    print(timestamp2)

    # 验证登录成功之后, 可以开始真正的爬取业务

    def check_login(self, response):

         # 验证是否登录成功

         text_json = json.loads(response.text)

         print(text_json)

         yield scrapy.Request('https://www.zhihu.com/inbox', headers=self.headers)

    def get_signature(self, grant_type, client_id, source, timestamp):

        """处理签名"""

        hm = hmac.new(b'd1b964811afb40118a12068ff74a12f4', None, sha1)

        hm.update(str.encode(grant_type))

        hm.update(str.encode(client_id))

        hm.update(str.encode(source))

        hm.update(str.encode(timestamp))

        return str(hm.hexdigest())

    def parse(self, response):

        print("****************")

        print(response.url)

        #print(response.body.decode("utf-8"))

    def start_requests(self):

        yield scrapy.Request('https://www.zhihu.com/api/v3/oauth/captcha?lang=en',

                             headers=self.headers, callback=self.is_need_capture)

    def is_need_capture(self, response):

        print(response.text)

        need_cap = json.loads(response.body)['show_captcha']

        print(need_cap)

        if need_cap:

            print('需要验证码')

            yield scrapy.Request(

                url='https://www.zhihu.com/api/v3/oauth/captcha?lang=en',

                headers=self.headers,

                callback=self.capture,

                method='PUT'

            )

        else:

            print('不需要验证码')

            post_url = 'https://www.zhihu.com/api/v3/oauth/sign_in'

            post_data = {

                "client_id": self.client_id,

                "username": "",  # 输入知乎用户名

                "password": "",  # 输入知乎密码

                "grant_type": self.grant_type,

                "source": self.source,

                "timestamp": self.timestamp,

                "signature": self.get_signature(self.grant_type, self.client_id, self.source, self.timestamp),  # 获取签名

                "lang": "en",

                "ref_source": "homepage",

                "captcha": '',

                "utm_source": "baidu"

            }

            yield scrapy.FormRequest(

                url=post_url,

                formdata=post_data,

                headers=self.headers,

                callback=self.check_login

            )

        # yield scrapy.Request('https://www.zhihu.com/captcha.gif?r=%d&type=login' % (time.time() * 1000),

        #                      headers=self.headers, callback=self.capture, meta={"resp": response})

        # yield scrapy.Request('https://www.zhihu.com/api/v3/oauth/captcha?lang=en',

        #                      headers=self.headers, callback=self.capture, meta={"resp": response},dont_filter=True)

    def capture(self, response):

        # print(response.body)

        try:

            img = json.loads(response.body)['img_base64']

        except ValueError:

            print('获取img_base64的值失败!')

        else:

            img = img.encode('utf8')

            img_data = base64.b64decode(img)

            with open('/var/www/html/scrapy/zh.gif', 'wb') as f:

                f.write(img_data)

                f.close()

        captcha = raw_input('请输入验证码:')

        post_data = {

            'input_text': captcha

        }

        yield scrapy.FormRequest(

            url='https://www.zhihu.com/api/v3/oauth/captcha?lang=en',

            formdata=post_data,

            callback=self.captcha_login,

            headers=self.headers

        )

    def captcha_login(self, response):

        try:

            cap_result = json.loads(response.body)['success']

            print(cap_result)

        except ValueError:

            print('关于验证码的POST请求响应失败!')

        else:

            if cap_result:

                print('验证成功!')

        post_url = 'https://www.zhihu.com/api/v3/oauth/sign_in'

        post_data = {

            "client_id": self.client_id,

            "username": "",  # 输入知乎用户名

            "password": "",  # 输入知乎密码

            "grant_type": self.grant_type,

            "source": self.source,

            "timestamp": self.timestamp,

            "signature": self.get_signature(self.grant_type, self.client_id, self.source, self.timestamp),  # 获取签名

            "lang": "en",

            "ref_source": "homepage",

            "captcha": '',

            "utm_source": ""

        }

        headers = self.headers

        headers.update({

            'Origin': 'https://www.zhihu.com',

            'Pragma': 'no - cache',

            'Cache-Control': 'no - cache'

        })

        yield scrapy.FormRequest(

            url=post_url,

            formdata=post_data,

            headers=headers,

            callback=self.check_login

        )
登录成功后调用check_login方法测试是否有登录状态.
我在后面爬取 知乎问题和答案的时候把这个方法当做start_requests方法,用来构造爬取地址.
python scrapy 登录知乎过程的更多相关文章
- Python爬虫从入门到放弃(二十四)之 Scrapy登录知乎
因为现在很多网站为了限制爬虫,设置了为只有登录才能看更多的内容,不登录只能看到部分内容,这也是一种反爬虫的手段,所以这个文章通过模拟登录知乎来作为例子,演示如何通过scrapy登录知乎 在通过scra ...
- Python之爬虫(二十六) Scrapy登录知乎
因为现在很多网站为了限制爬虫,设置了为只有登录才能看更多的内容,不登录只能看到部分内容,这也是一种反爬虫的手段,所以这个文章通过模拟登录知乎来作为例子,演示如何通过scrapy登录知乎 在通过scra ...
- 2019年最新 Python 模拟登录知乎 支持验证码
知乎的登录页面已经改版多次,加强了身份验证,网络上大部分模拟登录均已失效,所以我重写了一份完整的,并实现了提交验证码 (包括中文验证码),本文我对分析过程和代码进行步骤分解,完整的代码请见末尾 Git ...
- python模拟登录知乎
# -*- coding:utf-8 -*- import urllib import urllib2 import cookielib import sys from bs4 import Beau ...
- 教程+资源,python scrapy实战爬取知乎最性感妹子的爆照合集(12G)!
一.出发点: 之前在知乎看到一位大牛(二胖)写的一篇文章:python爬取知乎最受欢迎的妹子(大概题目是这个,具体记不清了),但是这位二胖哥没有给出源码,而我也没用过python,正好顺便学一学,所以 ...
- 2020.10.20 利用POST请求模拟登录知乎
前两天学习了Python的requests模块的相关内容,对于用GET和PSOT请求访问网页以抓取需要的内容有了初步的了解,想要再从一些复杂的网站积累些经验.最开始我采用最简单的get(url)方法想 ...
- python爬虫scrapy框架——人工识别登录知乎倒立文字验证码和数字英文验证码(2)
操作环境:python3 在上一文中python爬虫scrapy框架--人工识别知乎登录知乎倒立文字验证码和数字英文验证码(1)我们已经介绍了用Requests库来登录知乎,本文如果看不懂可以先看之前 ...
- python爬虫scrapy框架——人工识别知乎登录知乎倒立文字验证码和数字英文验证码
目前知乎使用了点击图中倒立文字的验证码: 用户需要点击图中倒立的文字才能登录. 这个给爬虫带来了一定难度,但并非无法解决,经过一天的耐心查询,终于可以人工识别验证码并达到登录成功状态,下文将和大家一一 ...
- 使用python scrapy爬取知乎提问信息
前文介绍了python的scrapy爬虫框架和登录知乎的方法. 这里介绍如何爬取知乎的问题信息,并保存到mysql数据库中. 首先,看一下我要爬取哪些内容: 如下图所示,我要爬取一个问题的6个信息: ...
随机推荐
- angular学习笔记-关于ng-class的那些事儿
在angular中为我们提供了3种方案处理class: 第一种:通过数据的双向绑定(一般是不推荐的) 注意:当它的值为一个字符串时,它就会把用空格分开的字符串加到class中(不推荐,与常用class ...
- Angular2入门:TypeScript的类型 - 对象解构
- WebForm 【Repeater】展示数据
在 Webform 数据展示中 界面层 : HTLM 业务逻辑层 :只能用 C# Repeater 重复器 能够用来循环展示数据 具有5种模板 HeaderTemplat ...
- C#中的out、ref、params详解
out参数: 如果你在一个方法中,返回多个相同类型的值的时候,可以考虑返回一个数组.但是,如果返回多个不同类型的值的时候,返回数组就不行了,那么这个时候,我们可以考虑使用out参数.out参数就侧重于 ...
- react-router与react-router-dom使用时的区别
1.React-router与React-router-dom的API对比 React-router:提供了router的核心api.如Router.Route.Switch等,但没有提供有关dom操 ...
- React Native中Mobx的使用
从今天开始我们来搞搞状态管理可否,这几天没怎么写博客,因为被病魔战胜了,tmd,突然的降温让我不知所措,大家最近注意安全,毕竟年底了,查的严,呸,大家注意保暖 特别声明:写该文只是写一下用MobX的思 ...
- 【读书笔记】iOS-Game Kit
名字虽然叫Game Kit,但是Game Kit并不是仅仅开发游戏用的,它为开发者提供了两个非常实用的功能:使用Bonjour通过蓝牙进行点对点的网络传输功能,以及应用内语音聊天功能.有意思的是,语音 ...
- vue.js及项目实战[笔记]— 01 vue.js
一. vue基础 1. 历史介绍 angular 09年,年份较早,一开始大家是拒绝的 react 2013年,用户体验较好,直接拉到一堆粉丝 vue 2014年,用户体验较好 前端框架与库的区别 j ...
- Oracle win32_11gR2_database在Win7下的安装与卸载
Oracle win32_11gR2_database在Win7下的安装与卸载 by:授客 QQ:1033553122 Oracle的硬件要求 在安装oracle之前,请检查一下自己的电脑硬件是否复合 ...
- system.img镜像转换为system.new.dat + system.transfer.list
android 8.1上面验证,支持所有的android版本,直接放到sdk中执行即可. img2sdat.py #!/usr/bin/env python #coding=utf-8 imp ...