
Spark是一种分布式的计算方案
Spark的安装基于HDFS,所以我们要设置hadoop的配置文件,所以spark的存储不是其主要的功能点,而spark作为分布式生态中的角色是一种计算模式(其他 的计算
模式,比如MR,Storm,spark,tez)。
vim spark-env.sh
export SCALA_HOME=/path/to/scala-2.10.4
export JAVA_HOME=/usr/java/jdk
export HADOOP_HOME=/usr/local/hadoop-2.7.0
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export SPARK_WORKER_MEMORY=7g
export SPARK_MASTER_IP=172.16.0.140
export MASTER=spark://172.16.0.140:7077
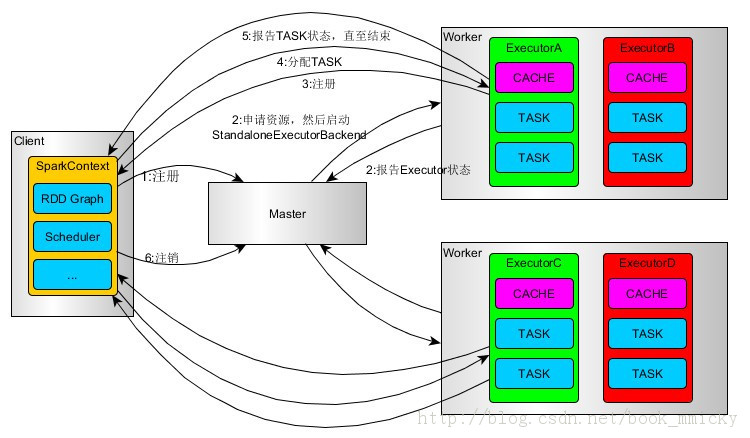
一端是构建driver,另一端就是excutor运行,而mater主要就是完成driver的调度。
运行模式:client cluster 模式
client模式: sparkContext、Driver在客户端构建
clust模式:sparkContext、Driver在不在客户端构建。
DAGScheduler与TaskScheduler全部在Driver端构建完成、最后讲Task调度到不同的Work上运行

===========================================================================
1.RDD类似于数据库中的视图,缓存RDD类似于物化视图,数据库像DSM系统一样,允许典型地读写所有记录,通过记录操作和数据的日志来实现容错,还需要花费额外的开销来维护一致性。RDD编程模型通过增加更多限制来避免这些开销。
2.RDD借鉴了DryadLINQ、Pig和FlumeJava的“并行收集”编程模型,通过允许用户显式地将未序列化的对象保存在内存中,以此来控制分区和基于key随机查找,从而有效地支持基于工作集的应用。RDD保留了那些数据流系统更高级别的编程特性,这对那些开发人员来说也比较熟悉,而且,RDD也能够支持更多类型的应用。
3.DSM通过检查点[19]实现容错,而Spark使用Lineage重建RDD分区,这些分区可以在不同的节点上重新并行处理,而不需要将整个程序回退到检查点再重新运行。RDD能够像MapReduce一样将计算推向数据[12],并通过推测执行来解决某些任务计算进度落后的问题,推测执行在一般的DSM系统上是很难实现的。
Spark是一种分布式的计算方案的更多相关文章
- 分布式ID详解(5种分布式ID生成方案)
分布式架构会涉及到分布式全局唯一ID的生成,今天我就来详解分布式全局唯一ID,以及分布式全局唯一ID的实现方案@mikechen 什么是分布式系统唯一ID 在复杂分布式系统中,往往需要对大量的数据和消 ...
- Apache Spark支持三种分布式部署方式 standalone、spark on mesos和 spark on YARN区别
链接地址: http://dongxicheng.org/framework-on-yarn/apache-spark-comparing-three-deploying-ways/ Spark On ...
- Apache Spark探秘:三种分布式部署方式比较
转自:链接地址: http://dongxicheng.org/framework-on-yarn/apache-spark-comparing-three-deploying-ways/ 目 ...
- 分库分表的 9种分布式主键ID 生成方案,挺全乎的
<sharding-jdbc 分库分表的 4种分片策略> 中我们介绍了 sharding-jdbc 4种分片策略的使用场景,可以满足基础的分片功能开发,这篇我们来看看分库分表后,应该如何为 ...
- 分布式id生成方案总结
本文已经收录自 JavaGuide (60k+ Star[Java学习+面试指南] 一份涵盖大部分Java程序员所需要掌握的核心知识.) 本文授权转载自:https://juejin.im/post/ ...
- 明风:分布式图计算的平台Spark GraphX 在淘宝的实践
快刀初试:Spark GraphX在淘宝的实践 作者:明风 (本文由团队中梧苇和我一起撰写,并由团队中的林岳,岩岫,世仪等多人Review,发表于程序员的8月刊,由于篇幅原因,略作删减,本文为完整版) ...
- Hive数据分析——Spark是一种基于rdd(弹性数据集)的内存分布式并行处理框架,比于Hadoop将大量的中间结果写入HDFS,Spark避免了中间结果的持久化
转自:http://blog.csdn.net/wh_springer/article/details/51842496 近十年来,随着Hadoop生态系统的不断完善,Hadoop早已成为大数据事实上 ...
- 一种基于Orleans的分布式Id生成方案
基于Orleans的分布式Id生成方案,因Orleans的单实例.单线程模型,让这种实现变的简单,贴出一种实现,欢迎大家提出意见 public interface ISequenceNoGenerat ...
- 分析 5种分布式事务方案,还是选了阿里的 Seata(原理 + 实战)
好长时间没发文了,最近着实是有点忙,当爹的第 43 天,身心疲惫.这又赶上年底,公司冲 KPI 强制技术部加班到十点,晚上孩子隔两三个小时一醒,基本没睡囫囵觉的机会,天天处于迷糊的状态,孩子还时不时起 ...
随机推荐
- ORACLE 常用日期函数
1 . add_months(arg1,num) 返回日期arg1加num个月的新日期. select add_months(date'2011-1-1',1) from dual; result: ...
- CSS控制checkbox样式
原文地址:http://www.xiumu.org/technology/style-checkboxes-with-css.shtml#comments Checkbox复选框是一个可能每一个网站都 ...
- vs2010 release 模式加了断点,跑代码无法跟踪,解决方法
纯跑代码,不是附加进程调试. 打开不能调试的类库项目属性页面→切换到生成选项卡→点击高级按钮→将调试信息一项设置 将“调试信息”设置为“pdb-only”. 我是按图上的设置就正常了. -- 201 ...
- lwip初始化过程
首先应该看下源码包中的doc/rawapi.txt,这篇文档中介绍了初始化流程. 初始化过程的前半部分主要针对lwip的内存管理和各个协议层,在src/core/init.c中有一个lwip_init ...
- Python 定制类与其对象的创建和应用
1.创建新类Athlete,创建两个唯一的对象实例sarah james,他们会继承Athlete类的特性 >>> class Athlete: def __init__(self, ...
- h264 流、帧结构
H264元素的分层结构 H.264编码器输出的Bit流中,每个Bit都隶属于某个句法元素.句法元素被组织成有层次的结构,分别描述各个层次的信息. 在H.264 中,句法元素共被组织成 序列.图像.片 ...
- android 开源项目一览
直接拿来用!最火的Android开源项目(一) http://www.csdn.net/article/2013-05-03/2815127-Android-open-source-projects ...
- 黄聪:Discuz!X3.2 如何配置超级版主或者某些管理员,允许管理用户组或者权限
点击后台-->站长-->后台管理团队-->新增用户(用户名)用户管理员即可
- 黄聪:VPS实现自动定时备份网站数据以及Mysql数据库到百度云同步盘
建站多了,备份成了头疼的问题,因为你不知道你的VPS什么时候会宕机或者服务商跑路,一旦网站数据丢失,那么相当于前功尽弃了,所以自己研究出了一套自动备份的方法. 需要的东西: 1.一个VPS(虚拟空间没 ...
- PLSQL_数据泵定参数批量导入多表Expdp/Impdp Parfile(案例)
2015-04-01 Created By BaoXinjian