
如何在Ubuntu的idea上运行Hadoop程序
如何在Ubuntu的idea上运行Hadoop程序
一、前言
在idea上运行Hadoop程序,需要使用Hadoop的相关库,Ubuntu为Hadoop的运行提供了良好的支持。
二、操作方法
首先我们需要创建一个maven项目,然后在pom.xml中进行设置,导入必要的包,最后写出mapreduce程序即可。
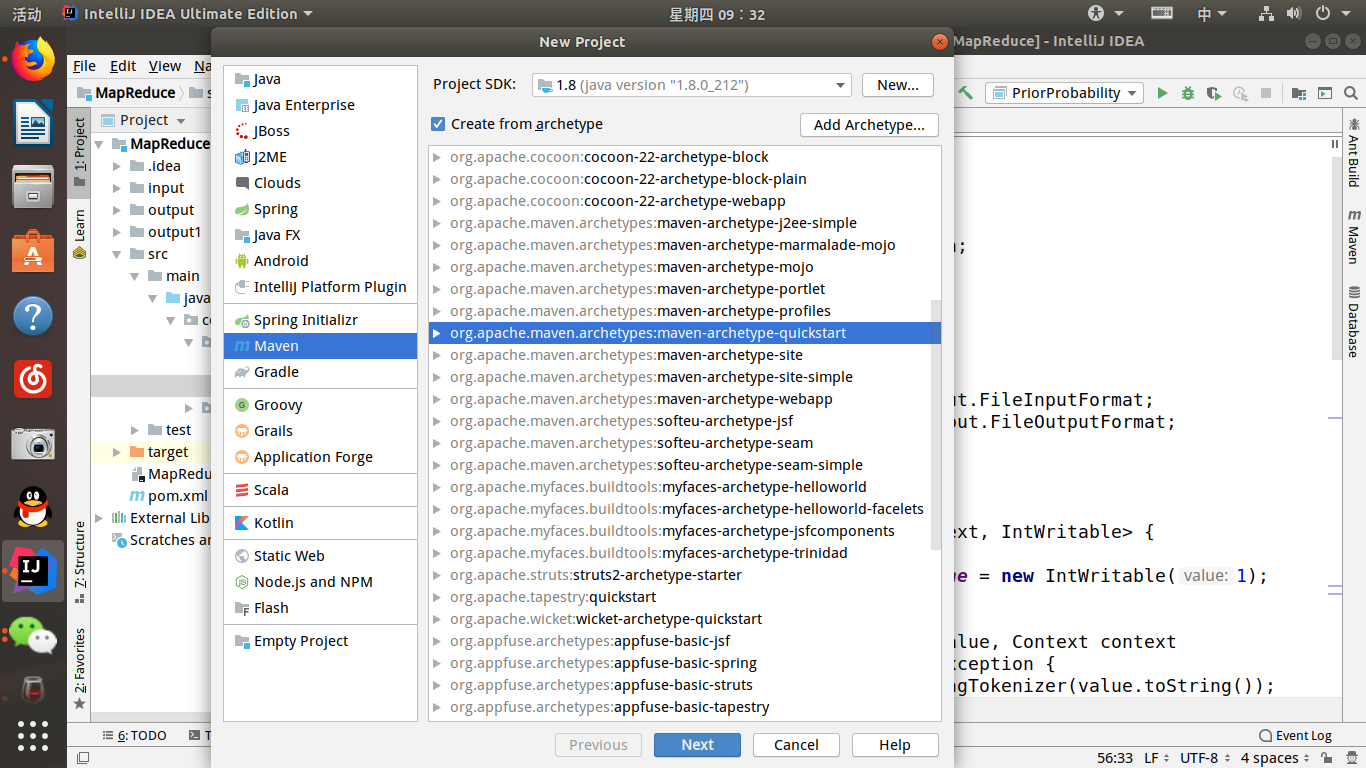
其中pom.xml文件如下:
 <?xml version="1.0" encoding="UTF-8"?>

 <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

   xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

   <modelVersion>4.0.0</modelVersion>

   <groupId>com.zyr.bigdata</groupId>

   <artifactId>MapReduce</artifactId>

   <version>1.0-SNAPSHOT</version>

   <name>MapReduce</name>

   <!-- FIXME change it to the project's website -->

   <url>http://www.example.com</url>

   <properties>

     <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>

     <maven.compiler.source>1.7</maven.compiler.source>

     <maven.compiler.target>1.7</maven.compiler.target>

   </properties>

   <dependencies>

     <dependency>

       <groupId>junit</groupId>

       <artifactId>junit</artifactId>

       <version>4.11</version>

       <scope>test</scope>

     </dependency>

       <dependency>

         <groupId>org.apache.hadoop</groupId>

         <artifactId>hadoop-core</artifactId>

         <version>1.2.1</version>

       </dependency>

       <dependency>

         <groupId>org.apache.hadoop</groupId>

         <artifactId>hadoop-common</artifactId>

         <version>2.9.0</version>

       </dependency>

   </dependencies>

   <build>

     <pluginManagement><!-- lock down plugins versions to avoid using Maven defaults (may be moved to parent pom) -->

       <plugins>

         <!-- clean lifecycle, see https://maven.apache.org/ref/current/maven-core/lifecycles.html#clean_Lifecycle -->

         <plugin>

           <artifactId>maven-clean-plugin</artifactId>

           <version>3.1.0</version>

         </plugin>

         <!-- default lifecycle, jar packaging: see https://maven.apache.org/ref/current/maven-core/default-bindings.html#Plugin_bindings_for_jar_packaging -->

         <plugin>

           <artifactId>maven-resources-plugin</artifactId>

           <version>3.0.2</version>

         </plugin>

         <plugin>

           <artifactId>maven-compiler-plugin</artifactId>

           <version>3.8.0</version>

         </plugin>

         <plugin>

           <artifactId>maven-surefire-plugin</artifactId>

           <version>2.22.1</version>

         </plugin>

         <plugin>

           <artifactId>maven-jar-plugin</artifactId>

           <version>3.0.2</version>

         </plugin>

         <plugin>

           <artifactId>maven-install-plugin</artifactId>

           <version>2.5.2</version>

         </plugin>

         <plugin>

           <artifactId>maven-deploy-plugin</artifactId>

           <version>2.8.2</version>

         </plugin>

         <!-- site lifecycle, see https://maven.apache.org/ref/current/maven-core/lifecycles.html#site_Lifecycle -->

         <plugin>

           <artifactId>maven-site-plugin</artifactId>

           <version>3.7.1</version>

         </plugin>

         <plugin>

           <artifactId>maven-project-info-reports-plugin</artifactId>

           <version>3.0.0</version>

         </plugin>

       </plugins>

     </pluginManagement>

   </build>

 </project>
然后是编写代码:
package com.zyr.bigdata;

import java.io.IOException;

import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WordCount {

    public static class TokenizerMapper

            extends Mapper<Object, Text, Text, IntWritable> {

        private final static IntWritable one = new IntWritable(1);

        private Text word = new Text();

        public void map(Object key, Text value, Context context

        ) throws IOException, InterruptedException {

            StringTokenizer itr = new StringTokenizer(value.toString());

            while (itr.hasMoreTokens()) {

                word.set(itr.nextToken());

                context.write(word, one);

            }

        }

    }

    public static class IntSumReducer

            extends Reducer<Text, IntWritable, Text, IntWritable> {

        private IntWritable result = new IntWritable();

        public void reduce(Text key, Iterable<IntWritable> values,

                           Context context

        ) throws IOException, InterruptedException {

            int sum = 0;

            for (IntWritable val : values) {

                sum += val.get();

            }

            result.set(sum);

            context.write(key, result);

        }

    }

    public static void main(String[] args) throws Exception {

        Configuration conf = new Configuration();

        Job job = Job.getInstance(conf, "word count");

        job.setJarByClass(WordCount.class);

        job.setMapperClass(TokenizerMapper.class);

        job.setCombinerClass(IntSumReducer.class);

        job.setReducerClass(IntSumReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        FileInputFormat.addInputPath(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        System.exit(job.waitForCompletion(true) ? 0 : 1);

    }

}
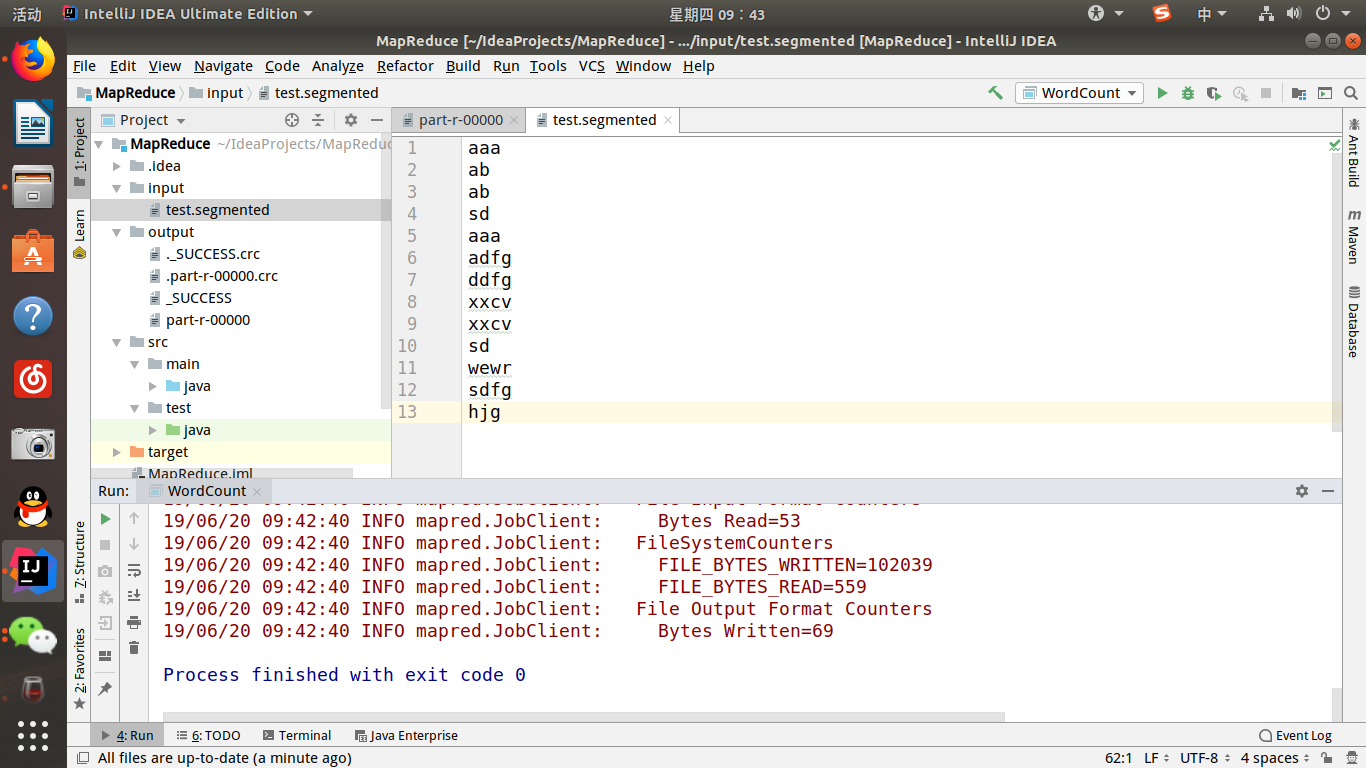
因为是mapreduce的词频统计,因此需要读入文件,在src同级创建input文件夹,里面放入文档即可。
最后需要配置执行程序的设置(在run->edit configure中新建application即可):
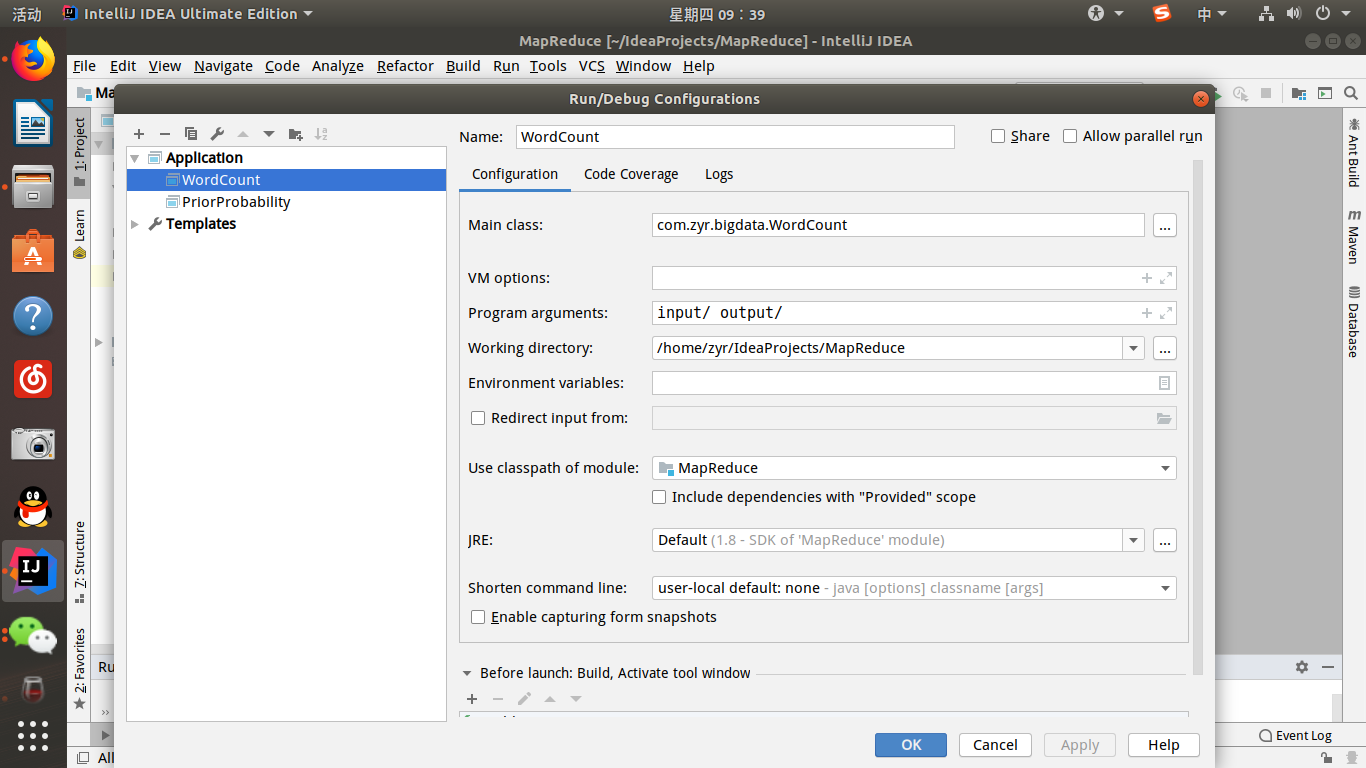
然后运行程序,会生成相应的output文件夹,打开即可查看结果。 
至此,最简单的mapreduce程序就完成了,需要注意的是使用maven我们没有在ubuntu上安装相应的Hadoop,因为这是最简单的单机环境,使用的是本地文件系统,但是如果使用分布式的时候就必须需要本地安装Hadoop来提供访问服务了。
如何在Ubuntu的idea上运行Hadoop程序的更多相关文章
- 关于在Eclipse上运行Hadoop程序的日志输出问题
在安装由Eclipse-Hadoop-Plugin的Eclipse中, 可以直接运行Hadoop的MapReduce程序, 但是如果什么都不配置的话你发现Eclipse控制台没有任何日志输出, 这个问 ...
- Ubuntu中使用终端运行Hadoop程序
接上一篇<Ubuntu Kylin系统下安装Hadoop2.6.0> 通过上一篇,Hadoop伪分布式基本配好了. 下一步是运行一个MapReduce程序,以WordCount为例: 1. ...
- Ubuntu下Eclipse中运行Hadoop程序的参数问题
需要统一的参数: 当配置好eclipse中hadoop的程序后,几个参数需要统一一下: hadoop安装目录下/etc/core_site.xml中 fs.default.name的端口号一定要与ha ...
- Ubuntu 12.04上安装Hadoop并运行
Ubuntu 12.04上安装Hadoop并运行 作者:凯鲁嘎吉 - 博客园 http://www.cnblogs.com/kailugaji/ 在官网上下载好四个文件 在Ubuntu的/home/w ...
- 如何在Ubuntu 18.04上安装Pip
一.简介: Pip是一个软件包管理系统,它简化了用Python编写的软件包(如Python包索引(PyPI)中的软件包)的安装和管理. 在Ubuntu 18.04上缺省没有安装Pip,但安装非常简单. ...
- 转载:如何在Ubuntu 18.04上使用UFW设置防火墙
https://blog.csdn.net/u013068789/article/details/82051943 介绍 UFW或Uncomplicated Firewall是iptables一个接口 ...
- 如何在Ubuntu 18.04上安装Django
Django是一个免费的开源高级Python Web框架,旨在帮助开发人员构建安全,可扩展和可维护的Web应用程序. 根据您的需要,有不同的方法来安装Django.它可以使用pip在系统范围内安装或在 ...
- 如何在Ubuntu 16.04上安装配置Redis
如何在Ubuntu 16.04上安装配置Redis Redis是一个内存中的键值存储,以其灵活性,性能和广泛的语言支持而闻名.在本指南中,我们将演示如何在Ubuntu 16.04服务器上安装和配置Re ...
- 如何在Ubuntu 18.04上安装和配置Apache 2 Web服务器(转)
如何在Ubuntu 18.04上安装和配置Apache 2 Web服务器 什么是Apache Web Server? Apache或Apache HTTP服务器是一个免费的开源Web服务器,由Apac ...
随机推荐
- Python开发GUI实战:图片转换素描画工具!
奋斗没有终点 好好学习72变,因为将来 没有人能替你阻挡81难 . 生如蝼蚁,当有鸿鹄之志: 命如纸薄,应有不屈之心 . 今天被这句话触动了,所以开篇分享给大家.鸡汤有毒,但有时大家却靠它激励自己 ...
- Python代码报错看不懂?记住这20个报错提示单词轻松解决bug
1. syntaxerror: invalid syntax语法错误:无效语法 1) syntax [ˈsɪntæks] 语法.句法 2) error [ˈerər] 错误 3) invalid [ɪ ...
- IT兄弟连 Java语法教程 数组 数组的声明
Java语言支持两种语法格式来定义数组: type[] arrayName; type arrayName[]; 对这两种语法格式而言,通常推荐使用第一种格式,因为第一种格式不仅具有更好的语义,而且具 ...
- ARM64 的 memcpy 优化与实现
参考:https://www.byteisland.com/arm64-%E7%9A%84-memcpy-%E6%B1%87%E7%BC%96%E5%88%86%E6%9E%90/ libc/stri ...
- 关于 ASP.NET Core 中的 RazorPages
Contact.cshtml @page @model ContactModel @{ ViewData["Title"] = "Contact"; } < ...
- python基础(22):模块、包
1. 模块 1.1 什么是模块 别人写好的函数.变量.方法放在一个文件里 (这个文件可以被我们直接使用)这个文件就是个模块 常见的场景:一个模块就是一个包含了python定义和声明的文件,文件名就是模 ...
- SpringBoot(七) SpringBoot整合Log4j
第一种打印debug日志方式: logging.level.com.demo.mapper: debug 第二种打印debug日志方式: 在resource文件夹下新建:logback.xml < ...
- 证书锁定SSL/TLS Pinning
前言 APP端抓包中, 设置抓包代理后会发现部分APP(如app store.Facebook)直接无法访问,其他部分app又功能正常,为什么呢?这涉及 ssl-pinning,证书锁定. 证书锁定( ...
- Pi Network有梦想是好的,最新消息和下载注册流程。
(注册流程最下面) ---------------------------------------------------------------------------------- 今日更新(10 ...
- 【Gradle】Gradle入门
Gradle入门 配置Gradle环境 安装之前确保已经安装配置好Java环境,要求JDK6以上,并且在环境变量里配置了JAVA_HOME,查看Java版本可以在终端输入如下命令: java -ver ...