
MapReduce过程<原创>
一、预处理阶段
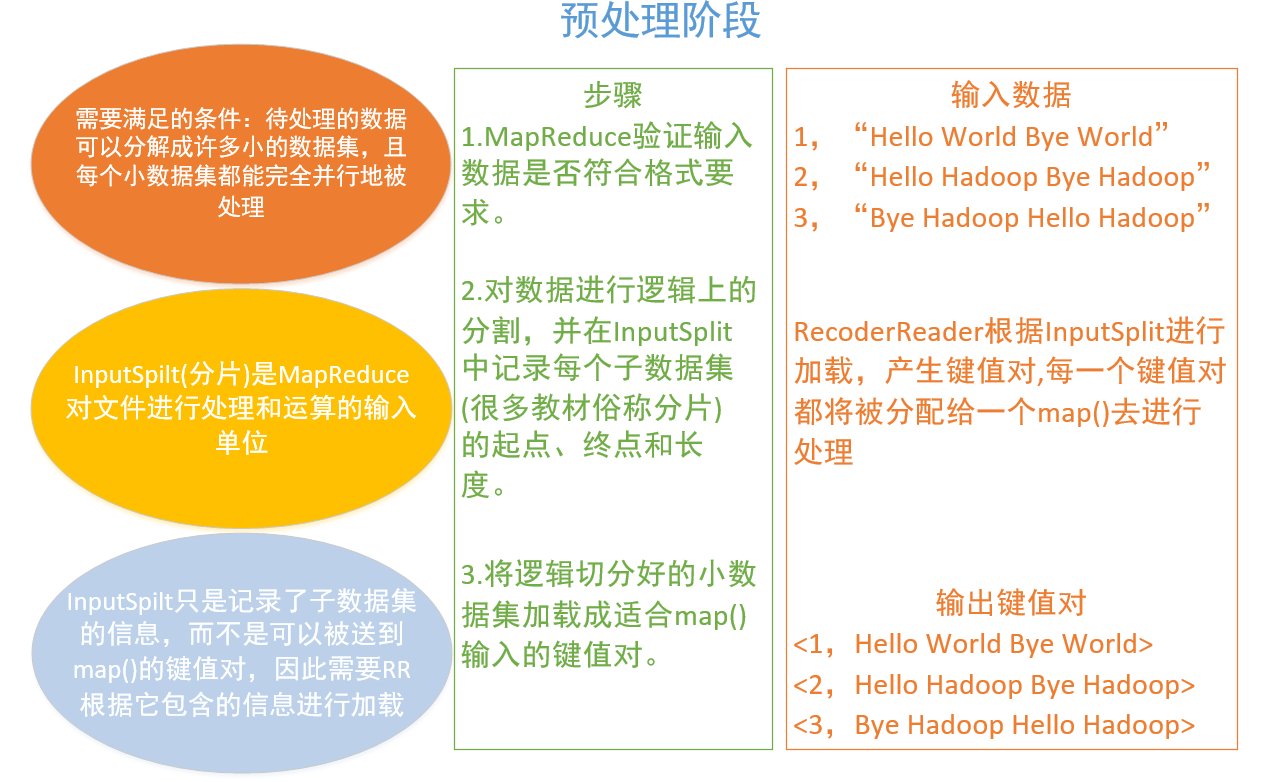
二、Map阶段
一个Map任务被JobTracker(管家)分配到多个TaskTracker(弟弟)执行,如下图所示,弟弟的map()只负责拆分,虽然map()输出两个相同的键值对,但它并不会对两个重复的键值对进行合并,而且输出的键值对也是无序的,没有按照字母顺序排列。而这些工作都会交给Shuffle(洗牌)阶段去做。

三、Shuffle阶段
Shuffle阶段实际上并不是一个和Map阶段和Reduce阶段独立的阶段,实际上它分为Map端的Shuffle阶段和Reduce端的阶段,为了方便讨论,就把这个两个子阶段放在一起讨论,统称为Shuffle阶段。
(一)Map端的Shuffle阶段
每个map()任务都会被分配一块缓存,对于每个map()的输出数据,不是直接写入磁盘,而是先写入缓存里,当缓存达到一定比例时对它进行溢写操作,将溢写好的数据进行归并(、合并)发送到本地磁盘,并清空该数据占用的缓存,还在执行的map()们可以继续不停地将结果写入缓存。之所以这样设计,是为了减少I/O消耗,节省了时间。
溢写,包括分区(Partiyion)、排序(Sort)、合并(Combine)。溢写过程,是在缓存中完成的。
看过巨佬的博客之后对错误的理解进行了更正:每个分区含有多个不同key值的键值对,而不是一个分区只含有一种key值对应的多个键值对。举例:
1分区: < Hello ,1> <Hello ,1 > <Hadoop ,1 > , 2分区:<World ,1 > <World ,1>
即key值为Hello的键值对全部被分到1分区,其他分区不会存在key值为Hello的键值对,而1分区除了Hello还有多个其他的key值的键值对存在。
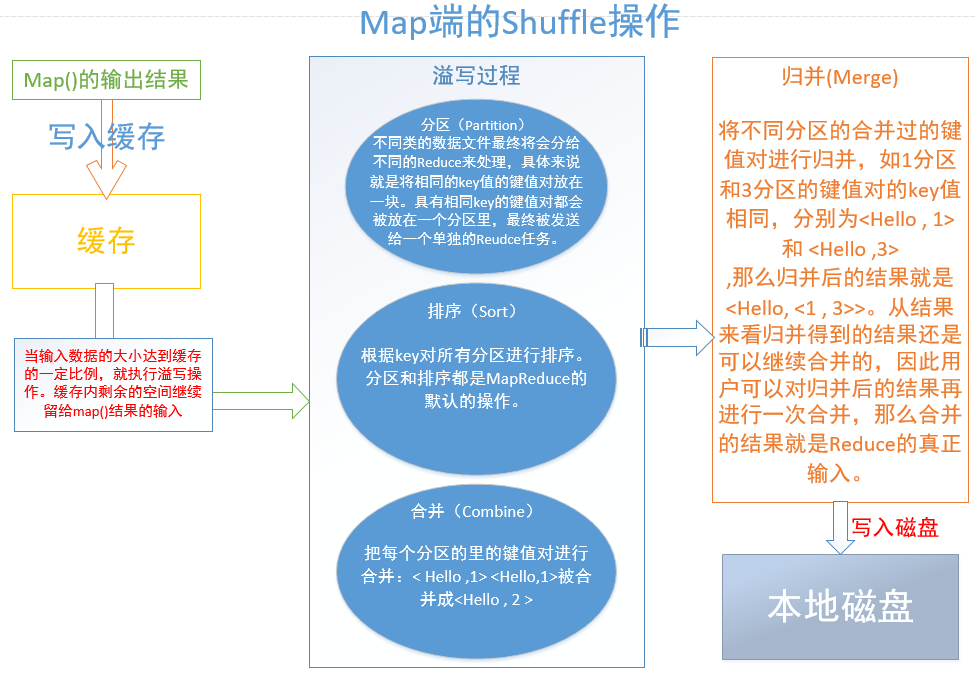
合并(Combine)与归并(Merge)的区别:
合并是针对每个分区内部的键值对的操作,而归并是针对磁盘中的多个溢写文件的操作,将多个溢写文件归并成一个大的溢写文件。
对于两个键值对< a ,1 >和< a ,1>,合并的结果是 <a , 2 >:合并实际上就是在map端执行reduce的操作,是为了减少网络传输开销,但是并不是所有的情况都能使用合并操作,可通过调用job.setCombinerClass(MyReduce.class)设置这一操作;
而归并的结果是<a,<1,1>>,合并是不是默认MapReduce的默认操作,归并是默认操作。归并的结果是可以继续合并再作为最终结果发送到本地磁盘作为Reduce的输入的。
(二)Reduce端的Shuffle阶段
1.领取数据
Map端的Shuffle阶段将合并或归并好的数据发送到本地磁盘里。在Map任务开始后,Reduce会不断的通过RPC通信协议来询问JobTracker(管家),Map任务是否已经完成。JobTracker检测到一个Map任务完成后会通知相关的Reduce来领取属于自己的数据。一般系统中会存在多个Map机器,Reduce需要使用多线程同时从多个Map机器领取数据。
2.归并、输出
尽管每个map()都在之前进行过合并、归并处理,但当Reduce从多个Map机器中领取回数据后,Reduce机器的缓冲中又存在着相同的可以合并的键值对、具有相同key值的键值对也会被归并。在这个阶段,合并也不是默认的,需要用户自定义。和Map端的Shuffle阶段不同的是,当前阶段生成多个文件发送给Reduce阶段。
三、Reduce阶段
对不同分区的相同key对应的值进行相加,输出最后的结果。并写入到HDFS系统中,也就是写入磁盘。
一定要看:
巨佬博客(一看就懂系列):https://www.cnblogs.com/npumenglei/p/3631244.html
MapReduce过程<原创>的更多相关文章
- MapReduce过程(包括Shuffle)详解
首先,map的输入数据默认一个一个的键值对,键就是每一行首字母的偏移量,值就是每一行的值了. 然后每一个输入的键值对都会用我们定义的map函数去处理,这里用wordcount来举例的话就是,每一个键值 ...
- MapReduce过程详解(基于hadoop2.x架构)
本文基于hadoop2.x架构详细描述了mapreduce的执行过程,包括partition,combiner,shuffle等组件以及yarn平台与mapreduce编程模型的关系. mapredu ...
- Hadoop - MapReduce 过程
Hadoop - MapReduce 一.MapReduce设计理念 map--->映射 reduce--->归纳 mapreduce必须构建在hdfs之上的一种大数据离线计算框架 在线: ...
- MapReduce 过程详解
Hadoop 越来越火, 围绕Hadoop的子项目更是增长迅速, 光Apache官网上列出来的就十几个, 但是万变不离其宗, 大部分项目都是基于Hadoop common MapReduce 更是核心 ...
- WordCount示例深度学习MapReduce过程(1)
我们都安装完Hadoop之后,按照一些案例先要跑一个WourdCount程序,来测试Hadoop安装是否成功.在终端中用命令创建一个文件夹,简单的向两个文件中各写入一段话,然后运行Hadoop,Wou ...
- 关于mapreduce过程中出现的错误:Too many fetch-failures
Reduce task启动后第一个阶段是shuffle,即向map端fetch数据.每次fetch都可能因为connect超时,read超时,checksum错误等原因而失败.Reduce task为 ...
- hadoop的mapreduce过程
http://www.cnblogs.com/sharpxiajun/p/3151395.html 下面我从逻辑实体的角度讲解mapreduce运行机制,这些按照时间顺序包括:输入分片(input s ...
- MapReduce过程详解及其性能优化
http://blog.csdn.net/aijiudu/article/details/72353510 废话不说直接来一张图如下: 从JVM的角度看Map和Reduce Map阶段包括: 第一读数 ...
- WordCount示例深度学习MapReduce过程
转自: http://blog.csdn.net/yczws1/article/details/21794873 . 我们都安装完Hadoop之后,按照一些案例先要跑一个WourdCount程序,来测 ...
随机推荐
- June 18. 2018, Week 25th. Monday
Health and cheerfulness naturally beget each other. 安康喜乐,相生相成. From Joseph Addison. Good health is a ...
- Linux for Python教程01
目录 1. Linux和操作系统 1.1. 什么是操作系统 1.2. 现有操作系统 1.3. Linux用户目录 1.4. Linux文件权限 2. Linux命令 2.1 文件管理相关 (1).ls ...
- Python爬虫-01:爬虫的概念及分类
目录 # 1. 为什么要爬虫? 2. 什么是爬虫? 3. 爬虫如何抓取网页数据? # 4. Python爬虫的优势? 5. 学习路线 6. 爬虫的分类 6.1 通用爬虫: 6.2 聚焦爬虫: # 1. ...
- 《软工实践》第零次作业 - 一些QA
<软工实践>第零次作业 - 一些QA Q&A (1)回想一下你初入大学时对计算机专业的畅想 当初你是如何做出选择计算机专业的决定的? 你认为过去两年中接触到的课程是否符合你对计算机 ...
- 转:Java中的String,StringBuilder,StringBuffer三者的区别
最近在学习Java的时候,遇到了这样一个问题,就是String,StringBuilder以及StringBuffer这三个类之间有什么区别呢,自己从网上搜索了一些资料,有所了解了之后在这里整理一下, ...
- JavaScript的内置对象(Global对象)
内置对象的定义 由 javaScript 实现提供的.不用自己创建,这些对象在 ECMAScript 程序执行之前就已经存在了. 意思就是说,开发人员不必显示地实例化内置对象:因为它们已经实例化了. ...
- 设计模式のCompositePattern(组合模式)----结构模式
一.产生背景 又叫部分整体模式,是用于把一组相似的对象当作一个单一的对象.组合模式依据树形结构来组合对象,用来表示部分以及整体层次.这种类型的设计模式属于结构型模式,它创建了对象组的树形结构. 这种模 ...
- 解决VS Code使用code runner开发Python乱码问题
微软开发的VS Code是一个跨平台的文本编辑器,通过各种插件,可以把自己武装成无所不能的IDE. 刚刚安装完VS Code时,迫不急待地安装了C/C++.Python以及Code Runner插件, ...
- spring boot 注解方式 idea报could not autowire
File-Project Structure 页面 Facets下删掉 Spring(直接右键Delete) 这个解答是对的.并不会降低安全性!!因为创建项目的时候,都是先创建空项目再创建web mo ...
- vue组件详解——组件通信
每天学习一点点 编程PDF电子书.视频教程免费下载:http://www.shitanlife.com/code 组件之间通信可以用下图表示: 组件关系可分为父子组件通信.兄弟组件通信.跨级组件通信. ...