
HBase预分区方法
(what)什么是预分区?
HBase表在刚刚被创建时,只有1个分区(region),当一个region过大(达到hbase.hregion.max.filesize属性中定义的阈值,默认10GB)时,
表将会进行split,分裂为2个分区。表在进行split的时候,会耗费大量的资源,频繁的分区对HBase的性能有巨大的影响。
HBase提供了预分区功能,即用户可以在创建表的时候对表按照一定的规则分区。
(why)预分区的目的是什么?
减少由于region split带来的资源消耗。从而提高HBase的性能。
(how)如何预分区?
===方法1===
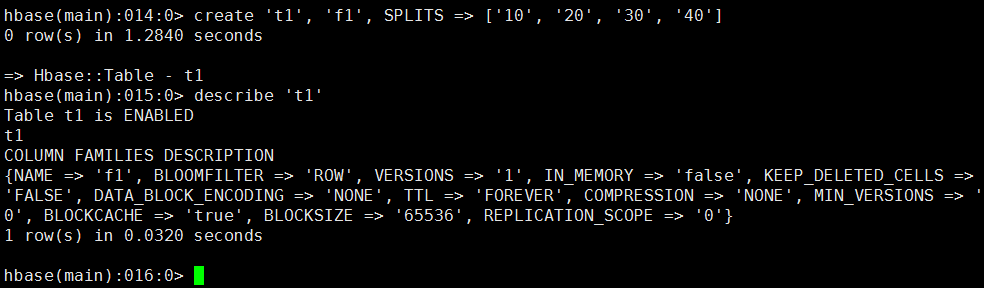
通过HBase shell来创建。命令样例如下:
create 't1', 'f1', SPLITS => ['10', '20', '30', '40']
create 't1', {NAME =>'f1', TTL => 180}, SPLITS => ['10', '20', '30', '40']
create 't1', {NAME =>'f1', TTL => 180}, {NAME => 'f2', TTL => 240}, SPLITS => ['10', '20', '30', '40']
命令截图:
从Web界面查看表结构

===方法2===
仍然是通过HBase shell来创建,不过是通过读取文件
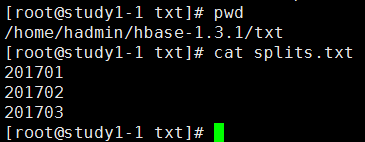
1、在任意路径下创建一个保存分区key的文件,我这里如下
路径:/home/hadmin/hbase-1.3.1/txt/splits.txt
内容如下图
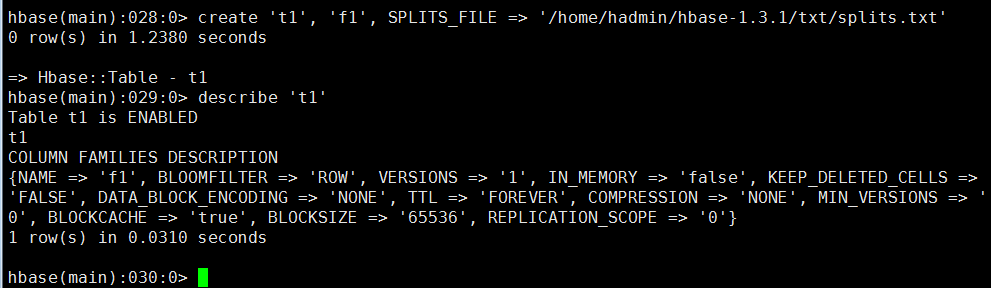
2、通过HBase shell命令创建表
命令样例:
create 't1', 'f1', SPLITS_FILE => '/home/hadmin/hbase-1.3.1/txt/splits.txt'
create 't1', {NAME =>'f1', TTL => 180}, SPLITS_FILE => '/home/hadmin/hbase-1.3.1/txt/splits.txt'
create 't1', {NAME =>'f1', TTL => 180}, {NAME => 'f2', TTL => 240}, SPLITS_FILE => '/home/hadmin/hbase-1.3.1/txt/splits.txt'
操作截图:
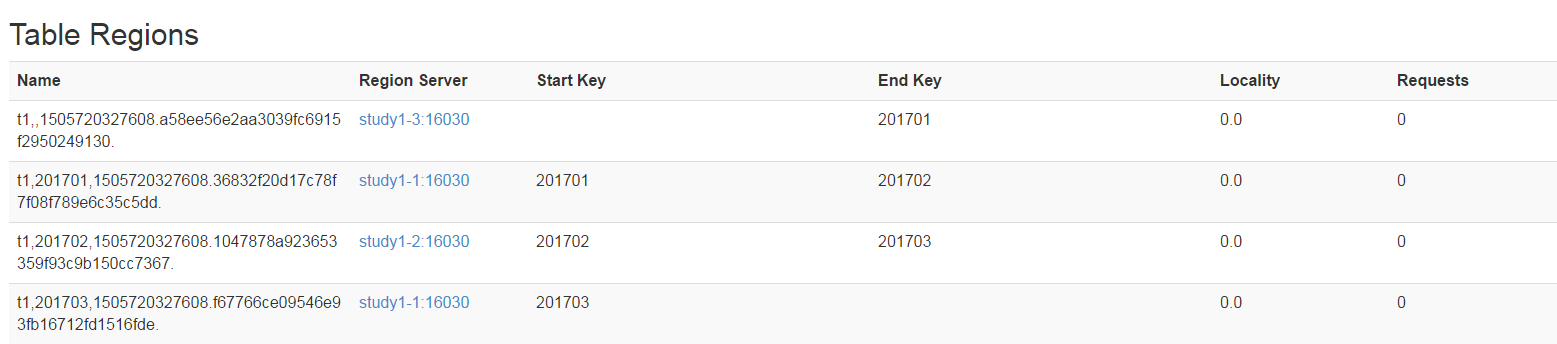
Web界面结果:
====方法3==
通过java api创建,代码样例如下:
package api;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.hbase.HBaseConfiguration;

import org.apache.hadoop.hbase.HColumnDescriptor;

import org.apache.hadoop.hbase.HTableDescriptor;

import org.apache.hadoop.hbase.TableName;

import org.apache.hadoop.hbase.client.Admin;

import org.apache.hadoop.hbase.client.Connection;

import org.apache.hadoop.hbase.client.ConnectionFactory;

import org.apache.hadoop.hbase.util.Bytes;

public class create_table_sample2 {

    public static void main(String[] args) throws Exception {

        Configuration conf = HBaseConfiguration.create();

        conf.set("hbase.zookeeper.quorum", "192.168.1.80,192.168.1.81,192.168.1.82");

        Connection connection = ConnectionFactory.createConnection(conf);

        Admin admin = connection.getAdmin();

        TableName table_name = TableName.valueOf("TEST1");

        if (admin.tableExists(table_name)) {

            admin.disableTable(table_name);

            admin.deleteTable(table_name);

        }

        HTableDescriptor desc = new HTableDescriptor(table_name);

        HColumnDescriptor family1 = new HColumnDescriptor(constants.COLUMN_FAMILY_DF.getBytes());

        family1.setTimeToLive(3 * 60 * 60 * 24);     //过期时间

        family1.setMaxVersions(3);                   //版本数

        desc.addFamily(family1);

        byte[][] splitKeys = {

            Bytes.toBytes("row01"),

            Bytes.toBytes("row02"),

        };

        admin.createTable(desc, splitKeys);

        admin.close();

        connection.close();

    }

}
--END--
HBase预分区方法的更多相关文章
- hbase 预分区与自动分区
我们知道,HBASE在创建表的时候,会自动为表分配一个Region,当一个Region过大达到默认的阈值时(默认10GB大小),HBase中该Region将会进行split,分裂为2个Region,以 ...
- Hbase预分区种子生成
提前生成Hbase预分区种子,在创建Hbase表时也进行相应的预分区,同时设置预分区的个数,预分区的范围对应Hbase监控页面的Region Server的start key与End key,从而使数 ...
- HBase预分区
seq 0 7 | awk '{printf("\\x%02x\\x%02x\n", $1/256, $1%256);}' | sort -R |head -3 create 'm ...
- 大数据量场景下storm自定义分组与Hbase预分区完美结合大幅度节省内存空间
前言:在系统中向hbase中插入数据时,常常通过设置region的预分区来防止大数据量插入的热点问题,提高数据插入的效率,同时可以减少当数据猛增时由于Region split带来的资源消耗.大量的预分 ...
- storm自定义分组与Hbase预分区结合节省内存消耗
Hbas预分区 在系统中向hbase中插入数据时,常常通过设置region的预分区来防止大数据量插入的热点问题,提高数据插入的效率,同时可以减少当数据猛增时由于Region split带来的资源消耗. ...
- hbase 预分区
转载 http://www.cnblogs.com/bdifn/p/3801737.html
- HBase表预分区与压缩
1.建立HBase预分区表.sql语句如下: create 'buyer_calllogs_info_ts', 'record', {SPLITS_FILE => 'hbase_calllogs ...
- HBase 热点问题——rowkey散列和预分区设计
热点发生在大量的client直接访问集群的一个或极少数个节点(访问可能是读,写或者其他操作).大量访问会使热点region所在的单个机器超出自身承受能力,引起性能下降甚至region不可用,这也会影响 ...
- HBase学习——3.HBase表设计
1.建表高级属性 建表过程中常用的shell命令 1.1 BLOOMFILTER 默认是 NONE 是否使用布隆过虑及使用何种方式,布隆过滤可以每列族单独启用 使用HColumnDescriptor. ...
随机推荐
- 黄聪:自定义WordPress顶部管理工具条的技巧(转)
使用WordPress开发网站项目,很多时候都需要对进行后台定制,今天倡萌主要分享下自定义顶部管理工具条的使用技巧. 注:如无特殊说明,请将下面的代码添加到主题的 functions.php 或者插 ...
- cf Double Happiness(判断是否为素数且为4k+1型)
2790. Double Happiness time limit per test 3 seconds memory limit per test 128 megabytes input sta ...
- GOF23设计模式之模板方法模式(template method)
一.模板方法模式概述 模板方法模式是编程中经常使用的模式.它定义了一种操作中的算法架构,将某些步骤延迟到子类中实现.这样,新的子类可以在不改变一个算法结构的前提下重新定义该算法的某些特定步骤. (1) ...
- python 文件操作的函数
1. 文件操作的函数 open(文件名(路径), mode="?", encoding="字符集") 2. 模式: r, w, a, r+, w+, a+, r ...
- java多线程(1) 线程的基本概念
一.线程的基本概念: 线程是一个程序里面不同的执行路径. 程序里面不同的执行路径,每一个分支都是一个线程. 进程:静态的概念.机器上的一个class文件,机器上的一个exe文件,这叫一个进程. 机 ...
- Nginx 之:nginx.conf结构
nginx.conf文件结构如下: ..... events { ...... } http{ .... server{ .... } server{ listen 192.168.0.12:80; ...
- 阶段性总结(PHP-Array函数)
PHP 5 Array 函数 PHP Array 简介 PHP Array 函数允许您访问并操作数组. 支持简单的数组和多维数组. 详情见下表: 函数 描述 array() 创建数组. array_c ...
- mysql where语句中 or 和 and连用注意点
在mysql中,经常会遇到这样的情况,在写条件语句where时,可能会同时有多个条件的“或”或者“与”,但经常会达不到效果,经百度,本人发现一个where语句中同时出现条件的“与”或者“或的时候”,要 ...
- Docker 存储之卷(Volume)
理解Docker(8):Docker 存储之卷(Volume) (1)Docker 安装及基本用法 (2)Docker 镜像 (3)Docker 容器的隔离性 - 使用 Linux namespa ...
- python与冒泡排序
上一篇文章,介绍了一个非常快的排序算法--桶排序,但是它的缺点就是太耗资源了,这次要实现的算法就不用太耗资源了,它就是冒泡排序. 问题提出: 将以下数据升序排列:9, 2, 8, 6, 4 冒泡排序原 ...