
8种常被忽视的SQL错误用法
作者:一杯甜酒
原文:https://blog.csdn.net/u012562943/article/details/71403500
sql语句的执行顺序:
FROM <left_table>ON <join_condition><join_type> JOIN <right_table>WHERE <where_condition>GROUP BY <group_by_list>HAVING <having_condition>SELECTDISTINCT <select_list>ORDER BY <order_by_condition>LIMIT <limit_number>
1. LIMIT 语句
分页查询是最常用的场景之一,但也通常也是最容易出问题的地方。比如对于下面简单的语句,一般 DBA 想到的办法是在 type, name, create_time 字段上加组合索引。这样条件排序都能有效的利用到索引,性能迅速提升。
SELECT * FROM operation WHERE type = 'SQLStats'AND name = 'SlowLog' ORDER BY create_time LIMIT 1000, 10;
好吧,可能90%以上的 DBA 解决该问题就到此为止。但当 LIMIT 子句变成 “LIMIT 1000000,10” 时,程序员仍然会抱怨:我只取10条记录为什么还是慢?
要知道数据库也并不知道第1000000条记录从什么地方开始,即使有索引也需要从头计算一次。出现这种性能问题,多数情形下是程序员偷懒了。
在前端数据浏览翻页,或者大数据分批导出等场景下,是可以将上一页的最大值当成参数作为查询条件的。SQL 重新设计如下:
SELECT * FROM operation WHERE type = 'SQLStats'AND name = 'SlowLog' AND create_time > '2017-03-16 14:00:00'ORDER BY create_time limit 10;
在新设计下查询时间基本固定,不会随着数据量的增长而发生变化。
2. 隐式转换
SQL语句中查询变量和字段定义类型不匹配是另一个常见的错误。比如下面的语句:
mysql> explain extended SELECT * FROM my_balance b> WHERE b.bpn = 14000000123> AND b.isverified IS NULL ;mysql> show warnings;| Warning | 1739 | Cannot use ref access on index 'bpn' due to type or collation conversion on field 'bpn'
其中字段 bpn 的定义为 varchar(20),MySQL 的策略是将字符串转换为数字之后再比较。函数作用于表字段,索引失效。
上述情况可能是应用程序框架自动填入的参数,而不是程序员的原意。现在应用框架很多很繁杂,使用方便的同时也小心它可能给自己挖坑。
3. 关联更新、删除
虽然 MySQL5.6 引入了物化特性,但需要特别注意它目前仅仅针对查询语句的优化。对于更新或删除需要手工重写成 JOIN。
比如下面 UPDATE 语句,MySQL 实际执行的是循环/嵌套子查询(DEPENDENT SUBQUERY),其执行时间可想而知。
UPDATE operation o SET status = 'applying' WHERE o.idIN (SELECT id FROM (SELECT o.id,o.status FROM operation oWHERE o.group = 123 AND o.status NOT IN ( 'done' )ORDER BY o.parent, o.id LIMIT 1) t);
执行计划:
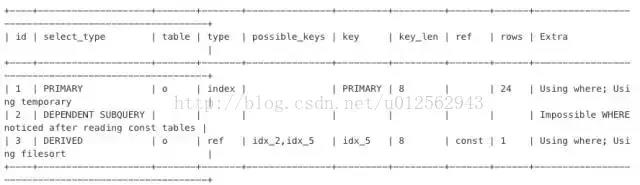
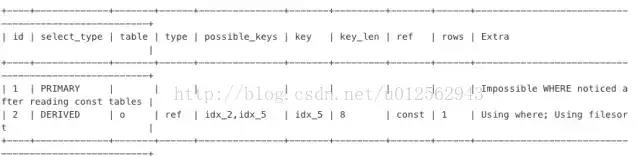
重写为 JOIN 之后,子查询的选择模式从 DEPENDENT SUBQUERY 变成 DERIVED,执行速度大大加快,从7秒降低到2毫秒。
UPDATE operation o JOIN (SELECT o.id, o.status FROM operation o WHERE o.group = 123AND o.status NOT IN ( 'done' ) ORDER BY o.parent,o.id LIMIT 1) tON o.id = t.id SET status = 'applying'
执行计划简化为:
4. 混合排序
MySQL 不能利用索引进行混合排序。但在某些场景,还是有机会使用特殊方法提升性能的。
SELECT * FROM my_order o INNER JOIN my_appraise a ON a.orderid = o.idORDER BY a.is_reply ASC, a.appraise_time DESC LIMIT 0, 20
执行计划显示为全表扫描:
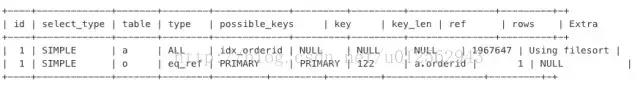
由于 is_reply 只有0和1两种状态,我们按照下面的方法重写后,执行时间从1.58秒降低到2毫秒。
SELECT * FROM ((SELECT * FROM my_order o INNER JOIN my_appraise a ON a.orderid = o.idAND is_reply = 0 ORDER BY appraise_time DESC LIMIT 0, 20)UNION ALL(SELECT * FROM my_order o INNER JOIN my_appraise a ON a.orderid = o.idAND is_reply = 1 ORDER BY appraise_time DESC LIMIT 0, 20)) tORDER BY is_reply ASC, appraisetime DESC LIMIT 20;
5. EXISTS语句
MySQL 对待 EXISTS 子句时,仍然采用嵌套子查询的执行方式。如下面的 SQL 语句:
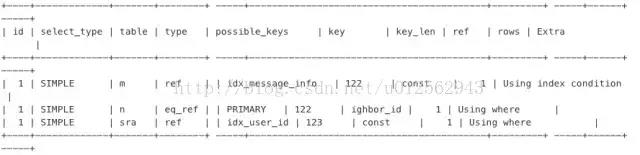
SELECT *FROM my_neighbor nLEFT JOIN my_neighbor_apply sraON n.id = sra.neighbor_idAND sra.user_id = 'xxx'WHERE n.topic_status < 4AND EXISTS(SELECT 1FROM message_info mWHERE n.id = m.neighbor_idAND m.inuser = 'xxx')AND n.topic_type <> 5
执行计划为:
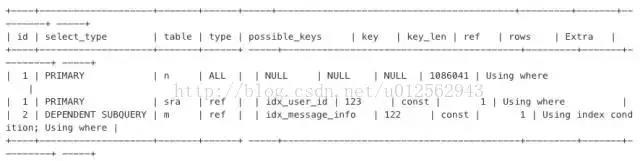
去掉 exists 更改为 join,能够避免嵌套子查询,将执行时间从1.93秒降低为1毫秒。
SELECT *FROM my_neighbor nINNER JOIN message_info mON n.id = m.neighbor_idAND m.inuser = 'xxx'LEFT JOIN my_neighbor_apply sraON n.id = sra.neighbor_idAND sra.user_id = 'xxx'WHERE n.topic_status < 4AND n.topic_type <> 5
新的执行计划:
6. 条件下推
外部查询条件不能够下推到复杂的视图或子查询的情况有:
1、聚合子查询; 2、含有 LIMIT 的子查询; 3、UNION 或 UNION ALL 子查询; 4、输出字段中的子查询;
如下面的语句,从执行计划可以看出其条件作用于聚合子查询之后:
SELECT *FROM (SELECT target,Count(*)FROM operationGROUP BY target) tWHERE target = 'rm-xxxx'
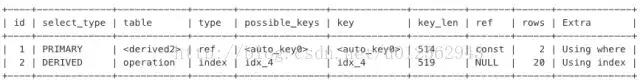
确定从语义上查询条件可以直接下推后,重写如下:
SELECT target,Count(*)FROM operationWHERE target = 'rm-xxxx'GROUP BY target
执行计划变为:

关于 MySQL 外部条件不能下推的详细解释说明请参考以前文章:MySQL · 性能优化 · 条件下推到物化表 http://mysql.taobao.org/monthly/2016/07/08
7. 提前缩小范围**
先上初始 SQL 语句:
SELECT *FROM my_order oLEFT JOIN my_userinfo uON o.uid = u.uidLEFT JOIN my_productinfo pON o.pid = p.pidWHERE ( o.display = 0 )AND ( o.ostaus = 1 )ORDER BY o.selltime DESCLIMIT 0, 15
该SQL语句原意是:先做一系列的左连接,然后排序取前15条记录。从执行计划也可以看出,最后一步估算排序记录数为90万,时间消耗为12秒。
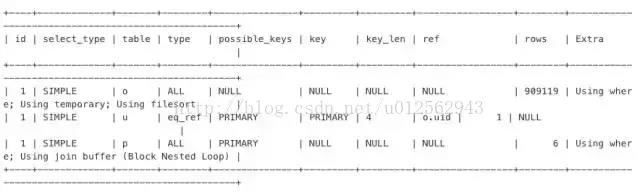
由于最后 WHERE 条件以及排序均针对最左主表,因此可以先对 my_order 排序提前缩小数据量再做左连接。SQL 重写后如下,执行时间缩小为1毫秒左右。
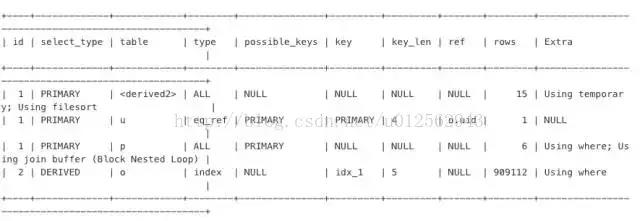
SELECT *FROM (SELECT *FROM my_order oWHERE ( o.display = 0 )AND ( o.ostaus = 1 )ORDER BY o.selltime DESCLIMIT 0, 15) oLEFT JOIN my_userinfo uON o.uid = u.uidLEFT JOIN my_productinfo pON o.pid = p.pidORDER BY o.selltime DESClimit 0, 15
再检查执行计划:子查询物化后(select_type=DERIVED)参与 JOIN。虽然估算行扫描仍然为90万,但是利用了索引以及 LIMIT 子句后,实际执行时间变得很小。
8. 中间结果集下推
再来看下面这个已经初步优化过的例子(左连接中的主表优先作用查询条件):
SELECT a.*,c.allocatedFROM (SELECT resourceidFROM my_distribute dWHERE isdelete = 0AND cusmanagercode = '1234567'ORDER BY salecode limit 20) aLEFT JOIN(SELECT resourcesid, sum(ifnull(allocation, 0) * 12345) allocatedFROM my_resourcesGROUP BY resourcesid) cON a.resourceid = c.resourcesid
那么该语句还存在其它问题吗?不难看出子查询 c 是全表聚合查询,在表数量特别大的情况下会导致整个语句的性能下降。
其实对于子查询 c,左连接最后结果集只关心能和主表 resourceid 能匹配的数据。因此我们可以重写语句如下,执行时间从原来的2秒下降到2毫秒。
SELECT a.*,c.allocatedFROM (SELECT resourceidFROM my_distribute dWHERE isdelete = 0AND cusmanagercode = '1234567'ORDER BY salecode limit 20) aLEFT JOIN(SELECT resourcesid, sum(ifnull(allocation, 0) * 12345) allocatedFROM my_resources r,(SELECT resourceidFROM my_distribute dWHERE isdelete = 0AND cusmanagercode = '1234567'ORDER BY salecode limit 20) aWHERE r.resourcesid = a.resourcesidGROUP BY resourcesid) cON a.resourceid = c.resourcesid
但是子查询 a 在我们的SQL语句中出现了多次。这种写法不仅存在额外的开销,还使得整个语句显的繁杂。使用 WITH 语句再次重写:
WITH a AS(SELECT resourceidFROM my_distribute dWHERE isdelete = 0AND cusmanagercode = '1234567'ORDER BY salecode limit 20)SELECT a.*,c.allocatedFROM aLEFT JOIN(SELECT resourcesid, sum(ifnull(allocation, 0) * 12345) allocatedFROM my_resources r,aWHERE r.resourcesid = a.resourcesidGROUP BY resourcesid) cON a.resourceid = c.resourcesid
总结
数据库编译器产生执行计划,决定着SQL的实际执行方式。但是编译器只是尽力服务,所有数据库的编译器都不是尽善尽美的。
上述提到的多数场景,在其它数据库中也存在性能问题。了解数据库编译器的特性,才能避规其短处,写出高性能的SQL语句。
程序员在设计数据模型以及编写SQL语句时,要把算法的思想或意识带进来。
编写复杂SQL语句要养成使用 WITH 语句的习惯。简洁且思路清晰的SQL语句也能减小数据库的负担 。
8种常被忽视的SQL错误用法的更多相关文章
- 8 种常被忽视的 SQL 错误用法
来源:db匠 yq.aliyun.com/articles/72501 sql语句的执行顺序: FROM <left_table> ON <join_condition> ...
- 8种常被忽视的SQL错误用法,你中招了吗?
前言 MySQL在近几年仍然保持强劲的数据库流行度增长趋势.越来越多的客户将自己的应用建立在 MySQL 数据库之上,甚至是从 Oracle 迁移到 MySQL上来.但也存在部分客户在使用 MySQL ...
- 8种经常被忽视的SQL错误用法,你有没有踩过坑?
1.LIMIT 语句 分页查询是最常用的场景之一,但也通常也是最容易出问题的地方.比如对于下面简单的语句,一般 DBA 想到的办法是在 type, name, create_time 字段上加组合索引 ...
- 8 种经常被忽视的 SQL 错误用法,你有没有踩过坑?
1.LIMIT 语句 分页查询是最常用的场景之一,但也通常也是最容易出问题的地方.比如对于下面简单的语句,一般 DBA 想到的办法是在 type, name, create_time 字段上加组合索引 ...
- 这些经常被忽视的SQL错误用法,你有没有踩过坑?
之前已经讲过mysql的性能优化,感兴趣的朋友可以看看之前的文章,<史上最全的MySQL高性能优化实战总结!>.但是有些问题其实是我们自身的SQL语句有问题导致的.今天就来总结哪些经常被我 ...
- 一直被用错的6种SQL 错误用法
一直被用错的6种SQL 错误用法 1.LIMIT 语句 2.隐式转换 3.关联更新.删除 4.EXISTS语句 5.条件下推 6.提前缩小范围 sql语句的执行顺序: FROM ON JOIN WHE ...
- 8种常见的SQL错误用法
常见SQL错误用法 1. LIMIT 语句 分页查询是最常用的场景之一,但也通常也是最容易出问题的地方.比如对于下面简单的语句,一般DBA想到的办法是在type, name, create_time字 ...
- MySQL常见的8种SQL错误用法
MySQL常见的8种SQL错误用法 前言 MySQL在2016年仍然保持强劲的数据库流行度增长趋势.越来越多的客户将自己的应用建立在MySQL数据库之上,甚至是从Oracle迁移到MySQL上来.但也 ...
- MySQL · 性能优化 · MySQL常见SQL错误用法(转自-阿里云云栖社区)
作者:阿里云云栖社区链接:https://zhuanlan.zhihu.com/p/26043916来源:知乎著作权归作者所有,转载请联系作者获得授权. 前言 MySQL在2016年仍然保持强劲的数据 ...
随机推荐
- 这是一份很详细的 Retrofit 2.0 使用教程(含实例讲解)
前言 在Andrroid开发中,网络请求十分常用 而在Android网络请求库中,Retrofit是当下最热的一个网络请求库 今天,我将献上一份非常详细Retrofit v2.0的使用教程,希望你们会 ...
- hdu4292网络流dinic
因为数组开小了,导致tle了一整天:( tle的几点原因:http://blog.csdn.net/ameir_yang/article/details/53698478 思路都是对的,把每个人进行拆 ...
- MD5加密源码!
import java.security.*; class MD5{ public final static String MD5(String s){ char hexDigits[] = {'0' ...
- c#TextBox输入框自动提示、自动完成、自动补全功能
功能概览 相关属性 TextBox.AutoCompleteCustomSource 属性 获取或设置当 TextBox.AutoCompleteSource 属性设置为 [CustomSource] ...
- pyalgotrade入门
入门代码解析: from pyalgotrade import strategyfrom pyalgotrade.barfeed import yahoofeed #继承自BacktestingStr ...
- Properties集合小应用--限制用户对软件的使用次数
我们可以注意到一些付费软件可以试用一定的次数,超过限制次数后,就必须到官网购买正版才能继续使用. 这里就简单地模拟一下这种效果的实现. * 需求:记录程序的启动次数,当启动次数超过3次后,要求使用者注 ...
- WPF 多线程 UI:设计一个异步加载 UI 的容器
对于 WPF 程序,如果你有某一个 UI 控件非常复杂,很有可能会卡住主 UI,给用户软件很卡的感受.但如果此时能有一个加载动画,那么就不会感受到那么卡顿了.UI 的卡住不同于 IO 操作或者密集的 ...
- 6-8 Percolate Up and Down(20 分)
Write the routines to do a "percolate up" and a "percolate down" in a binary min ...
- 老毛桃(U盘启动盘)
1.制作U盘启动盘: http://www.laomaotao.org/jiaocheng/92/upzwin7.html 2.老毛桃U盘快速安装gost win7系统教程: http://www.l ...
- python 生成器 迭代器 yiled
文章来源:http://python.jobbole.com/81911/ https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449 ...