
CentOS6.5 安装Spark集群
一、安装依赖软件Scala(所有节点)
1、下载Scala:http://www.scala-lang.org/files/archive/scala-2.10.4.tgz
2、解压:
[root@Hadoop-NN-01 ~]# tar -xzvf scala-2.10.4.tgz -C /usr/local/
3、配置scala环境变量
[root@Hadoop-NN-01 ~]# vim /etc/profile

export SCALA_HOME=/usr/local/scala

export PATH=$PATH:${SCALA_HOME}/bin

[root@Hadoop-NN-01 ~]# source /etc/profile       #使环境变量生效
4、测试scala运行环境
[root@Hadoop-NN-01 scala]# scala

scala> 15*15

res0: Int = 225
二、安装spark
1、下载spark:http://archive.cloudera.com/cdh5/cdh/5/spark-1.5.0-cdh5.6.0.tar.gz
理论上讲CDH的一套是没有问题,可是我装了三个版本都没有装成功,启动的时候始终一个错:Exception in thread "main" java.lang.NoClassDefFoundError: org/slf4j/Logger
提示缺少slf4j依赖包:log4j-1.2.17.jar、 slf4j-api-1.7.10.jar、 slf4j-log4j12-1.7.10.jar
可我将这三个包放到lib下依然不行,最后只能下载的官方的安装。如果有朋友知道原谅还请留言,谢谢!
引用【书忆江南】的回复:
#CDH版的Spark安装目录下的/conf/spark-env.sh配置文件中,添加以下环境变量:export SPARK_DIST_CLASSPATH=(/mnt/sda6/Hadoop/hadoop−2.6.0−cdh5.15.0/bin/hadoopclasspath),给这个变量添加你已经安装的CDHHadoop的类路径,我看到别的教程说等号后面可以直接(/mnt/sda6/Hadoop/hadoop−2.6.0−cdh5.15.0/bin/hadoopclasspath),给这个变量添加你已经安装的CDHHadoop的类路径,我看到别的教程说等号后面可以直接(hadoop classpath),我试过,这样只能启动Master,启动Worker进程的时候还是会报缺Logger的错。所以,必须要在括号内写全CDH Hadoop的安装路径精确到/bin,然后再斜杠接上hadoop classpath才行。

export SPARK_DIST_CLASSPATH=$(/mnt/sda6/Hadoop/hadoop-2.6.0-cdh5.15.0/bin/hadoop classpath)
官方下载:http://www.apache.org/dyn/closer.lua/spark/spark-1.6.0/spark-1.6.0-bin-hadoop2.6.tgz
2、解压:
[root@Hadoop-NN-01 ~]# tar xzvf spark-1.6.0-bin-hadoop2.6.tgz
3、配置Spark环境变量
[root@Hadoop-NN-01 ~]# vim /etc/profile

export SPARK_HOME=/home/hadoopuser/spark-1.6.0-bin-hadoop2.6

export PATH=$PATH:${SPARK_HOME}/bin

[root@Hadoop-NN-01 ~]# source /etc/profile       #使环境变量生效
4、配置 ${SPARK_HOME}/conf/spark-env.sh
[hadoopuser@Hadoop-NN-01 conf]$ cp spark-env.sh.template spark-env.sh

[hadoopuser@Hadoop-NN-01 conf]$ vim spark-env.sh

export JAVA_HOME=/usr/java/jdk1.8.0_73

export SCALA_HOME=/usr/local/scala

export HADOOP_HOME=/home/hadoopuser/hadoop-2.6.0-cdh5.6.0

export HADOOP_CONF_DIR=/home/hadoopuser/hadoop-2.6.0-cdh5.6.0/etc/hadoop


export SPARK_MASTER_IP=192.168.107.82

export SPARK_MASTER_PORT=8070

export SPARK_MASTER_WEBUI_PORT=8090

export SPARK_WORKER_CORES=1        #每个Worker使用的CPU核数

export SPARK_WORKER_INSTANCES=1    #每个Slave中启动几个Worker实例

export SPARK_WORKER_PORT=8092      #Worker的WebUI端口号

export SPARK_WORKER_MEMORY=1g      #每个Worker使用多大的内存
其它参数:
|
SPARK_MASTER_IP |
绑定一个外部IP给master。 |
|
SPARK_MASTER_PORT |
从另外一个端口启动master(默认: 7077) |
|
SPARK_MASTER_WEBUI_PORT |
Master的web UI端口(默认:8080) |
|
SPARK_WORKER_PORT |
启动Spark worker 的专用端口(默认:随机) |
|
SPARK_WORKER_DIR |
伸缩空间和日志输入的目录路径(默认:SPARK_HOME/work) |
|
SPARK_WORKER_CORES |
作业可用的CPU内核数量(默认:所有可用的) |
|
SPARK_WORKER_MEMORY |
作业可使用的内存容量,默认格式1000M或者 2G (默认:所有RAM去掉给操作系统用的1 GB)注意:每个作业自己的内存空间由SPARK_MEM决定。 |
|
SPARK_WORKER_WEBUI_PORT |
worker 的web UI 启动端口(默认:8081) |
|
SPARK_WORKER_INSTANCES |
每个机器上运行worker数量(默认:1)当你有一个非常强大的计算机的时候和需要多个Spark worker进程的时候你可以修改这个默认值大于1。如果你设置了这个值。要确保SPARK_WORKER_CORE 明确限制每一个r worker的核心数,否则每个worker 将尝试使用所有的核心。 |
|
SPARK_DAEMON_MEMORY |
分配给Spark master和 worker 守护进程的内存空间(默认:512m) |
|
SPARK_DAEMON_JAVA_OPTS |
Spark master 和 worker守护进程的JVM 选项(默认:none) |
5、配置 {SPARK_HOME}/conf/ slaves
[hadoopuser@Hadoop-NN-01 conf]$ cp slaves.template slaves

[hadoopuser@Hadoop-NN-01 conf]$ vim slaves

#注意这里添加所有工作节点的主机名或者ip

#Hadoop-NN-01(如果既想当master又想当worker的话,可以配置上。)

Hadoop-DN-01

Hadoop-DN-02
6、程序分发
scp -r spark-1.6.0-bin-hadoop2.6. hadoopuser@Hadoop-DN-01:/home/hadoopuser/

scp -r spark-1.6.0-bin-hadoop2.6. hadoopuser@Hadoop-DN-02:/home/hadoopuser/
7、启动spark集群
[hadoopuser@Hadoop-NN-01 sbin]# ./start-all.sh
单节点启动:
sbin/start-master.sh               #启动主节点

sbin/start-slave.sh 192.168.107.82:8070    #启动从节点
8、运行示例程序
[hadoopuser@Hadoop-NN-01 spark-1.6.0-bin-hadoop2.6.]# ./bin/run-example SparkPi 10 > Sparkpilog.txt
9、验证
1)jps
主节点多了Master
从节点多了Worker
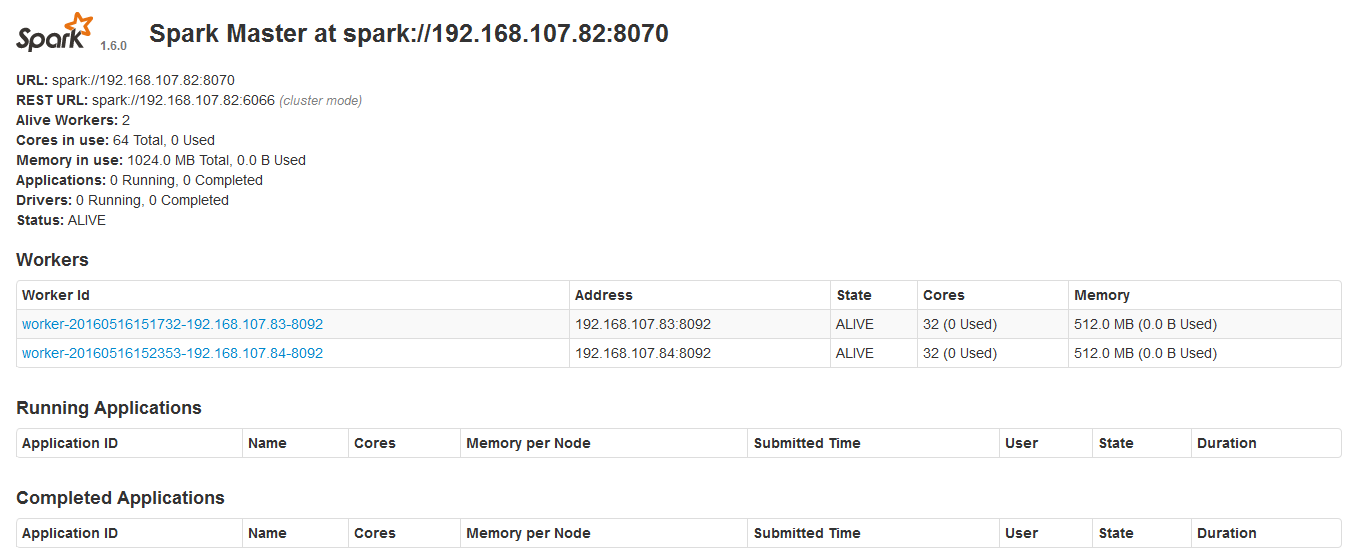
2)浏览器查看http://192.168.107.82:8090/
10、使用spark-shell
[hadoopuser@Hadoop-NN-01 spark-1.5.0-cdh5.6.0]# bin/spark-shell
浏览器访问SparkUI http:// 192.168.107.82:4040/
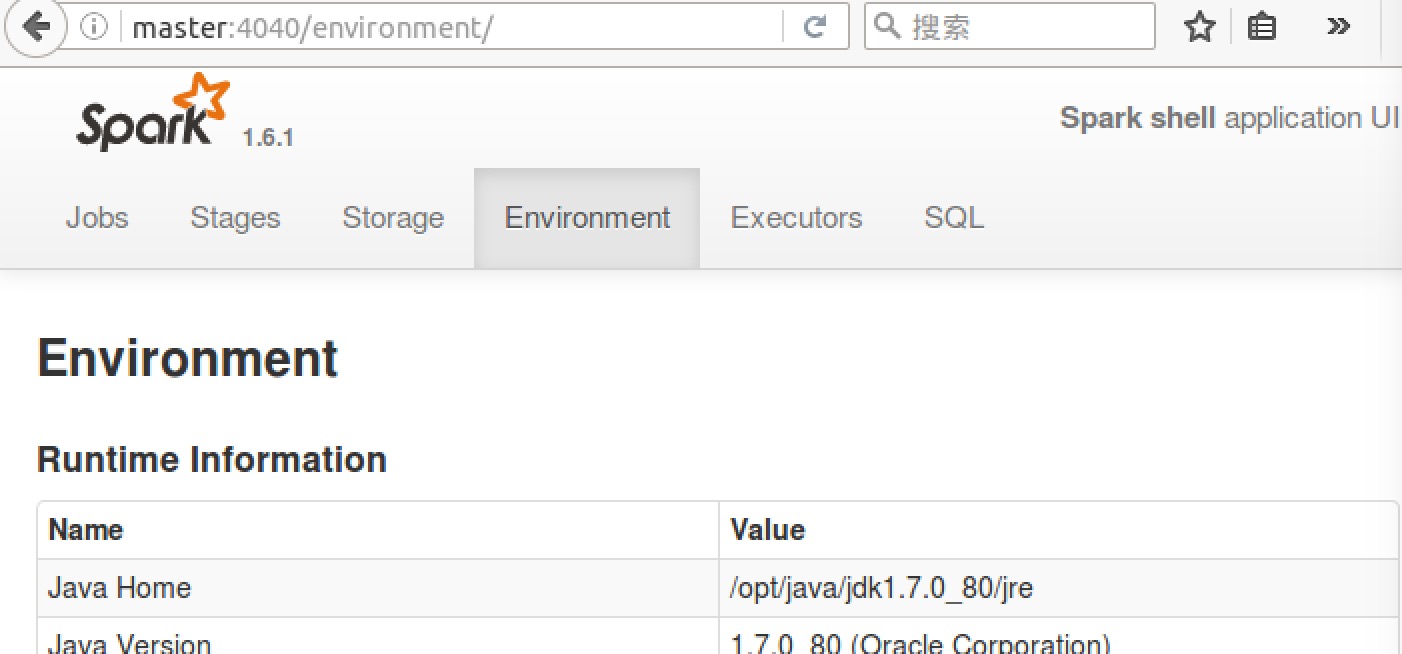
可以从 SparkUI 上查看一些 如环境变量、Job、Executor等信息。
至此,整个 Spark 分布式集群的搭建就到这里结束。
11、停止spark集群
[hadoopuser@Hadoop-NN-01 sbin]# ./stop-all.sh
CentOS6.5 安装Spark集群的更多相关文章
- Spark学习笔记--Linux安装Spark集群详解
本文主要讲解如何在Linux环境下安装Spark集群,安装之前我们需要Linux已经安装了JDK和Scala,因为Spark集群依赖这些.下面就如何安装Spark进行讲解说明. 一.安装环境 操作系统 ...
- 安装Spark集群(在CentOS上)
环境:CentOS 6.4, Hadoop 1.1.2, JDK 1.7, Spark 0.7.2, Scala 2.9.3 1. 安装 JDK 1.7 yum search openjdk-deve ...
- CentOS7 安装spark集群
Spark版本 1.6.0 Scala版本 2.11.7 Zookeeper版本 3.4.7 配置虚拟机 3台虚拟机,sm,sd1,sd2 1. 关闭防火墙 systemctl stop firewa ...
- RedHat6.5安装Spark集群
版本号: RedHat6.5 RHEL 6.5系统安装配置图解教程(rhel-server-6.5) JDK1.8 http://blog.csdn.net/chongxin1/arti ...
- Centos6.6 安装Mysql集群
一.环境准备 1.1系统IP设置 准备三台服务器安装Centos6.6 64位操作系统,IP地址及角色分配如下: Node IP Address ...
- 36. CentOS-6.3安装Mysql集群
安装要求 安装环境:CentOS-6.3安装方式:源码编译安装 软件名称:mysql-cluster-gpl-7.2.6-linux2.6-x86_64.tar.gz下载地址:http://mysql ...
- redis CentOS6.5安装及集群部署
.下载redis source包 链接:https://pan.baidu.com/s/122ZCjNvjl9Jx6M2YsLrncw 密码:92ze 2.解压 tar -xzf redis-3.2. ...
- CentOS6.5 安装Storm集群
1.首先安装依赖包 [root@Hadoop-NN-01 ~]# yum install uuid* [root@Hadoop-NN-01 ~]# yum install libuuid [root@ ...
- CentOS6.5安装HBase集群及多HMaster配置
1.配置SSH免登录 请参考:http://www.cnblogs.com/hunttown/p/5470357.html 服务器配置: Hadoop-NN-01 主Hadoop-NN-02 备Had ...
随机推荐
- 01List.ashx(班级列表动态页面)
01List.html <!DOCTYPE html> <html xmlns="http://www.w3.org/1999/xhtml"> <he ...
- Flask web开发之路九
flask_scripts介绍 项目结构如下: flask_script_demo.py文件: from flask import Flask app = Flask(__name__) @app.r ...
- Codeforces 670E - Correct Bracket Sequence Editor - [线段树]
题目链接:https://codeforces.com/contest/670/problem/E 题意: 给出一个已经匹配的括号串,给出起始的光标位置(光标总是指向某个括号). 有如下操作: 1.往 ...
- MySQL的一些概念
数据库与服务器.客户端的层次关系 关于数据库 程序中需要存储数据的方式: 1 变量(列表.元组.集合.字典.嵌套) 2 外存(文件)(*.ini) 3 表格.Excel(*.xls.*.xlsx.*. ...
- [math][mathematica] archlinux 下 mathematica 的安装 (科学计算软件 mathematica/matlab/sagemath)
ONLINE: http://www.wolframalpha.com/ GPL: segamath: http://www.sagemath.org/ famous and not free: ma ...
- pip离线安装python包
1 首先在一台能上网的机器上得到python包 1) 新建一个空目录,如 /home/ubuntu/zcy/ss,用来存储下载下来的所需安装包 2)下载安装包:pip install --downlo ...
- postgre
切换用户:su postgres 启动:psql 查看有哪些数据库: \l 切换到数据库air: \c air 列出数据库中所有表: \d 列出指定表的所有字段信息: \d+ dag 或者 \d da ...
- 转:GET和POST两种基本请求方法的区别
原文地址:GET和POST两种基本请求方法的区别 原文如下: GET和POST是HTTP请求的两种基本方法,要说它们的区别,接触过WEB开发的人都能说出一二. 最直观的区别就是GET把参数包含在URL ...
- 内部排序->插入排序->其它插入排序->2-路插入排序
文字描述 在折半插入排序的基础上进行改进, 另设一个和待排序序列L相同的数组D, 首先将L[1]赋值给D[0], 数组D中数据是已经排好序的, first指向最小值下标,final指向最大值下标.初始 ...
- 实验四 Android程序设计
20155224 实验四 Android程序设计 实验报告 实验报告封面: 课程:Java程序设计 班级:1652班 姓名:王高源 学号:20165225 指导教师:娄嘉鹏 实验日期:2018年5月1 ...