
CentOS7 安装spark集群
Spark版本 1.6.0
Scala版本 2.11.7
Zookeeper版本 3.4.7

配置虚拟机
3台虚拟机,sm,sd1,sd2

1. 关闭防火墙
systemctl stop firewalld
systemctl stop firewalld
如果不关闭防火墙,需要为防火墙添加进站出站规则,否则无法访问spark的管理页面
2. 修改机器名
hostnamectl set-hostname sm
其他2台机器同上
3. 修改host
vim /etc/hosts

4. 配置ssh免密码登陆
在sm机器
ssh-keygen -t rsa
ssh-copy-id -i ~/.ssh/id_rsa.pub peter@sd1
ssh-copy-id -i ~/.ssh/id_rsa.pub peter@sd2
ssh-copy-id -i ~/.ssh/id_rsa.pub peter@sm
如果不配置本机的ssh免密码登陆,在后面启动spark集群的时候,会发现本机的worker无法启动
4. 安装Java
安装Zookeeper
复制zookeeper的gz文件至sm机器
1. 解压
tar zxf zookeeper-3.4.7.tar.gz
2. 配置
cd conf
cp zoo_sample.cfg zoo.cfg
vim zoo.cfg

3. 设置serverid
进入data文件夹
cd /home/peter/App/Spark/zookeeper-3.4.7/data
sm机器
echo "1">myid
4. Copy至其他机器
scp -r /home/peter/App/Spark/zookeeper-3.4.7 peter@sd2:/home/peter/App/Spark/zookeeper-3.4.7
5. 修改另外台机器的serverid
重复第3步,分别将id设置为配置文件中对应的id
cd /home/peter/App/Spark/zookeeper-3.4.7/data
sd1
echo "2">myid
sd2
echo "3">myid
安装Spark
在sm机器
1. 拷贝安装文件并解压
scala-2.11.7.tgz
spark-1.6.0-bin-hadoop2.6.tgz
hadoop-2.6.0.tar.gz
分别解压

2. 设置环境变量
vim ~/.bash_profile
export JAVA_HOME=/home/peter/App/jdk1..0_66

export PATH=$JAVA_HOME/bin:$PATH

export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

export SCALA_HOME=/home/peter/App/Spark/scala-2.11.

export SPARK_HOME=/home/peter/App/Spark/spark-1.6.-bin-hadoop2.

export HADOOP_HOME=/home/peter/App/Spark/hadoop-2.6.

export HADOOP_CONF_DIR=/home/peter/App/Spark/hadoop-2.6./etc/hadoop

export PATH=$PATH:$SCALA_HOME/bin:$SPARK_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
source ~/.bash_profile
3. 设置Spark
cd /home/peter/App/Spark/spark-1.6.0-bin-hadoop2.6/conf
cp spark-env.sh.template spark-env.sh
export SCALA_HOME=/home/peter/App/Spark/scala-2.11.

export SPARK_WORKER_MEMORY=1G

export JAVA_HOME=/home/peter/App/jdk1..0_66

export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=sm:2181,sd1:2181,sd2:2181 -Dspark.deploy.zookeeper.dir=/spark"
配置slaves
cp slaves.template slaves
vim slaves
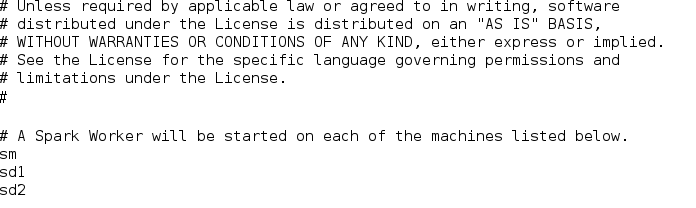
4. 拷贝安装文件以及配置文件至其他机器
Java安装文件及配置文件
Hadoop
Spark
Scala
5. 启动Spark集群
每台机器启动ZK
/home/peter/App/Spark/zookeeper-3.4.7/bin/zkServer.sh start
在SM机器启动Spark集群
cd /home/peter/App/Spark/spark-1.6.0-bin-hadoop2.6
./sbin/start-all.sh
选中一台机器作为Standby Master,启动Master进程
./sbin/start-master.sh
启动后,可访问Spark Alive Master的管理页面以及Standby Master的管理页面


如果将Alive Master节点关闭或者Kill掉ZK以及Master进程,Spark会自动切换到Standby Master
提交任务至Spark
参考Spark QuickStart中的例子
提交一个Jar包进行测试
POM配置
    <dependencies>

        <dependency> <!-- Spark dependency -->

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-core_2.10</artifactId>

            <version>1.6.0</version>

        </dependency>

    </dependencies>
public class Entry {

    public static void main(String[] args)

    {

        System.out.println("Step 1");

        String logFile = "/home/peter/App/Spark/spark-1.6.0-bin-hadoop2.6/README.md"; // Should be some file on your system

        SparkConf conf = new SparkConf().setAppName("Test Application")

                .setMaster("spark://192.168.1.90:7077")

                //.set("spark.driver.host", "192.168.1.111")

               // .set("SPARK_WORKER_IP","192.168.1.111")

                //.setJars(new String[]{"/home/peter/App/Spark/work/homework.jar"})

                ;

        System.out.println("Step 2.");

        JavaSparkContext sc = new JavaSparkContext(conf);

        JavaRDD<String> logData = sc.textFile(logFile).cache();

        long numAs = logData.filter(new Function<String, Boolean>() {

            public Boolean call(String s) { return s.contains("a"); }

        }).count();

       long numBs = logData.filter(new Function<String, Boolean>() {

            public Boolean call(String s) { return s.contains("b"); }

        }).count();

        System.out.println("Lines with a: " + numAs + ", lines with b: " + numBs);

    }

}
生成Jar包
可能哪里的配置有些问题,Jar包开始无法正确运行,查找了一些资料后,是一些引用版本比较混乱引起的。
在Jar包的META-INF文件夹中删除下面的文件

MANIFEST.MF文件中也必须有Main-Class
Manifest-Version: 1.0
Main-Class: Entry
拷贝jar包至sm机器上,并运行

CentOS7 安装spark集群的更多相关文章
- Spark学习笔记--Linux安装Spark集群详解
本文主要讲解如何在Linux环境下安装Spark集群,安装之前我们需要Linux已经安装了JDK和Scala,因为Spark集群依赖这些.下面就如何安装Spark进行讲解说明. 一.安装环境 操作系统 ...
- 安装Spark集群(在CentOS上)
环境:CentOS 6.4, Hadoop 1.1.2, JDK 1.7, Spark 0.7.2, Scala 2.9.3 1. 安装 JDK 1.7 yum search openjdk-deve ...
- CentOS6.5 安装Spark集群
一.安装依赖软件Scala(所有节点) 1.下载Scala:http://www.scala-lang.org/files/archive/scala-2.10.4.tgz 2.解压: [root@H ...
- RedHat6.5安装Spark集群
版本号: RedHat6.5 RHEL 6.5系统安装配置图解教程(rhel-server-6.5) JDK1.8 http://blog.csdn.net/chongxin1/arti ...
- CentOS7 安装Hbase集群
继续接上一章,已安装好Hadoop集群环境 http://www.cnblogs.com/dopeter/p/4612232.html 在此基础上继续安装Hbase集群 Hbase版本为1.0.1.1 ...
- CentOS7安装HDP集群
之前安装大数据组件都是一个一个手动安装的,最多弄一个脚本自动安装.手动安装麻烦不说,还没有可以监控集群的可视化界面,而且组件的稳定性也是个问题. 所以我们应该试一试HDP和CDH这种企业级的hadoo ...
- CentOS7安装rabbitmq集群(二进制)
一.RabbiMQ简介 RabbiMQ是用Erang开发的,集群非常方便,因为Erlang天生就是一门分布式语言,但其本身并不支持负载均衡. RabbiMQ模式 RabbitMQ模式大概分为以下三种: ...
- CentOS7安装RabbitMQ集群
实验环境 RabbitMQ 集群 server1.example.com IP: 10.10.10.11 Node: diskserver2.example.com IP: 10.1 ...
- CentOS7 安装Hadoop集群环境
先按照上一篇安装与配置好CentOS以及zookeeper http://www.cnblogs.com/dopeter/p/4609276.html 本章介绍在CentOS搭建Hadoop集群环境 ...
随机推荐
- 上门洗车APP --- Androidclient开发 之 项目结构介绍
上门洗车APP --- Androidclient开发 之 项目结构介绍 前言 尽管公司项目较紧,但还是抽空给大家继续更新. o_O"~ 欢迎大家的关注,非常高兴和大家共同学习.前面给大家分 ...
- Windows Phone开发(12):认识一下独具个性的磁贴
原文:Windows Phone开发(12):认识一下独具个性的磁贴 对"磁贴"的理解是一点也不抽象的,为什么呢?只要你愿意启动WP系统,无论你是在模拟器中还是在真机中,是的,桌面 ...
- UVA 1513 - Movie collection(树状数组)
UVA 1513 - Movie collection option=com_onlinejudge&Itemid=8&page=show_problem&category=5 ...
- 设计模式——辛格尔顿(Singleton)
要想正确理解设计模式,首先必须明白它是为了解决什么问题而提出来的. 设计模式学习笔记 --Shulin 转载请注明出处:http://blog.csdn.net/zhshulin 单例模式属于设计模式 ...
- MFC漆摘要-截图,获得DIB/DDB图形Pixel
1. 当前Screen进行Copy屏幕,获得BITMAP 当前屏幕Copy.须要获取当前屏幕的HDC, 一种是直接从屏幕DC抓原始图. 一种是然后使用兼容MemDC进行抓图,然后能够附加图 ...
- 抓取csdn上的各类别的文章 (制作csdn app 二)
转载请表明出处:http://blog.csdn.net/lmj623565791/article/details/23532797 这篇博客接着上一篇(Android 使用Fragment,View ...
- python K-means工具包初解
近期数据挖掘实验,写个K-means算法,写完也不是非常难,写的过程中想到python肯定有包,尽管师兄说不让用,只是自己也写完了,而用包的话,还不是非常熟,略微查找了下资料,学了下.另外,自己本身写 ...
- 应用层协议系列(两)——HTTPserver之http协议分析
上一篇文章<抄nginx Httpserver设计与实现(一)--多进程和多通道IO现>中实现了一个仿照nginx的支持高并发的server.但仅仅是实现了port监听和数据接收.并没有实 ...
- 返璞归真 asp.net mvc (7) - asp.net mvc 3.0 新特性之 Controller
原文:返璞归真 asp.net mvc (7) - asp.net mvc 3.0 新特性之 Controller [索引页][源码下载] 返璞归真 asp.net mvc (7) - asp.net ...
- $POST 、$HTTP_RAW_POST_DATA、php://input三者之间的差别
$POST .$HTTP_RAW_POST_DATA.php://input三者之间的差别 总是产生变量包括有原始的 POST 数据.否则,此变量仅在碰到未识别 MIME 类型的数据时产生.只是,訪问 ...