
tesseract系列(3) -- tesseract训练
tessract的训练有个工具叫 jTessBoxEditor
1、jTessBoxEditor是用java写的,首先要装java的环境
jdk-8u191-windows-x64.exe 这个我想从官网下载来的,但是一直失败,直接从搞java的同事那里要来的。
装完以后要配置一些环境变量:
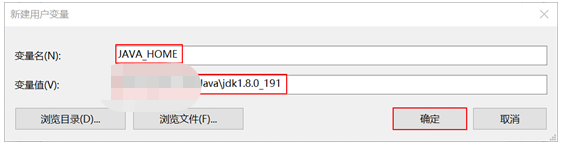
系统环境变量 --》 path ---》新建
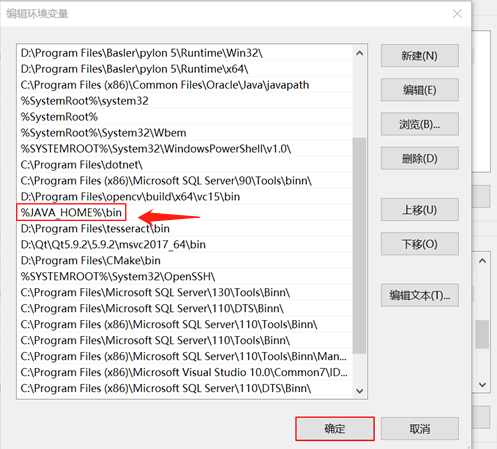
然后重启电脑。。。
2、安装jTessBoxEditor:
下载地址:https://sourceforge.net/projects/vietocr/files/jTessBoxEditor/
3、启动jTessBoxEditor:
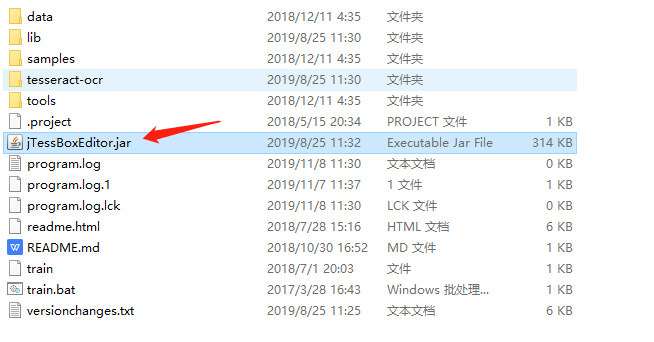
双击显示:
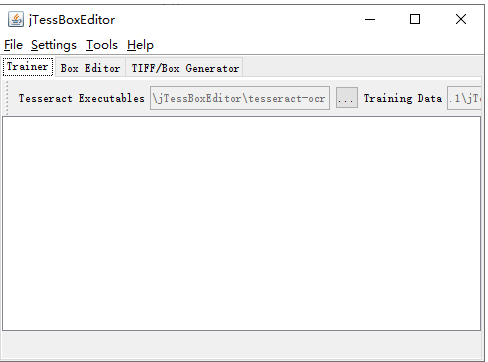
然后进入tools 点击merge tif
如果你加入的模型是tif的格式,直接找到那个tif即可。
如果你加入的图片格式是png的,
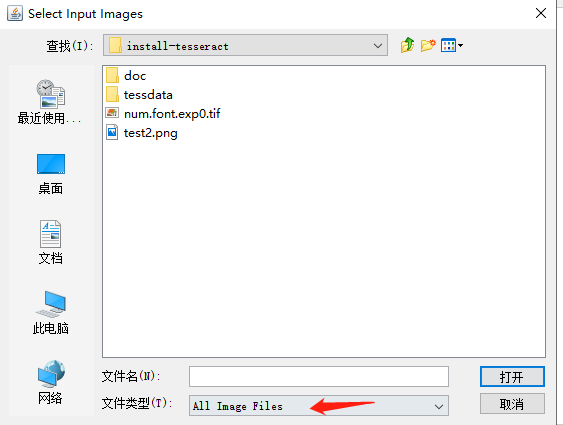
修改加入的文件格式,点击打开会显示保存的界面,将文件保存为:num.font.exp0.tif 其中,num是你自己定义的,图片要保存到tesseract的目录下。
cmd进入tesseract目录,执行命令 tesseract.exe num.font.exp0.tif num.font.exp0 batch.nochop makebox
命令解析,
tesseract [lang].[fontname].exp[num].tif [lang].[fontname].exp[num] batch.nochop makebox
其中lang为语言名称,fontname为字体名称,num为序号,可以随便定义。
然后: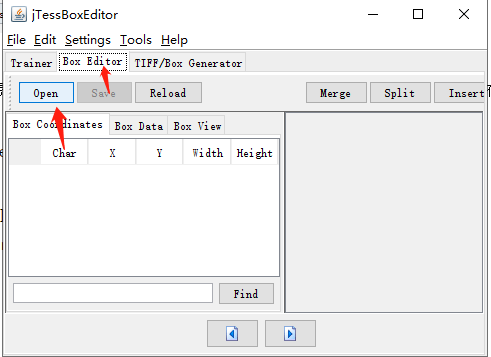
点击open打开上面保存的num.font.exp0.tif文件
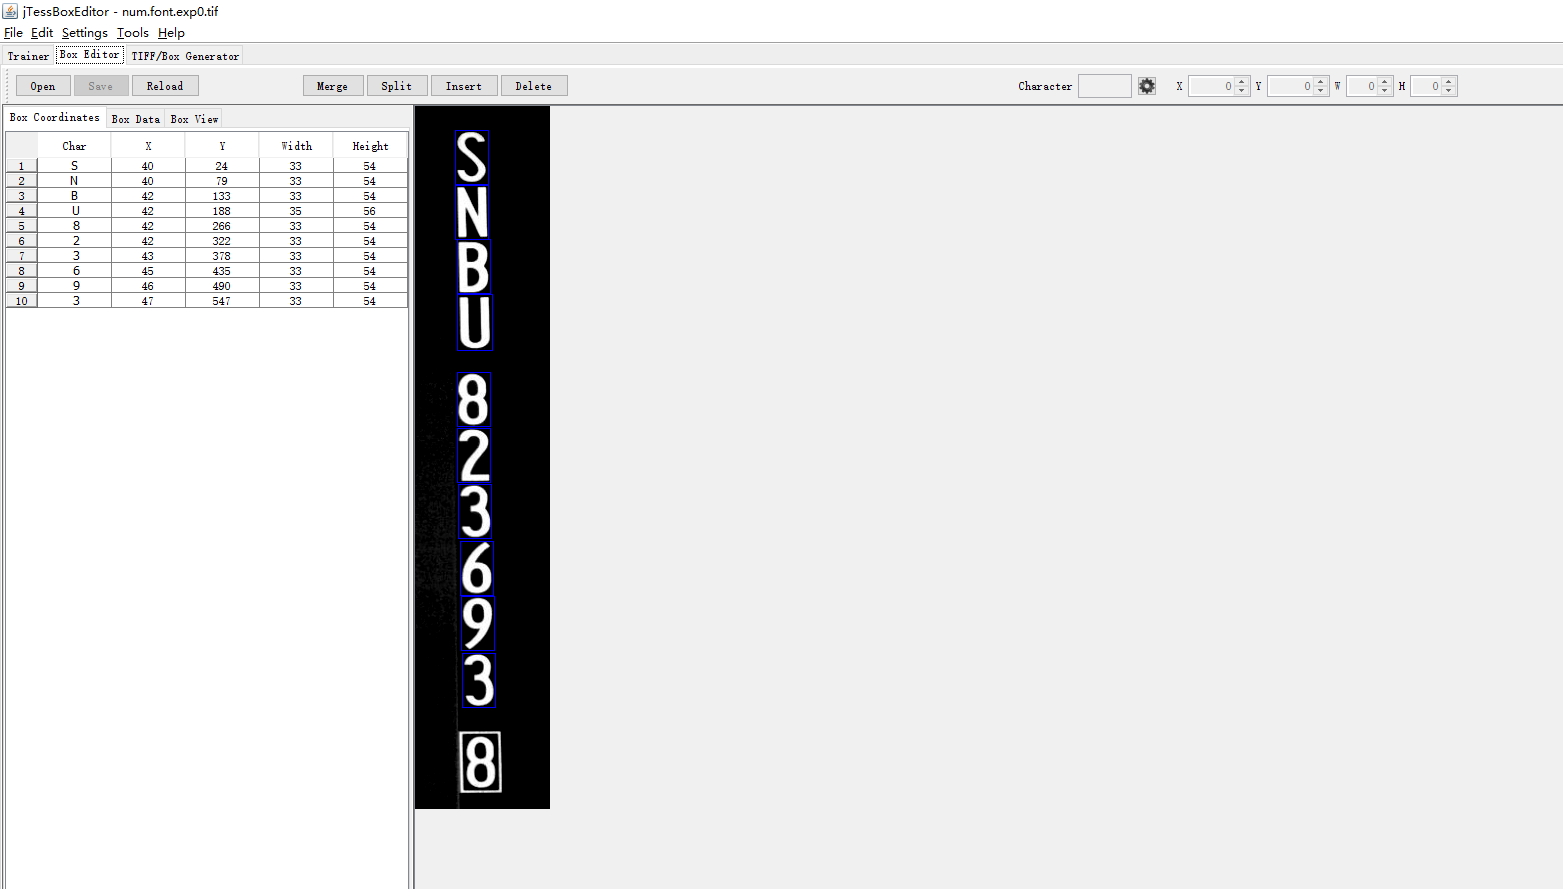
这我的demo的一张图。
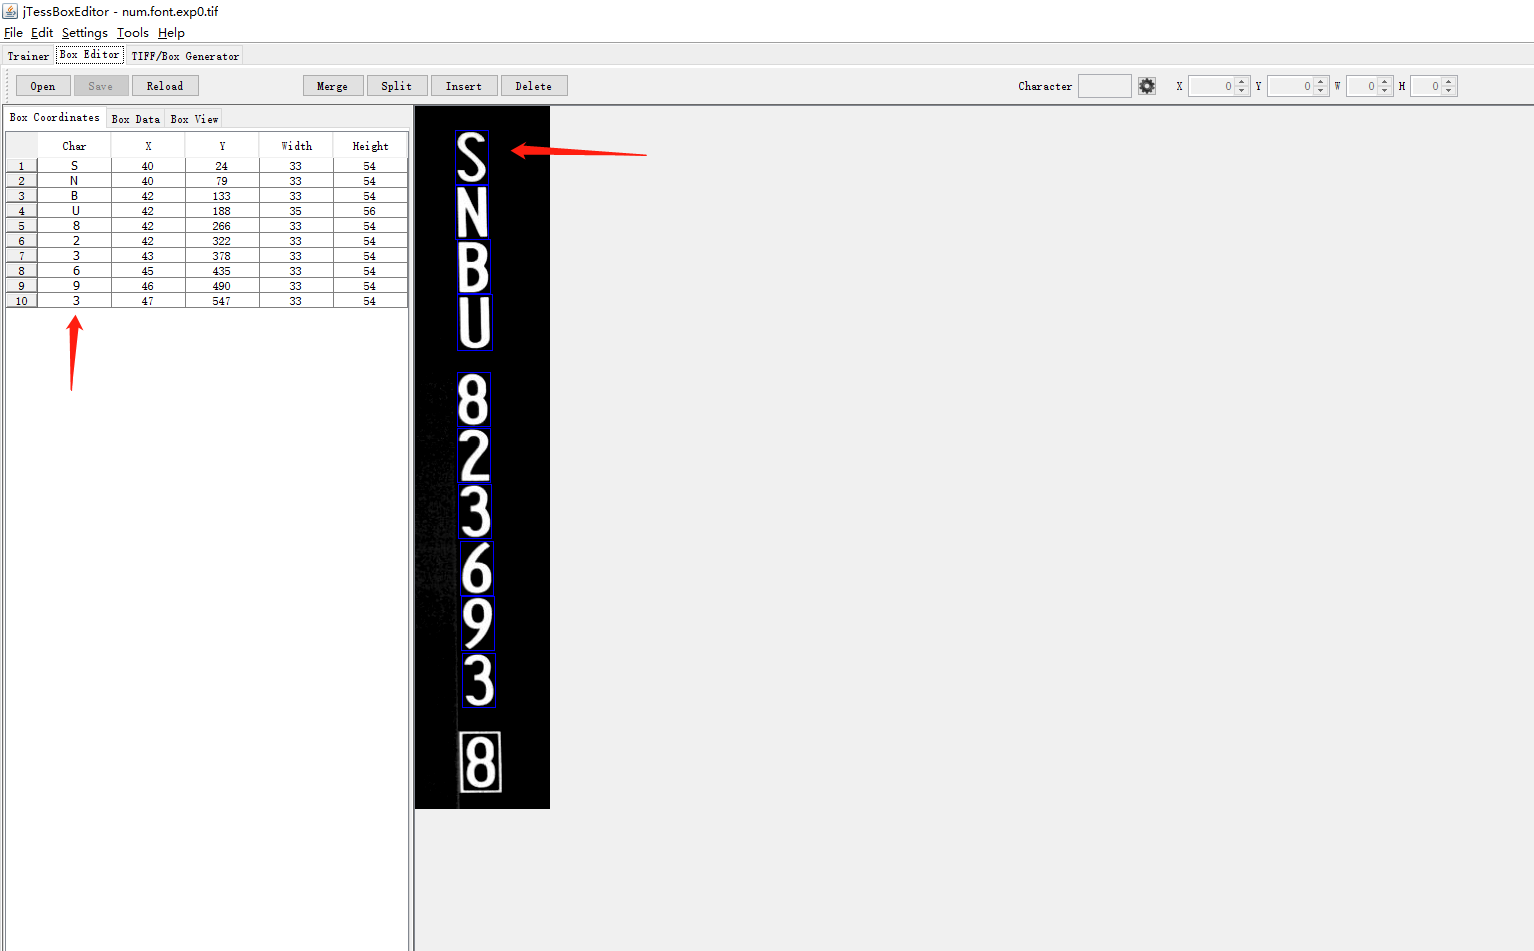
每一个char都要和左边的图相对应。如果不对应就一一修改,建议大家把这上面的所有的操作按钮都熟悉下再使用,其实很简单。
修改完以后点击save保存。
定义字体特征文件。创建一个名称为font_properties的字体特征文件。font_properties不含有BOM头,文件内容格式如下:
<fontname> <italic> <bold> <fixed> <serif> <fraktur>
其中fontname为字体名称,必须与[lang].[fontname].exp[num].box中的名称保持一致。<italic> 、<bold> 、<fixed> 、<serif>、 <fraktur>的取值为1或0,表示字体是否具有这些属性。
这里在样本图片所在目录下创建一个名称为font_properties的文件,用记事本打开,输入以下下内容:
font 0 0 0 0 0
这里全取值为0,表示字体不是粗体、斜体等等。
简单的说就是在tesseract的目录下新建一个font_properties,txt,然后写内容: font 0 0 0 0 0
将下面命令保存成一个批处理的bat文件,放在tesseract的目录下,双击执行。
echo Run Tesseract for Training..
tesseract.exe num.font.exp0.tif num.font.exp0 nobatch box.train
echo Compute the Character Set..
unicharset_extractor.exe num.font.exp0.box
mftraining -F font_properties.txt -U unicharset -O num.unicharset num.font.exp0.tr
echo Clustering..
cntraining.exe num.font.exp0.tr
echo Rename Files..
rename normproto num.normproto
rename inttemp num.inttemp
rename pffmtable num.pffmtable
rename shapetable num.shapetable
echo Create Tessdata..
combine_tessdata.exe num.
pause
命令窗口会有一些错误,请看错误的解决办法:
传送门:https://www.cnblogs.com/132818Creator/p/11811841.html
something from:https://blog.csdn.net/sylsjane/article/details/83751297
tesseract系列(3) -- tesseract训练的更多相关文章
- Tesseract 3.02中文字库训练
Tesseract 3.02中文字库训练 下载chi_sim.traindata字库下载tesseract-ocr-setup-3.02.02.exe 下载jTessBoxEditor用于修改box文 ...
- Caffe学习系列(12):训练和测试自己的图片--linux平台
Caffe学习系列(12):训练和测试自己的图片 学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测 ...
- tesseract系列(4) -- tesseract训练问题总结
1. 每次训练模型删除目录下,上述重复的名字 2. 生成inttemp.pffmtable文件的时候,如果下述命令(1)不行的话,或者报错,使用命令(2) (1)mftraining -F font_ ...
- [转]Tesseract 3.02中文字库训练
下载chi_sim.traindata字库下载tesseract-ocr-setup-3.02.02.exe 下载地址:http://code.google.com/p/tesseract-ocr/d ...
- tesseract 中文二次训练
tesseract4.0以上版本可参考 https://github.com/tesseract-ocr/tesseract/wiki/TrainingTesseract-4.00#tutorial- ...
- tesseract系列(2) -- tesseract的使用
上文说了怎么编译成库,这次说说怎么使用,先验证下编译出来的结果. 下图是debug生成的文件,里面有个tesseract的应用程序. cmd进入目录下,执行命令:tesseract eurotext. ...
- tesseract系列(1) -- tesseract用vs编译成库
1.下载teseract 下载地址github: https://github.com/tesseract-ocr/tesseract/releases/ 2.编译源码 源码的编译有两种方式 ...
- Caffe学习系列(12):训练和测试自己的图片
学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测试模型的整个流程. 一.准备数据 有条件的同学,可以去 ...
- 转 Caffe学习系列(12):训练和测试自己的图片
学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测试模型的整个流程. 一.准备数据 有条件的同学,可以去 ...
随机推荐
- 用tensorflow求手写数字的识别准确率 (简单版)
import tensorflow as tf from tensorflow.examples.tutorials.mnist import input_data #载入数据集 mnist = in ...
- 备份mysql的批处理命令
需要工具mysqldump.exe的支持,安装mysql默认是带此工具的 批处理命令 set NOW_TIME_HH=%time:~0,2% if "%NOW_TIME_HH%" ...
- 调用约定__stdcall / __cdecl
__cdecl与__stdcall这两种调用约定之间的主要差别在于由谁来执行对参数的清理工作. 如果是__cdecl,那么主调函数将负责执行清理工作,如果是__stdcall那被调函数将负责执行清理. ...
- java 的二分算法
二分算法 就是在 一组 有序 数组中 通过中间值(数组中间的那个数字)的方法 找到 某个数的下标,如果大于中间值 ,则在中间值与最大值之间 的中间值再比较. public class two { // ...
- kill -HUP 什么意思?
参考 74.在DNS系统测试时,设named进程号是53,命令 D 通知进程重读配置文件.A kill –USR2 53 B kill –USR1 53 C kill -INT 63 D kill – ...
- aliyun服务器lamp配置
1.安装Apache:yum install httpd 2.安装php: yum install php 3.安装mysql客户端:yum install mysql 4.安装mysql服务端:yu ...
- POJ 1185 状态DP
这个题目是个挺难表示的状态DP,因为不但要考虑上下还要考虑左右,在DP里面就没有什么下了咯,但也至少除了考虑左右还要考虑上 所以先枚举出在同一行满足条件的状态 即 某状态 若 s&(s< ...
- UVALive 3942 字典树+dp
其实主要是想学一下字典树的写法,但这个题目又涉及到了DP:这个题目要求某些单词组成一个长子串的各种组合总数,数据量大,单纯枚举复杂度高,首先肯定是要把各个单词给建成字典树,但是之后该怎么推一时没想到. ...
- HGP|VCG|UK10K|中科院职业人群队列研究计划|药物基因组学
全球性计划:表观组计划:肝计划 测1000人的变异level HGP计划三个阶段,范围逐步扩大和深化. Pilot:deep sequence---low coverage Phase 1 Phase ...
- python pandas写入excel文件
pandas读取.写入csv数据非常方便,但是有时希望通过excel画个简单的图表看一下数据质量.变化趋势并保存,这时候csv格式的数据就略显不便,因此尝试直接将数据写入excel文件. pandas ...