
深度学习 | sklearn的train_test_split()各函数参数含义解释(超级全)
在机器学习中,我们通常将原始数据按照比例分割为“测试集”和“训练集”,从 sklearn.model_selection 中调用train_test_split 函数
简单用法如下:
X_train,X_test, y_train, y_test =sklearn.model_selection.train_test_split(train_data,train_target,test_size=0.4, random_state=0,stratify=y_train)
train_data:所要划分的样本特征集
train_target:所要划分的样本结果
test_size:样本占比,如果是整数的话就是样本的数量
random_state:是随机数的种子。
- 随机数种子:其实就是该组随机数的编号,在需要重复试验的时候,保证得到一组一样的随机数。比如你每次都填1,其他参数一样的情况下你得到的随机数组是一样的。但填0或不填,每次都会不一样。
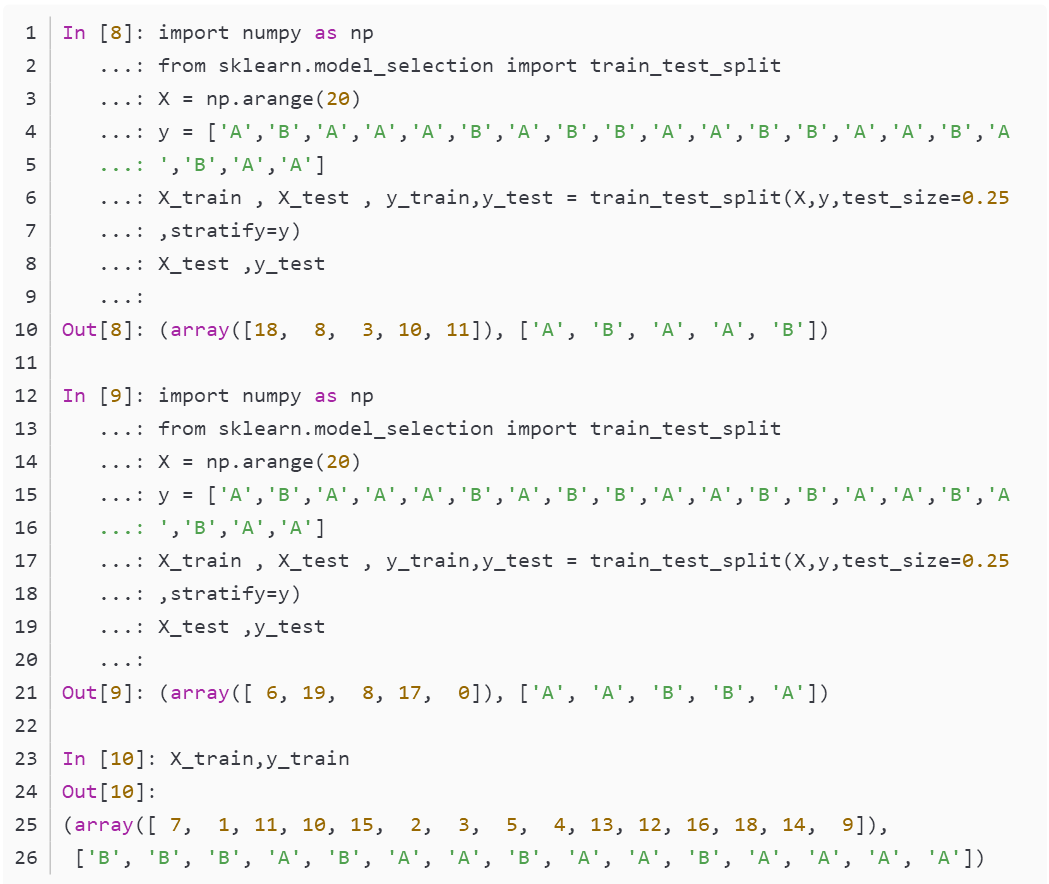
stratify是为了保持split前类的分布。比如有100个数据,80个属于A类,20个属于B类。如果train_test_split(... test_size=0.25, stratify = y_all), 那么split之后数据如下:
training: 75个数据,其中60个属于A类,15个属于B类。
testing: 25个数据,其中20个属于A类,5个属于B类。
用了stratify参数,training集和testing集的类的比例是 A:B= 4:1,等同于split前的比例(80:20)。通常在这种类分布不平衡的情况下会用到stratify。
将stratify=X就是按照X中的比例分配
将stratify=y就是按照y中的比例分配
整体总结起来各个参数的设置及其类型如下:
主要参数说明:
*arrays:可以是列表、numpy数组、scipy稀疏矩阵或pandas的数据框
test_size:可以为浮点、整数或None,默认为None
①若为浮点时,表示测试集占总样本的百分比
②若为整数时,表示测试样本样本数
③若为None时,test size自动设置成0.25
train_size:可以为浮点、整数或None,默认为None
①若为浮点时,表示训练集占总样本的百分比
②若为整数时,表示训练样本的样本数
③若为None时,train_size自动被设置成0.75
random_state:可以为整数、RandomState实例或None,默认为None
①若为None时,每次生成的数据都是随机,可能不一样
②若为整数时,每次生成的数据都相同
stratify:可以为类似数组或None
①若为None时,划分出来的测试集或训练集中,其类标签的比例也是随机的
②若不为None时,划分出来的测试集或训练集中,其类标签的比例同输入的数组中类标签的比例相同,可以用于处理不均衡的数据集
通过简单栗子看看各个参数的作用:
举例如下:
通过简单例子看看各个参数的作用:
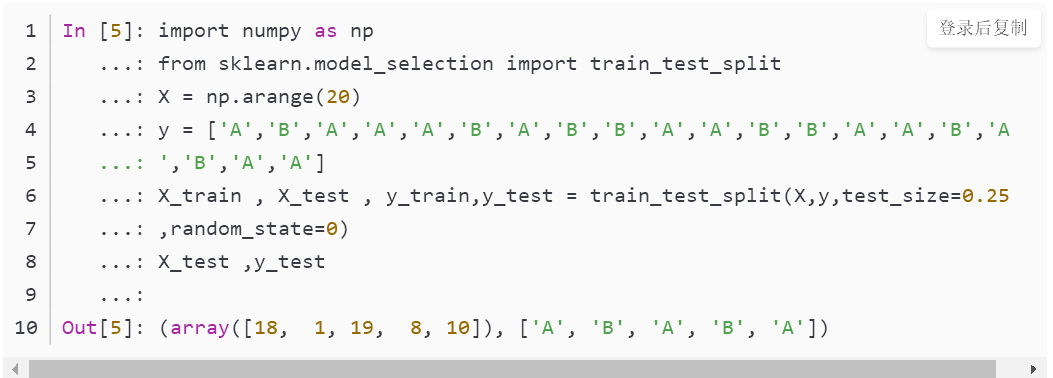
①test_size决定划分测试、训练集比例

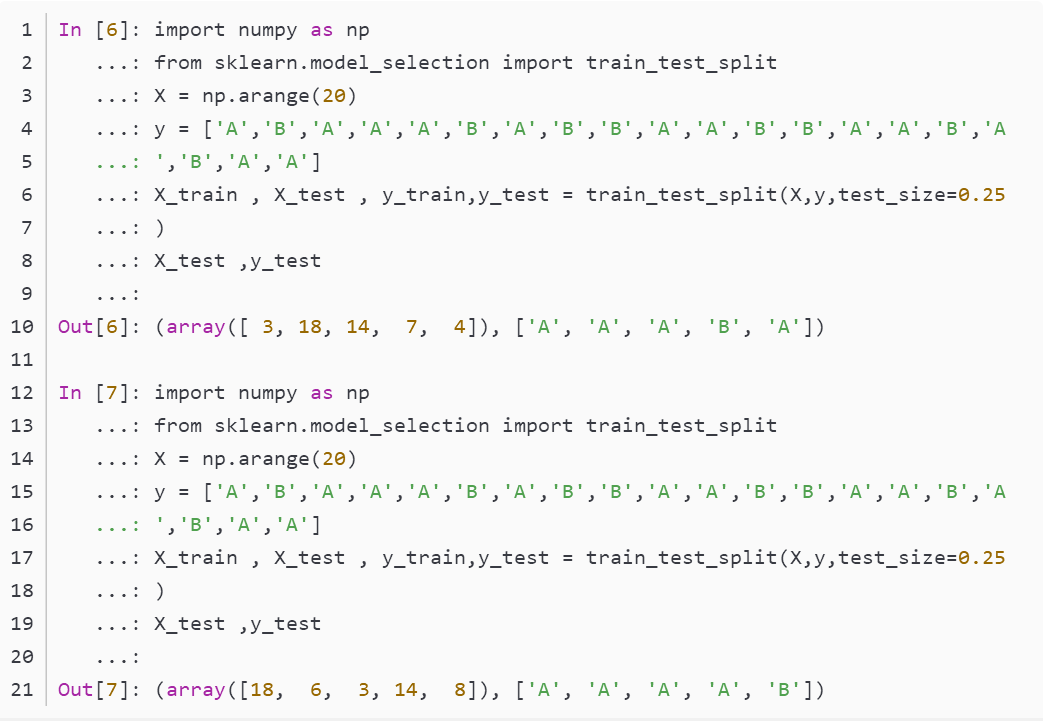
②random_state不同值获取到不同的数据集
设置random_state=0再运行一次,结果同上述相同
设置random_state=None运行两次,发现两次的结果不同
③设置stratify参数,可以处理数据不平衡问题
深度学习 | sklearn的train_test_split()各函数参数含义解释(超级全)的更多相关文章
- sklearn的train_test_split()各函数参数含义解释(非常全)
sklearn之train_test_split()函数各参数含义(非常全) 在机器学习中,我们通常将原始数据按照比例分割为“测试集”和“训练集”,从 sklearn.model_selection ...
- 深度学习Keras框架笔记之Dense类(标准的一维全连接层)
深度学习Keras框架笔记之Dense类(标准的一维全连接层) 例: keras.layers.core.Dense(output_dim,init='glorot_uniform', activat ...
- Python学习札记(十二) Function3 函数参数一
参考:函数参数 Note 1.Python的函数定义非常简单,但灵活度却非常大.除了正常定义的必选参数外,还可以使用默认参数.可变参数和关键字参数,使得函数定义出来的接口,不但能处理复杂的参数,还可以 ...
- python学习二十四天函数参数之默认参数
函数参数就是向函数传递参数,可以传递一个,可以是更多个,有的参数有值,有的没有,函数可以设置默认参数,默认参数必须放参数最后面. 1,不传递参数,设置默认参数 def hello(a,b,c='123 ...
- 深度学习中 epoch,[batch size], iterations概念解释
one epoch:所有的训练样本完成一次Forword运算以及一次BP运算 batch size:一次Forword运算以及BP运算中所需要的训练样本数目,其实深度学习每一次参数的更新所需要损失函数 ...
- 深度学习(四) softmax函数
softmax函数 softmax用于多分类过程中,它将多个神经元的输出,映射到(0,1)区间内,可以看成概率来理解,从而来进行多分类! 假设我们有一个数组,V,Vi表示V中的第i个元素,那么这个元素 ...
- Angularjs中link函数参数含义小节
restrictE: 表示该directive仅能以element方式使用,即:<my-dialog></my-dialog>A: 表示该directive仅能以attribu ...
- 调参侠的末日? Auto-Keras 自动搜索深度学习模型的网络架构和超参数
Auto-Keras 是一个开源的自动机器学习库.Auto-Keras 的终极目标是允许所有领域的只需要很少的数据科学或者机器学习背景的专家都可以很容易的使用深度学习.Auto-Keras 提供了一系 ...
- 医学图像 | 使用深度学习实现乳腺癌分类(附python演练)
乳腺癌是全球第二常见的女性癌症.2012年,它占所有新癌症病例的12%,占所有女性癌症病例的25%. 当乳腺细胞生长失控时,乳腺癌就开始了.这些细胞通常形成一个肿瘤,通常可以在x光片上直接看到或感觉到 ...
随机推荐
- Vuex里的module选项和移动端布局
Vuex里的modules 在store文件夹里创建一个modules的文件夹,里面随意创建一个.js文件,然后export输出
- Android Studio(Kotlin)之RecyclerView
RecyclerView应该是ListView的增强版. RecyclerView与ListView的区别(我认为的): RecyclerView的性能比ListView高 RecyclerView支 ...
- mysql查看各表占磁盘空间
select TABLE_NAME, concat(truncate(data_length/1024/1024,2),' MB') as data_size, concat(truncate(ind ...
- 任务调度中心xxl-job对外接口使用
xxl-job主要分为调度中心和执行器提供了图像化界面,操作简单上手快,基本实现定时任务自动执行,同时可以针对任务日志进行查看.具体xxl-job可以再github上下载:https://github ...
- BUUCTF-Web Comment
dirsearch扫出/.git/目录 遂用航神写的Githacker脚本 https://github.com/wangyihang/githacker 出来的源码并不完整,使用git log ...
- Learning in the Frequency Domain 解读
论文:Learning in the Frequency Domain, CVPR 2020 代码:https://github.com/calmevtime/DCTNet 实际的图像尺寸比较大,无法 ...
- 第三章 Java面向对象(上)
3.1.概述 概述:面向对象是相对面向过程而言,面向对象和面向过程都是一种思想,面向过程强调的是功能行为,面向对象则是将功能封装进对象,强调具备功能的对象,面向对象是基于面向过程的.面向对象的三大特征 ...
- Intellij IDEA 快速查找接口实现类的快捷键
查找接口的实现类: IDEA 风格 ctrl + alt +B 在按F2查看详细文档注解 查看类或接口的继承关系: ctrl + h
- 线程_gevent实现多个视频下载及并发下载
from gevent import monkey import gevent import urllib.request #有IO操作时,使用patch_all自动切换 monkey.patch_a ...
- Python time tzset()方法
描述 Python time tzset() 根据环境变量TZ重新初始化时间相关设置.高佣联盟 www.cgewang.com 标准TZ环境变量格式: std offset [dst [offset ...