
爬虫——使用BeautifulSoup4的爬虫
我们以腾讯社招页面来做示例:http://hr.tencent.com/position.php?&start=0#a
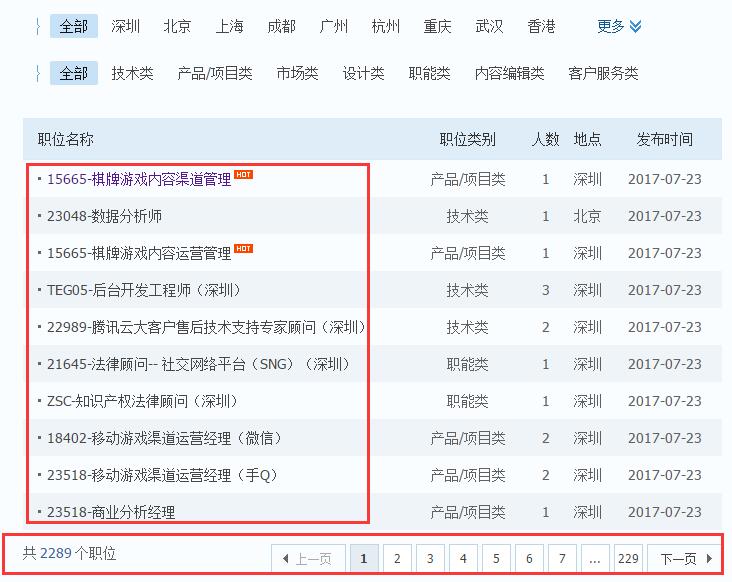
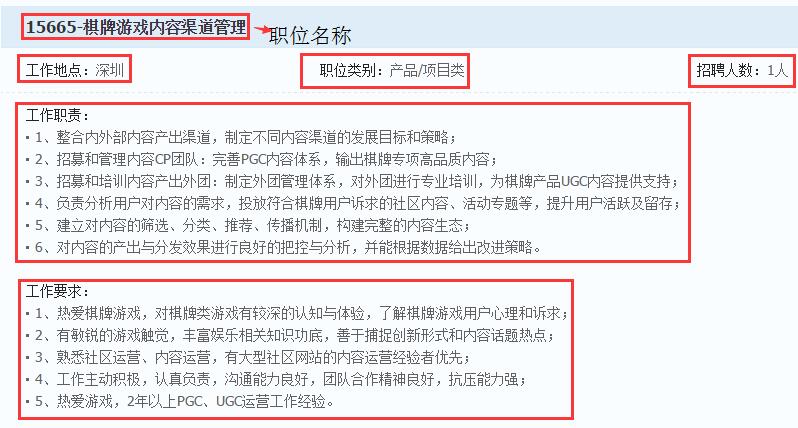
如上图,使用BeautifulSoup4解析器,将图1中229页,每页10个招聘信息,共2289个招聘信息中的职位名称、职位类别、招聘人数、工作地点、工作职责、工作要求、详情链接等信息存储在本地磁盘(如下图)。
#!/usr/bin/python3

# -*- coding:utf-8 -*-

__author__ = 'mayi'

"""

案例:使用BeautifulSoup4爬取腾讯招聘页面的数据

url:http://hr.tencent.com/position.php?&start=10#a

使用BeautifulSoup4解析器,爬取每个招聘详情页面里面的:

职位名称、工作地点、职位类别、招聘人数、工作职责、工作要求、url链接

"""

from bs4 import BeautifulSoup

import urllib.request

import json

# 创建一个爬虫类

class TencentSpider(object):

    """

    一个爬虫类:爬取腾讯招聘页面信息

    """

    def __init__(self):

        """

        初始化函数

        :return:

        """

        # User-Agent头

        self.header = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71 Safari/537.36'}

        self.url = "http://hr.tencent.com/"

        self.file_name = open("tencent.txt", "w", encoding = "utf-8")

        # 爬虫开始工作

        self.run()

    def run(self):

        """

        爬虫开始工作

        :return:

        """

        # 首页

        start_page = 1

        # 尾页

        end_page = self.getLastPage(self.url + "position.php?&start=0#a")

        # 循环处理每一页

        for page in range(start_page, end_page + 1):

            print("正在处理第" + str(page) + "页")

            # 每一页有10个招聘信息

            pn = (page - 1) * 10

            # 接接成完整的url地址

            full_url = self.url + "position.php?&start=" + str(pn) + "#a"

            # 获取招聘详情链接:l square

            link_list = self.getPositons(full_url)

            for link in link_list:

                # 拼接成完整的链接

                full_link = self.url + link

                # 获取招聘信息页面里的所需爬取的信息

                self.getPositionInfo(full_link)

        # 关闭文件

        self.file_name.close()

    def getLastPage(self, url):

        """

        获取尾页的page值

        :param url: 首页的url地址

        :return: 尾页的page值

        """

        # 获取url页面的内容:bytes

        html = self.loadPage(url)

        # bytes转utf-8

        html = html.decode("utf-8")

        # 创建 Beautiful Soup 对象,指定lxml解析器

        soup = BeautifulSoup(html, "lxml")

        page_nav = soup.select('div[class="pagenav"]')[0]

        page = page_nav.find_all('a')[-2].get_text()

        return int(page)

    def loadPage(self, url):

        """

        获取url页面的内容

        :param url: 需要获取内容的url地址

        :return: url页面的内容

        """

        # url 连同 headers,一起构造Request请求,这个请求将附带 chrome 浏览器的User-Agent

        request = urllib.request.Request(url, headers = self.header)

        # 向服务器发送这个请求

        response = urllib.request.urlopen(request)

        # time.sleep(3)

        # 获取网页内容:bytes

        html = response.read()

        return html

    def getPositons(self, url):

        """

        获取url页面内的招聘详情链接

        :param url:

        :return:

        """

        # 获取url页面的内容:bytes

        html = self.loadPage(url)

        # bytes转utf-8

        html = html.decode("utf-8")

        # 创建 Beautiful Soup 对象,指定lxml解析器

        soup = BeautifulSoup(html, "lxml")

        item_list = soup.select('td[class="l square"]')

        link_list = []

        for item in item_list:

            item = item.select('a')[0].attrs['href']

            link_list.append(item)

        return link_list

    def getPositionInfo(self, url):

        """

        获取我们需爬取的信息

        :param url: 招聘详情页面

        :return: None

        """

        # 获取url页面的内容:bytes

        html = self.loadPage(url)

        # bytes转utf-8

        html = html.decode("utf-8")

        # 创建 Beautiful Soup 对象,指定lxml解析器

        soup = BeautifulSoup(html, "lxml")

        # 用于存储所爬取信息的字典

        item = {}

        try:

            # 职位名称

            position_name = soup.find_all(id="sharetitle")[0].get_text()

            # 工作地点、职位类型、招聘人数

            bottomline = soup.select('tr[class="c bottomline"] td')

            # 工作地点

            working_place = bottomline[0].get_text()[5:]

            # 职位类别

            position_category = bottomline[1].get_text()[5:]

            # 招聘人数

            numbers = bottomline[2].get_text()[5:]

            # 工作职责

            operating_duty_list = soup.select('ul[class="squareli"]')[0].select('li')

            operating_duty = ""

            for duty in operating_duty_list:

                operating_duty += duty.get_text().strip() + "\n"

            # 工作要求

            requirements_list = soup.select('ul[class="squareli"]')[1].select('li')

            requirements = ""

            for requ in requirements_list:

                requirements += requ.get_text().strip() + "\n"

            # url链接

            url_links = url

            # 职位名称、工作地点、职位类别、招聘人数、工作职责、工作要求、url链接

            item["职位名称"] = position_name

            item["工作地点"] = working_place

            item["职位类别"] = position_category

            item["招聘人数"] = numbers

            item["工作职责"] = operating_duty

            item["工作要求"] = requirements

            item["url链接"] = url_links

        except:

            # 若异常、则舍弃这条信息

            pass

        # 保存这条记录

        if item:

            line = json.dumps(item, ensure_ascii = False) + "\n"

            self.file_name.write(line)

# 主函数

if __name__ == '__main__':

    my_spider = TencentSpider()
爬虫——使用BeautifulSoup4的爬虫的更多相关文章
- python3.4学习笔记(十七) 网络爬虫使用Beautifulsoup4抓取内容
python3.4学习笔记(十七) 网络爬虫使用Beautifulsoup4抓取内容 Beautiful Soup 是用Python写的一个HTML/XML的解析器,它可以很好的处理不规范标记并生成剖 ...
- Python 爬虫3——第一个爬虫脚本的创建
在进行真正的爬虫工程创建之前,我们先要明确我们所要操作的对象是什么?完成所有操作之后要获取到的数据或信息是什么? 首先是第一个问题:操作对象,爬虫全称是网络爬虫,顾名思义,它所操作的对象当然就是网页, ...
- 放养的小爬虫--豆瓣电影入门级爬虫(mongodb使用教程~)
放养的小爬虫--豆瓣电影入门级爬虫(mongodb使用教程~) 笔者声明:只用于学习交流,不用于其他途径.源代码已上传github.githu地址:https://github.com/Erma-Wa ...
- 爬虫(Spider),反爬虫(Anti-Spider),反反爬虫(Anti-Anti-Spider)
爬虫(Spider),反爬虫(Anti-Spider),反反爬虫(Anti-Anti-Spider),这之间的斗争恢宏壮阔... Day 1小莫想要某站上所有的电影,写了标准的爬虫(基于HttpCli ...
- Python爬虫与数据分析之爬虫技能:urlib库、xpath选择器、正则表达式
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
- python3编写网络爬虫23-分布式爬虫
一.分布式爬虫 前面我们了解Scrapy爬虫框架的基本用法 这些框架都是在同一台主机运行的 爬取效率有限 如果多台主机协同爬取 爬取效率必然成倍增长这就是分布式爬虫的优势 1. 分布式爬虫基本原理 1 ...
- python爬虫随笔(2)—启动爬虫与xpath
启动爬虫 在上一节中,我们已经创建好了我们的scrapy项目,看着这一大堆文件,想必很多人都会一脸懵逼,我们应该怎么启动这个爬虫呢? 既然我们采用cmd命令创建了scrapy爬虫,那就得有始有终有逼格 ...
- 【网络爬虫入门03】爬虫解析利器beautifulSoup模块的基本应用
[网络爬虫入门03]爬虫解析利器beautifulSoup模块的基本应用 1.引言 网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率.B ...
- python爬虫-基础入门-python爬虫突破封锁
python爬虫-基础入门-python爬虫突破封锁 >> 相关概念 >> request概念:是从客户端向服务器发出请求,包括用户提交的信息及客户端的一些信息.客户端可通过H ...
随机推荐
- rest-framework框架——认证、权限、频率组件
一.rest-framework登录验证 1.models.py添加User和Token模型 class User(models.Model): name = models.CharField(max ...
- html5 填表 表单 input output 与表单验证
1.<output> Js计算结果 <form oninput="res.value = num1.valueAsNumber*num2.valueAsNumber ...
- JavaScript中文拼音排序函数
要对很多设备根据名称排序,找了找没有找到特别适合的,然后就自己写了一个根据中文拼音首字母排序的方法. github: https://github.com/haboll/sort.git
- 一次完整的HTTP事务过程
基本流程: a. 域名解析 b. 发起TCP的3次握手 c. 建立TCP连接后发起http请求 d. 服务器端响应http请求,浏览器得到html代码 e. 浏览器解析html代码,并请求html代码 ...
- Python——追加学习笔记(四)
函数 1.python里的函数可以返回一个值或者对象,知识在返回一个容器对象的时候有点不同,看起来像是能返回多个对象. >>> def bar(): ... return 'abc' ...
- JSP中include动作与指令
include指令 JSP中有三大指令:page,include,taglib,之前已经说过了page的用法.这里介绍下include. 使用语法如下: <%@ include file=&qu ...
- Jmeter入门9 __digest函数 jmeter字符串连接与登录串加密应用
登录请求中加密串是由多个子串连接,再加密之后传输. 参数连接:${var1}${var2}${var3} 加密函数:__digest (函数助手里如果没有该函数,请下载最新版本的jmeter5 ...
- datatable 动态显示/隐藏列
这个例子演示了 column().visible()方法来隐藏显示列,通过点击列按钮动态切换 <table id="example" class="display& ...
- bzoj2004 [Hnoi2010]公交线路
Description 小Z所在的城市有N个公交车站,排列在一条长(N-1)km的直线上,从左到右依次编号为1到N,相邻公交车站间的距 离均为1km. 作为公交车线路的规划者,小Z调查了市民的需求,决 ...
- lua 语句学习
就如同C里的if else,while,do,repeat.就看lua里怎么用: 1.首先看if else t = {1,2,3} local i = 1 if t[i] and t[i] % 2 = ...